A Study on the Differences in the Impact of Large Language Model-Assisted Verification on the Authenticity Discrimination of User Information

  • Li Wangxu ,
  • Xia Zhijie
Expand
  • School of Management, Shanghai University of Engineering Science, Shanghai 201620
Xia Zhijie, PhD, Professor, Doctoral Supervisor, Corresponding Author, E-mail:.

Li Wangxu Master's Candidate; Xia Zhijie, PhD, Professor, Doctoral Supervisor.

Received date: 2025-12-14

  Online published: 2026-05-25

Supported by

General Project of the National Social Science Fund of China titled "Research on the Mechanism and Operation Strategy of Smart Governance of Online Rumors Supported by Big Data"(21BGL243)

Abstract

[Purpose/Significance] This study focuses on the application effect of large language models in the field of fact-checking, aiming to systematically explore their impact on users' ability to distinguish the authenticity of information and examine the moderating effect of demographic variables, providing empirical support for social platforms to combat false information. [Method/Process] This study used health-related information as the specific context and experimental material, adopting an inter-group control experiment design based on the dual-process theory. A total of 142 participants were recruited, and an experimental group using LLM for fact-checking and a control group relying on their own knowledge for judgment were established. Through one-way ANOVA and moderation effect analysis, the impact of LLM on users' ability to distinguish the authenticity of information and the moderating effects of gender, age, and education level were explored. [Result/Conclusion] LLM-assisted fact-checking significantly improves users' ability to distinguish the authenticity of information, with a significant increase in the accuracy of identifying false information, but the improvement in the accuracy of identifying true information does not reach a significant level. Further analysis indicates that users with lower educational attainment show a more pronounced improvement in their ability to distinguish the authenticity of information when assisted by LLMs in fact-checking, while gender and age variables do not exhibit significant moderating effects.
Cite this article

Li Wangxu , Xia Zhijie . A Study on the Differences in the Impact of Large Language Model-Assisted Verification on the Authenticity Discrimination of User Information[J]. Knowledge Management Forum, 2026 , 11(3) : 233 -242 . DOI: 10.13266/j.issn.2095-5472.2026.020

社交平台的开放性和信息传播的高效性在重塑信息获取模式的同时,也为虚假信息的滋生提供了温床。虚假信息依靠其语义的模糊性和情感的煽动性,不仅加剧了公众的认知偏差,还对公共政策制定、社会信任构建构成了严重威胁。因此,有效防范虚假信息已成为维护健康社交平台的迫切需求。
事实核查(fact-checking)作为干预虚假信息的重要手段,能够有效降低个体对虚假信息的信任度[1]。但其受限于核查成本高、覆盖范围有限以及存在持续影响效应等局限,难以满足社交平台上虚假信息爆发式增长的治理需求[2]。自动化核查技术的出现,在一定程度上提升了核查效率,然而在处理复杂语境下的语义模糊问题时暴露出明显的适应性不足与泛化能力的短板[3]。当前,大语言模型(large language model,LLM)的出现为社交平台上的事实核查带来革命性突破。以ChatGPT为代表的LLM在推理任务方面展现了优异的零样本学习能力。同时其在情感分类、命名实体识别等任务中能够有效捕捉文本的深层情感特征,并提升分类精度,显著提高情感分类任务的准确性[4]。但现有研究多聚焦于模型技术的优化,缺乏对LLM辅助核查与用户认知交互机制的系统探究,尤其忽视了个体差异对核查效果的潜在影响。因此,在将其投入实际应用之前,有必要对其干预虚假信息的效果进行科学评估。
基于此,本文通过一项对照实验,以国内前沿的大语言模型DeepSeek为例,系统评估使用LLM辅助事实核查对用户信息真伪甄别效果的影响,并引入人口统计学变量以揭示个体差异对LLM核查效果的调节效应,旨在优化事实核查机制,为社交平台打击虚假信息提供新思路。

1 相关研究/ Relevant research

1.1 虚假信息的事实核查

事实核查是指对信息、声明或新闻报道进行验证,以确认其准确性和真实性的过程。为了及时纠正并缓解虚假信息的影响,事实核查逐渐成为学界关注的重要研究方向之一。当前研究主要围绕以下方向展开系统性探索。
首先,在运行模式上,孟健等[5]以澎湃明查和全民较真等国内的案例作为基础,梳理出使用众包模式核查在线新闻的运行逻辑,认为该模式能够有效弥补专业资源方面的不足、扩大核查的覆盖面积,进一步推动新闻生产的社会共建。李瑾颉等[6]则探讨了来源可信度与众包事实核查在社交平台中对用户信息参与行为的影响,指出描述性社会规范能有效提高用户的参与行为,且来源可信度越高,核查信息对用户行为的影响越大。
其次,在干预效果层面,王智超等[7]从用户行为角度出发,分析了社交平台上虚假信息传播的心理动因,并强调事实核查作为信息干预的手段,在限制误导性内容的扩散方面具有积极作用。K. Clayton等[8]验证了事实核查标签对错误信念的纠正具有普适性,提示性警告也能在一定程度上抑制虚假信息的接受度和转发意愿。针对健康信息的场景,王孝盼等[9]探讨了先验性知识对信息可信度判断的调节机制,认为事实核查能够作为外部认知支持,降低用户在健康谣言面前的误信情况。
最后,在技术手段方面,张翔然等[10]提出融合解释学习的PromptWE事实核查模型,将自然语言提示与可解释性的机制相结合,实现了对文本主张与证据信息的自动比对,提升了核查任务的准确率和透明度。该类研究为事实核查与人工智能技术的融合提供了可行路径,也为未来基于大语言模型的自动化核查系统建设奠定了技术基础。

1.2 大语言模型在打击虚假信息中的应用

作为一种基于深度学习技术构建、专注于自然语言文本处理与生成的人工智能模型,大语言模型的崛起为信息生态治理带来了新的技术变革。随着生成式人工智能技术的迭代,虚假信息呈现出生成自动化、传播快速化、影响深远化等特征,传统的方法在面对突发事件时捕捉上下文信息时存在较大问题,无法有效处理复杂的语义关联,而大语言模型的出现正逐渐填补这些局限。近年来,学术界在使用LLM帮助打击虚假信息方面取得了显著进展,从检测技术创新、治理机制构建到技术风险与治理隐患等多个层面展开了系统性探索,形成以下研究脉络。
首先,在检测技术创新上LLM展现出卓越的语义理解与上下文建模能力,显著提升了虚假信息检测的准确性与效率。张欣等[11]系统梳理了基于LLM的虚假信息检测框架,指出LLM在文本生成、数据增强、证据抽取等各环节中都具有应用潜力。其中,基于GPT等模型构建的检测系统已在多个领域测试中表现出稳健性。K. Roumeliotis等[12]通过对比卷积神经网络(convolutional neural network, CNN)、基于变换器的双向编码器表示(bidirectional encoder representations from transformers, BERT)与生成式预训练变换器(generative pre-trained transformer, GPT)系列模型,发现微调后的GPT-4o在虚假新闻分类任务中准确率远远超过传统模型,显示出LLM在细腻的文本理解方面的强大优势。同时,融合多模态与外部知识也成为提升识别能力的重要路径。
其次,在治理机制构建方面,T. Tran等[13]借助活动理论提出了双交互系统框架,将虚假信息的生成与治理过程建模成为一个循环互动系统,强调在应急情境下构建以人为中心的AI协同治理机制,兼顾信息的时效性与可信度。何宇华等[14]则提出在面对生成式人工智能带来的打击虚假信息的挑战时,应该通过敏捷治理的新模式,打破传统的层级治理和二元治理的结构,强调通过多主体的高效协作、灵活响应以提升治理机制的适应性和实时性。
然而,尽管LLM在打击虚假信息中发挥着积极作用,但其也存在技术风险与治理隐患。祁凯等[15]进一步指出,LLM生成内容对负面舆情态势具有显著的牵引效应,尤其在突发事件中可能加剧情绪极化和公众不信任,因而需构建实时监测与干预机制,以规避其放大社会风险的可能性。S. B. Shah等[16]指出,LLM在生成自然语言的同时,也可能被滥用于生成高仿的虚假文本,加剧虚假信息传播。除此之外,模型自身的训练数据偏见、知识截止、幻觉等问题也可能导致事实扭曲,从而影响公共认知与社会稳定。
综上所述,现有研究主要集中于模型本身的优化与应用,较少关注LLM在事实核查过程中对信息真伪甄别效果的提升作用。因此,本研究试图解决以下两个核心问题:LLM进行事实核查能否提升用户的信息真伪甄别效果;人口统计学差异是否在LLM事实核查提升信息真伪甄别效果上起调节作用。本研究通过问卷调研收集数据,并使用SPSS软件进行分析,以期为LLM在打击虚假信息中的应用提供新的实证支撑,探索其在不同用户群体中的适用性。

2 理论基础与研究假设/Theoretical basis and research hypotheses

2.1 理论基础

双过程理论(dual process theory,DPT)提出,个体在执行判断与决策任务时,存在两种功能分化的信息加工系统,即启发式系统与分析式系统,二者共同构成人类认知活动的核心路径。启发式系统属于快速、无意识且低认知负荷的加工模式,其判断过程高度依赖个人情绪和整体感知,决策依据主要源于既往经验积累形成的认知,该系统的信息处理具有自动触发特性,易受相似情境与刻板印象的干扰,导致个体往往无法意识到加工过程,通常直接获取认知输出的结果。与之相对,分析式系统呈现慢速、连续性且高认知投入的特征,对信息的处理相对精细化,个体在此模式下会积极开展对论点的解析、细节的核验与逻辑方面的评估,能够更清晰地意识到信息自我加工的完整过程。
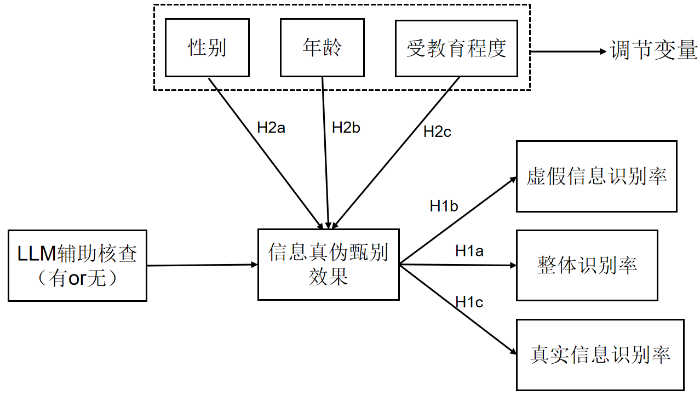
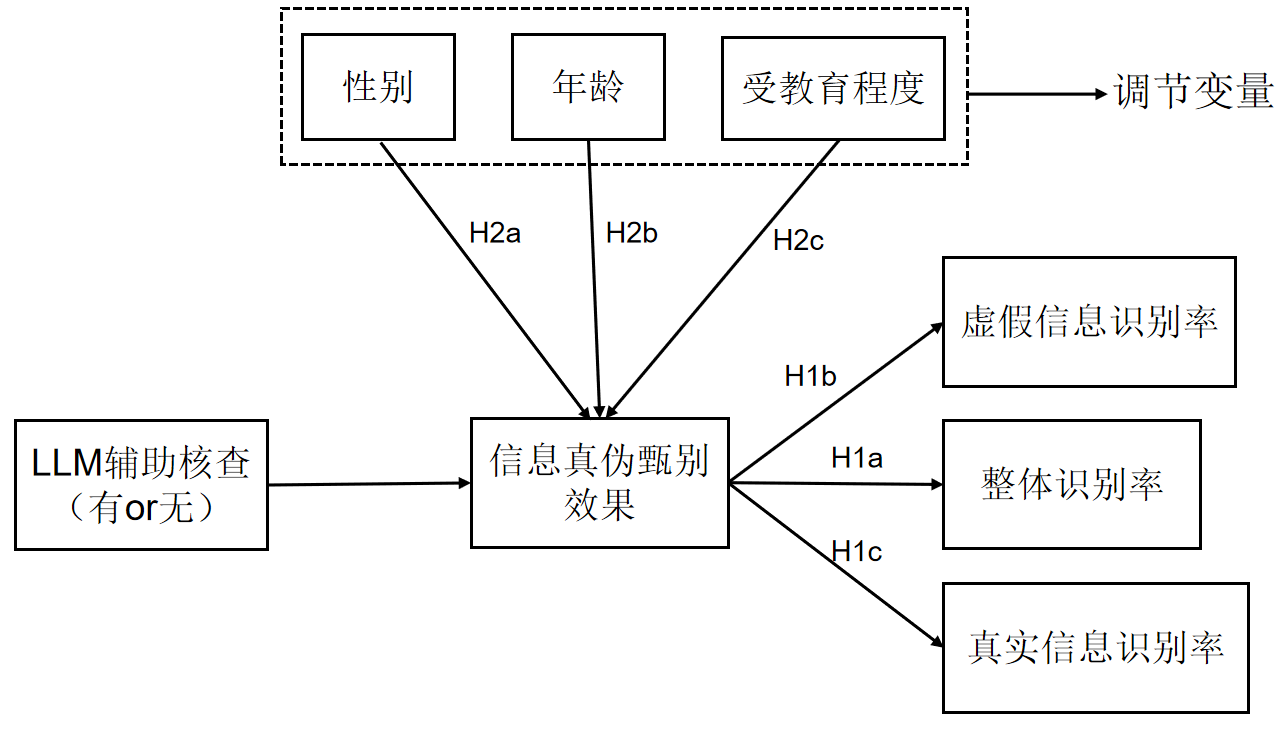
双过程理论常用于探究社交平台中的用户信息行为,启发式加工依赖快速捷径影响用户判断,而系统式加工则通过深入分析矫正认知偏差。K. Ali等[17]基于双过程理论,探究社交平台中的点赞数等启发式线索如何影响用户对假新闻的可信度判断,进而增加分享行为。在本研究中,启发式加工表现为用户在面对健康类信息时,不依靠LLM辅助事实核查,凭借个人经验和知识阅历判断信息的真实性;系统式加工则体现为用户引入LLM辅助事实核查后启动的认知路径,具体而言,LLM提供的证据支持与逻辑分析可引导用户突破先前经验的依赖,转向对信息内容的深度解析与逻辑评估,从而构建更严谨的信息判断认知过程。本文构建了如图1所示的研究框架模型。该模型以是否使用LLM辅助事实核查为自变量,以信息真伪甄别效果为因变量,并具体划分为整体识别率、虚假信息识别率与真实信息识别率3个观测维度。同时,模型纳入了性别、年龄、受教育程度3个人口统计学变量作为调节变量。
图1 研究框架模型

Figure 1 Research Framework Model

2.2 研究假设

2.2.1 LLM辅助事实核查与用户信息真伪甄别效果

当前大语言模型通过其强大的自然语言处理能力,在信息的自动生成与分析中展现出优越性。然而,尽管LLM在诸如文本摘要、信息检索等任务中表现出色,其在信息真伪识别和事实核查领域的应用仍面临诸多挑战,这也使得研究其在打击虚假信息中的作用显得尤为重要。LLM作为一个强有力的工具,能够通过分析大量信息提供快速且可靠的事实核查服务。通过事实核查LLM能够帮助用户辨别信息的真实性[18]。然而,LLM的输出并非总能完全准确地反映信息的真实性,有时也会出现误导性的回答[19]。这使得LLM在某些情境下的判断存在较大的局限性,探索提升LLM在事实核查中的有效性成为亟待解决的重要问题。基于上述研究论述,提出假设H1a。
H1a:使用LLM辅助事实核查能够提高用户的整体信息识别率。
虚假信息的传播往往更容易引发公众关注,尤其是当其涉及政治或健康等敏感议题时,用户对信息真实性的判断往往受到情感反应、先入为主的信念等因素的影响[20]。研究表明,LLM在虚假新闻判定中具有一定的优势,当LLM辅助事实核查时虚假新闻的识别准确率得到显著提高[21]。进一步地,LLM在虚假信息的处理过程中,不仅能够提高信息的真实性检测能力,还能帮助用户识别更加复杂的虚假新闻,从而增强其对虚假信息的防范能力。由此,本研究提出假设H1b。
H1b:使用LLM辅助事实核查能够提高用户的虚假信息识别准确率。
信息真伪的甄别效果不仅涉及虚假信息的识别,真实信息判断的准确度同样至关重要。虽然人们通常更容易信任真实信息,但在信息呈现的方式、语言的使用以及信息来源的影响下,真实信息的判别也可能受到干扰[22]。进一步研究表明,融合解释学习的事实核查模型通过结合自然语言提示与可解释性机制,可显著提升真实信息的识别率[10]。基于此,本研究提出假设H1c。
H1c:使用LLM辅助事实核查能够提高用户的真实信息识别准确率。

2.2.2 人口统计学变量的调节作用

在社交平台上应对虚假信息的实践中,个体差异是影响信息真伪甄别效果的重要因素。性别、年龄与受教育程度等人口统计学变量不仅直接关联个体的信息处理能力与认知偏好,还可能调节外部干预措施的实际效果。因此,探究这些变量在LLM辅助核查与信息真伪甄别效果关系中的调节作用,对于实现精准化、差异化的打击虚假信息策略具有重要意义。
性别差异可能导致个体在信息处理策略、风险感知与媒介信任度上存在区别,进而影响其对LLM辅助核查结果的采纳与整合程度。已有实证研究显示,特定情境下女性对典型谣言的判断准确率显著高于男性[23];进一步的技术仿真研究显示,LLM模拟的男性样本在真实新闻辨别任务中展现出更高的误判率[24]。上述结果表明,性别可通过作用于个体认知自信、信息加工深度,以及对技术工具输出结果的信任程度与解析倾向,调节LLM辅助核查的实际效用。据此,本研究提出假设H2a。
H2a:性别在LLM事实核查对用户信息真伪甄别效果影响中具有调节作用。
年龄是影响个体认知能力、信息素养、社会信任与数字工具使用熟练度的重要变量。在突发公共卫生事件中,老年人因风险感知易波动、易做出情绪化非理性决策而显得更为脆弱[25]。从信息甄别素养来看,年龄增长与信息甄别能力的下降趋势显著相关,且针对老年人的干预措施效果往往不够显著[26]。更为普遍的是,老年群体被证实为假新闻的高分享人群,这与其认知变化、更高的信任倾向以及数字素养方面的差距密切相关[27]。上述研究表明,年龄带来的认知与社会心理变化,可能显著调节个体对外部核查工具的依赖程度、理解能力及对其结果的信任程度,从而影响LLM辅助核查的最终效果。因此,本研究提出假设H2b。
H2b:年龄在LLM事实核查对用户信息真伪甄别效果影响中具有调节作用。
受教育程度是衡量个体批判性思维、知识储备量及分析式信息加工能力的重要指标。高教育水平用户凭借更扎实的知识储备与逻辑分析能力,在谣言及虚假健康信息真伪甄别中表现更优[28]。COVID-19疫情期间的调研数据亦证实,与低学历群体相比,高学历参与者对典型谣言的识别准确率更高。进一步研究指出,低教育水平用户的虚假健康信息甄别能力较弱,属于虚假信息的易感群体[29]。上述研究表明,教育背景带来的认知能力与信息素养差异,可能显著调节个体对LLM核查结果的理解深度、评估严谨性及批判性整合程度,从而影响LLM辅助核查的最终效果。基于此,本研究提出假设H2c。
H2c:受教育程度在LLM事实核查对用户信息真伪甄别效果影响中具有调节作用。

3 实验设计/Experimental design

3.1 实验材料设计

虚假信息的传播呈现跨领域、多形态的特征,涉及气候变化、政治、经济、健康等社会生活各个层面。其中,健康类虚假信息相较于一般虚假信息复杂度更高,其识别难度更大,已成为当前网络治理中的一个重要议题。且健康类信息通常基于相对稳定的科学共识,其真伪在较长时间内具有确定性。这有助于降低因LLM知识实时性滞后、复杂推理不足或幻觉而产生的误判风险,从而更聚焦于考察LLM辅助对用户认知过程的影响。因此,本文参考中国互联网联合辟谣平台和国家卫生健康委员会健康科普辟谣平台等相关网站上已经被辟谣的虚假信息,共筛选出虚假信息和真实信息各8条并将其录入问卷,这些平台由国家级权威机构主办,其辟谣信息经过专家论证,确保了实验材料在内容上的真实性与代表性。在正式实验前,邀请10名信息管理领域的教师,他们不参与正式实验,仅对初始实验材料进行预评估,评估内容包括对信息的表达清晰度、理解的难易度以及真实性的主观判断。根据反馈对部分信息的表述进行了通俗化处理并且平衡了材料字数,以确保所有参与者都能无歧义地理解信息内容。同时为了避免测试信息对参与者日常生活的潜在影响,在完成问卷调研后告知所有参与者问卷材料的真实性,维护参与者知情权与信息安全。

3.2 实验分组

本研究采用组间设计,通过随机分配的方式将其分为对照组和实验组,实验组在回答问题时被要求借助当前国内先进的大语言模型DeepSeek对问卷进行事实核查后作答,而对照组仅根据自身的知识水平独立作答。这一设计旨在模拟用户在网络浏览中较为常见的两种情境:一是仅凭自身知识进行判断,二是利用当前高便捷性的AI工具进行逻辑求证。通过比较这两种情境下的用户表现以评估引入LLM带来的增量效果。同时为缩小本研究参与者本身信息辨别素养的差异,在参与者进行正式问卷调查前进行预测试,每位参与者需要回答5个虚假信息以及5个简单的分析思维能力测试题目,预测试每题记一分,达到5分以上视为通过测试,认定其具有一定信息辨别素养,从而被允许参与后续实验。

3.3 变量测量

信息甄别是一个多维度概念,涵盖了对信息真伪、新旧、准确性、可靠性及价值适用性等多个方面的评估。本研究聚焦于信息质量评估中的真实性维度。核心因变量“信息真伪甄别效果”指的是用户判断信息真伪的准确率。借鉴信号检测理论等研究,本研究将其具体操作化为以下3个可量化的指标:①整体识别准确率;②虚假信息识别率;③真实信息识别率。通过这3个指标,可以较为全面地反映用户在真伪判断任务上的表现。在人口统计学变量的调节作用方面设置了性别、年龄和受教育程度3个维度进行测量,在收集样本后对文本数据进行定量转化,进一步测量其调节效应。同时,为了进一步控制问卷的质量,问卷中设置了注意力测试题目“以下3个选项请都选择非常符合”,并剔除了填写时间小于1分钟或答案明显矛盾的样本,以保障数据的有效性。

4 数据分析/ Data analysis

4.1 描述性统计分析

本研究通过问卷星平台开展数据采集,共收集180份问卷,剔除没有通过防人机测试的样本以及填写时间小于1分钟和前后明显矛盾的样本后,最终筛选出有效问卷共计142份。在有效问卷中有73名参与者选择基于个人知识水平完成作答,构成对照组;另外69名参与者使用DeepSeek对问卷信息进行事实核查完成,形成实验组,两组样本划分符合实验设计要求。
由人口统计学结果(表1)可知,本研究参与者的男女比例基本均衡,呈现近似正态分布特征;年龄维度基本覆盖了18岁以上全年龄段群体,其中青年群体样本占比相对较高,中老年群体样本分布合理。受教育程度方面,学历为大专或本科的样本较多,但整体涵盖所有受教育程度的样本,整体比较均衡,说明样本具有良好的代表性和广泛的覆盖度。
表1 样本描述性统计结果

Table 1 Descriptive Statistical Results of the Sample

自变量 选项 频数/人 百分比/%
性别 男 72 50.704
女 70 49.296
年龄/岁 18—35 58 40.845
36—55 49 34.507
≥56 35 24.648
受教育程度 高中及以下 40 28.169
大专或本科 56 39.437
硕士及以上 46 32.394

4.2 独立样本T检验

为确保两组样本在实验前处于同一基线水平,首先对两组参与者在实验前测中的整体得分进行独立样本t检验,以确认实验组与对照组在初始信息辨别素养上并无显著差异。
检验结果(表2)表明,实验组(M=3.116,σ=1.065)与对照组(M=3.151,σ=1.298)在前测得分上的差异未达到统计学显著性(t=0.174,p=0.862)。此外,Cohen's d值为0.029,远小于0.2,表明该差异的效应量极小,可忽略不计。这说明两组参与者在实验干预前的信息辨别素养是没有显著差异的。因此,后续实验中所观测到的组间差异能够有效地归因于是否使用LLM辅助核查这一实验操纵,而并非参与者预先存在的能力差异,满足了进行后续实验分析的前提条件。
表2 独立样本T检验结果

Table 2 Results of Independent Samples T-test

组别 人数 均值M 标准差σ T P Cohen's d
实验组 69 3.116 1.065 0.174 0.862 0.029
对照组 73 3.151 1.298

4.3 单因素方差分析

本研究基于SPSSPRO分析平台进行单因素方差分析(表3),系统检验了LLM辅助事实核查对用户信息真伪甄别效果的影响。研究聚焦于整体识别准确率、虚假信息识别率和真实信息识别率3个维度,结果表明,使用LLM辅助事实核查后,实验组的均值(M=0.77,σ=0.118)显著高于对照组的均值(M=0.705,σ=0.149),且两组间的差异(F=8.322,P=0.005)在0.05的水平上显著,这表明利用DeepSeek辅助事实核查后,用户的整体信息辨别准确率显著提升,故假设H1a得到验证。
表3 对照组与实验组单因素方差分析结果

Table 3 Results of One-way ANOVA for the Control Group and the Experimental Group

变量 组别 均值M 标准差σ F P
整体识别准确率 对照组 0.705 0.149 8.322 0.005
实验组 0.77 0.118
虚假信息识别率 对照组 0.656 0.253 8.607 0.004
实验组 0.77 0.206
真实信息识别率 对照组 0.753 0.18 0.326 0.569
实验组 0.77 0.163
为了进一步分析LLM辅助事实核查对虚假信息和真实信息的识别效果,本研究分别对虚假信息和真实信息的识别率进行单因素方差分析。结果表明两者的显著性存在差异。在虚假信息识别上,实验组的均值(M=0.77,σ=0.206)显著高于对照组的均值(M=0.656,σ=0.253),且两组间的差异(F=8.607,P=0.004)在0.05的水平上显著,说明LLM辅助事实核查显著提高了用户对虚假信息的识别准确率,因此假设H1b得到验证。但在真实信息识别维度,实验组的均值(M=0.77,σ=0.163)只轻微高于对照组的均值(M=0.753,σ=0.18),且两组间的差异并不显著(F=0.326,P=0.569),说明在辨别真实信息方面,LLM辅助事实核查后并未能显著提升用户的真实信息识别率,故假设H1c不成立。这种不对称性表明,LLM的辅助作用可能并非源于用户对其输出结论的简单复制,而是其提供的核查线索激活了用户的分析式加工,从而在辨别虚假信息时产生了更为显著的积极效果。

4.4 调节效应分析

为了进一步调查不同人口统计学特征群体在使用LLM辅助事实核查后,其信息真伪甄别效果是否存在差异,本研究通过SPSSPRO的平行中介效应对性别、年龄和受教育程度三项核心变量进行调节效应分析。
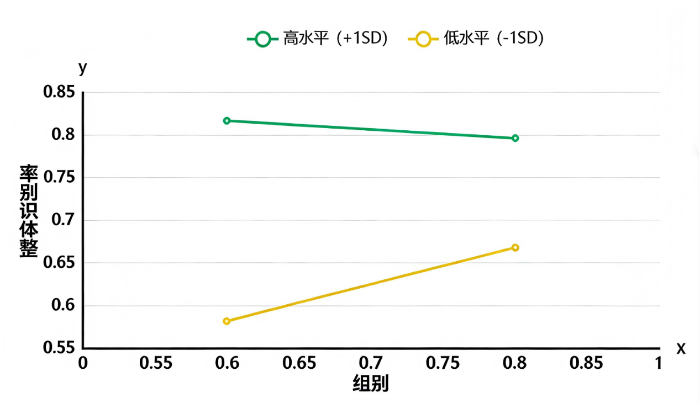
本研究采用层级回归分析检验调节效应,在分别对性别、年龄和受教育程度与组别进行交互后,调节效应分析(表4)显示,组别与性别的交互结果不显著(系数=-0.024,p=0.592),系数为负表明男性群体使用LLM的提升效果略低于女性群体,但彼此差异并无统计学意义,进一步说明LLM事实核查的辅助效果没有因性别差异而显著分化。组别与年龄的交互同样未通过显著性检验(系数=0.054,p=0.064),其中系数为正表明年长人群受到LLM事实核查辅助后对信息真伪甄别效果获得相对更高的提升,但未达到统计学意义。因此,研究假设H2a、H2b没有得到验证。组别与受教育程度的交互结果在0.05水平上显著(系数=-0.068,p=0.029),其中系数为负表明低学历群体相较于高学历群体,在使用LLM辅助事实核查时,信息真伪甄别效果的提升更为明显。这一结果验证了研究假设H2c。这可能是因为低学历人群由于缺乏系统性的健康知识储备与信息素养训练,在独立判断时面临较大困难,而LLM提供的事实核查信息为其提供了关键的外部认知支持,从而带来了更为显著的提升效果。相比之下,高学历人群本身已具备较强的分析判断能力,LLM的辅助提升效果相对有限。
表4 性别、年龄和受教育程度的调节效应分析结果

Table 4 Results of Moderating Effect Analysis of Gender, Age and Education Level

交互项 系数 标准误 T P
组别*性别 -0.024 0.045 -0.537 0.592
组别*年龄 0.054 0.029 1.869 0.064
组别*受教育程度 -0.068 0.031 -2.202 0.029
进一步地,组别与受教育程度的交互效应结果如图2所示,在未使用LLM的对照组中,高学历群体的表现明显优于低学历群体;而在使用LLM的实验组中,低学历群体的提升效果明显高于高学历群体,两者差距显著缩小。这表明受教育程度越低,从LLM辅助核查中获得的提升效果越明显。低教育程度用户因知识储备有限,更依赖启发式判断,LLM提供的外部证据有效激活其分析式系统,从而实现更显著的认知补偿效应;而高教育用户本身具有较强的分析能力,LLM的提升作用相对有限。
图2 组别与受教育程度的交互效应

Figure 2 Interaction effect diagram of group and educational attainment

5 结论与启示/Conclusion and implication

5.1 研究结论

本研究以健康类信息为具体情境和实验材料,通过对照实验设计,系统探究了LLM对用户信息真伪甄别效果的影响,并结合问卷数据进一步深化分析,得出以下主要结论:
首先,LLM辅助事实核查在辨别虚假信息方面的效果更为显著。研究发现,借助LLM辅助事实核查可有效提升用户对健康类虚假信息识别的准确率,表明LLM作为外部认知辅助工具,能够有效助力用户开展批判性质证与逻辑反驳,提升虚假信息甄别效果。但与此同时,LLM辅助并未对健康类真实信息的识别准确率产生显著正向影响。这一不对称性表明,当前阶段的LLM更适用于虚假信息的质疑与排查,难以作为稳定可靠的真实信息验证载体。这可能是因为LLM输出的信息内容往往较为繁杂,某种程度上增加了用户的认知负担,同时LLM本身也会输出错误信息,进而干扰用户对真实信息的准确判断。
其次,受教育程度对LLM辅助效果具有显著调节作用,且对低受教育程度群体的辅助提升效果更为突出。数据分析显示,低受教育程度用户在使用LLM辅助核查后,信息甄别能力的提升幅度显著高于高受教育程度用户。这一结果表明,LLM所提供的外部证据支撑与逻辑分析思路,能够有效弥补低学历群体在独立进行信息判断时,在知识储备、逻辑分析框架方面的不足,形成明显的认知补偿效应。而高受教育程度用户本身已具备较强的独立分析与判断能力,LLM辅助所带来的额外提升空间相对有限。该发现凸显了LLM在赋能数字信息弱势群体、缩小不同群体信息甄别能力差距、促进信息判断公平性方面的潜在社会价值。
最后,性别与年龄在本研究框架内未对LLM辅助效果产生显著调节作用。在健康信息甄别这一特定情境下,不同性别、不同年龄段用户通过LLM辅助所获得的甄别效果提升,未呈现统计学意义上的显著差异。这一结果表明,在客观健康知识的甄别场景中,影响人机协同甄别效能的核心因素,并非性别、年龄这类基础人口学特征,而更可能是个体信息处理习惯、对LLM技术的信任程度、任务参与深度等更为深层的认知特征或情境性因素。这也为后续LLM辅助工具的差异化优化提供了启示:需深入探究认知与行为层面的个体差异,有针对性地完善工具设计。
综上,本研究证实了LLM辅助事实核查在健康信息领域的应用价值,同时明确了其效果发挥的边界条件:LLM在应对虚假信息方面表现更为突出,且对信息素养基础薄弱的群体具有显著的提升作用。这为深入研究人机协同认知的运行机制,以及应对社交平台上的虚假信息提供了有效的实证支撑。

5.2 理论贡献

本研究在理论层面的贡献主要体现在3个方面。①本研究将LLM嵌入事实核查的具体应用场景,系统剖析了LLM辅助核查模式对用户信息真伪甄别效果的作用机制,明确界定了其在虚假信息识别中的正向价值,同时指出了其在真实信息判别中的应用局限。这一探索推动事实核查研究从传统人工主导模式向人机协同模式演进,为理解智能化工具与用户认知的交互机制提供了新的理论视角。②基于双过程理论,本研究证实LLM提供的事实核查信息可作为有效的外部认知支撑,助力用户对信息开展更具深度的系统式加工。研究表明,技术工具通过输出结构化证据与逻辑推理,能够弥补用户启发式加工中的认知短板、填补认知缺口,进一步拓展了双过程理论中关于外部辅助介入认知加工、优化加工路径的理论内涵。③本研究引入人口统计学变量作为调节变量,实证发现受教育程度对LLM辅助核查效果具有显著调节作用,该结论呼应并延伸了健康辟谣等相关领域中关于个体差异调节效应的研究成果,也为打击虚假信息的差异化策略构建提供了理论支持,凸显了技术赋能背景下用户个人特质与技术效能适配性研究的重要性。

5.3 实践启示

本研究在实践层面主要提出三方面建议。
其一,推行差异化用户赋能策略,聚焦低受教育程度群体,优化LLM核查工具的推广与应用。本研究证实,LLM辅助核查对低受教育程度群体的信息真伪甄别效果更为显著,据此,社交平台可将LLM核查工具作为赋能该群体的核心认知辅助载体。通过简化工具交互界面、提供通俗化操作指引,重点呈现LLM批驳虚假信息的逻辑推演过程与核心依据,切实发挥其弥补低受教育程度群体知识储备不足、缩小群体间信息甄别能力差距的社会价值。
其二,优化LLM核查结果的呈现逻辑,降低用户认知负担,提升真实信息确认效率。针对本研究发现的LLM辅助未显著提升真实信息识别率,且其输出内容可能引发用户认知混淆的问题,需针对性优化结果输出设计。对于真实信息,应提供结构清晰、援引权威来源的证据摘要,增强结论可信度;同时,可探索标注LLM判断结果的置信度,引导用户结合置信度审慎采纳核查结论,规避因模型自身局限性对真实信息判断造成的干扰,实现真假信息甄别效能的协同提升。
其三,构建融合双过程理论视角的人机协同核查机制,强化工具效能与用户素养的双向提升。一方面,可搭建LLM初步筛查与人工重点复核相结合的协同体系,依托LLM的高效处理能力完成海量健康信息的快速初判与核心证据抓取,再由人类专家对复杂、高争议性信息进行最终裁定,兼顾核查效率与准确性;另一方面,在LLM交互设计中融入分析式加工引导,通过设置分步推理输出、关键证据对比等功能,引导用户深度参与信息甄别过程,将工具使用转化为用户信息素养的常态化训练路径,实现人机协同效能的长期提升。

5.4 研究局限与未来展望

本研究也存在一些局限性。①本研究的实验材料与结论均聚焦于健康信息领域。不同领域虚假信息的特性存在显著差异,因此本研究结论的普适性有待未来通过跨领域研究进一步检验。②本研究主要考察了基础人口统计学变量的调节作用。尽管从理论上阐释了这些变量作为深层认知特质代理指标的可能性,但未能直接测量用户的专业知识结构、标准化的信息素养水平以及对数字技术的接入与使用能力等更为核心的变量,这可能导致对调节机制的解释不够深入。③本研究测量的是大语言模型辅助事实核查的整体效果,未能分离其自身技术局限(如模型幻觉与数据滞后)带来的潜在影响,未来需通过更精细的实验设计以辨析其具体作用机制。
[1]
PORTER E, WOOD T J. The global effectiveness of fact-checking: evidence from simultaneous experiments in Argentina, Nigeria, South Africa, and the United Kingdom[J]. Proceedings of the National Academy of Sciences, 2021, 118(37): e2104235118.

[2]
ROOZENBEEK J, VAN DER LINDEN S, GOLDBERG B, et al. Psychological inoculation improves resilience against misinformation on social media[J]. Science advances, 2022, 8(34): eabo6254.

[3]
DAS A, LIU H, KOVATCHEV V, et al. The state of human-centered NLP technology for fact-checking[J]. Information processing management, 2023, 60(2): 103219.

[4]
QIN C, ZHANG A, ZHANG Z, et al. Is ChatGPT a general-purpose natural language processing task solver?[J]. arXiv preprint arXiv:2302.06476, 2023.

[5]
孟健, 方媛.在线新闻核查“众包”模式的应用、困境及对策[J]. 传媒, 2024(14): 90-92.

MENG J, FANG Y. Application, dilemmas and countermeasures of the "crowdsourcing" model in online news verification [J]. Media, 2024 (14): 90-92.

[6]
李瑾颉, 聂凯伦, 吴联仁, 等.众包事实核查对信息参与行为的影响:基于来源可信度的调节[J]. 知识管理论坛, 2024, 9(4): 367-379.

LI J J, NIE K L, WU L R, et al. The impact of crowdsourced Fact-checking on user information engagement behavior: the moderating of source credibility [J]. Knowledge management forum, 2024, 9(4): 367-379.

[7]
王智超, 许祯臻, 俞怡帆, 等.社交媒体上错误信息的分享:影响因素、理论解释和干预[J]. 心理学探新, 2024, 44(6): 507-515.

WANG Z C, XU Z Z, YU Y F, et al. Sharing of misinformation on social media: influencing factors, theoretical explanations, and interventions [J]. Psychological exploration, 2024, 44(6): 507-515.

[8]
CLAYTON K, BLAIR S, BUSAM J A, et al. Real solutions for fake news? measuring the effectiveness of general warnings and fact-check tags in reducing belief in false stories on social media[J]. Political behavior, 2020, 42(4): 1073-1095.

[9]
王孝盼, 张淼, 吴懿, 等.社交媒体中健康信息可信度的影响因素研究:先验知识的调节作用[J]. 信息资源管理学报, 2024, 14(1): 55-67.

WANG X P, ZHANG M, WU Y, et al. Exploring the antecedents of health information credibility at social media platforms: the moderating role of prior knowledge [J]. Journal of information resources management, 2024, 14(1): 55-67.

[10]
张翔然, 李璐旸.PromptWE:一种融合解释的提示学习事实核查模型[J]. 清华大学学报(自然科学版), 2024, 64(5): 760-769.

ZHANG X R, LI L Y. PromptWE: a fact-checking method based on prompt learning with explanations [J]. Journal of Tsinghua University (science and technology), 2024, 64(5): 760-769.

[11]
张欣, 孙靖超.基于大语言模型的虚假信息检测框架综述[J]. 计算机科学与探索, 2025, 19(6): 1414-1436.

ZHANG X, SUN J C. Review of false information detection frameworks based on large language models [J]. Journal of frontiers of computer science and technology, 2025, 19(6): 1414-1436.

[12]
ROUMELIOTIS K I, TSELIKAS N D, NASIOPOULOS D K. Fake news detection and classification: a comparative study of convolutional neural networks, large language models, and natural language processing models[J]. Future internet, 2025, 17(1): 28.

[13]
TRAN T, VALECHA R, RAO H R. Machine and human roles for mitigation of misinformation harms during crises: an activity theory conceptualization and validation[J]. International journal of information management, 2023, 70: 102627.

[14]
何宇华, 李霞.生成式人工智能虚假信息治理的新挑战及应对策略——基于敏捷治理的视角[J]. 治理研究, 2024, 40(4): 142-156, 160.

HE Y H, LI X. New challenges and countermeasures of false information governance in generative artificial intelligence——based on the agile governance perspective [J]. Governance studies, 2024, 40(4): 142-156, 160.

[15]
祁凯, 周燕生.基于大语言模型生成内容的负面舆情态势恶化牵引作用研究[J]. 情报杂志, 2025, 44(8): 153-161, 171.

QI K, ZHOU Y S. Research on the traction effect of the deterioration of negative public opinion situation based on content generated by large language models [J]. Journal of intelligence, 2025, 44(8): 153-161, 171.

[16]
SHAH S B, THAPA S, ACHARYA A, et al. Navigating the Web of disinformation and misinformation: large language models as double-edged swords[J]. IEEE access, 2024.

[17]
ALI K, LI C, ZAIN-UL-ABDIN K, et al. Fake news on Facebook: examining the impact of heuristic cues on perceived credibility and sharing intention[J]. Internet research, 2022, 32(1): 379-397.

[18]
DEVERNA M R, YAN H Y, YANG K C, et al. Fact-checking information from large language models can decrease headline discernment[J]. Proceedings of the National Academy of Sciences, 2024, 121(50): e2322823121.

[19]
TRUICA C O, APOSTOL E S. It’s all in the embedding! fake news detection using document embeddings[J]. Mathematics, 2023, 11(3): 508.

[20]
付少雄, 孙岚, 邓胜利, 等.应对理论视角下短视频用户虚假健康信息采纳的动因研究[J]. 情报资料工作, 2023, 44(6): 100-110.

FU S X, SUN L, DENG S L, et al. A study on the motivation of short video users' false health information adoption from the perspective of coping theory [J]. Information and documentation services, 2023, 44(6): 100-110.

[21]
姜雨杉, 张仰森.大语言模型驱动的立场感知事实核查[J]. 计算机应用, 2024, 44(10): 3067-3073.

JIANG Y S, ZHANG Y S. Large language model-driven stance-aware fact-checking[J]. Journal of computer applications, 2024, 44(10): 3067-3073.

[22]
RIJO A, WALDZUS S. That's interesting! the role of epistemic emotions and perceived credibility in the relation between prior beliefs and susceptibility to fake-news[J]. Computers in human behavior, 2023, 141: 107619.

[23]
郑铭, 李婕, 成佩霞, 等.新型冠状病毒肺炎流行期间公众对典型谣言正确甄别率的调查[J]. 中南大学学报(医学版), 2022, 47(12): 1704-1710.

ZHENG M, LI J, CHENG P X, et al. A survey on the public’s discrimination rate of typical rumors during the coronavirus disease 2019 epidemic [J]. Journal of Central South University (medical sciences), 2022, 47(12): 1704-1710.

[24]
虞鑫, 王金鹏.“真实”的鸿沟:人类认知与大语言模型判定新闻真实的比较研究[J]. 当代传播, 2024(5): 17-23.

YU X, WANG J P. "The gap of "truth": a comparative study of human cognition and large language models in judging the truth of news[J]. Journalism communication, 2024(5): 17-23.

[25]
周国韬, 邓胜利.突发公共卫生事件下老年人信息感知与保护性行动决策研究[J]. 情报资料工作, 2021, 42(2): 31-42.

ZHOU G T, DENG S L. Research on the elderly's information perception and protective action decision under the sudden public health event [J]. Information and documentation services, 2021, 42(2): 31-42.

[26]
张秀, 李月琳.年龄梯度视角下网络用户健康信息甄别能力研究[J]. 情报学报, 2019, 38(8): 838-848.

ZHANG X, LI Y L. Ability of users in different age groups to screen health information in social media[J]. Journal of the China Society for Scientific and Technical Information, 2019, 38(8): 838-848.

[27]
BRASHIER N M, SCHACTER D L. Aging in an era of fake news[J]. Current directions in psychological science, 2020, 29(3): 316-323.

[28]
刘鸣筝, 孔泽鸣.媒介素养视阈下公众谣言辨别能力及其影响因素的实证研究[J]. 新闻大学, 2017(4): 102-109, 151.

LIU M Z, KONG Z M. An Empirical study on the nature and determinants of rumor discrimination ability from the perspective of media literacy[J]. Journalism bimonthly, 2017(4): 102-109, 151.

[29]
邓胜利, 顾一飞.网络虚假健康信息研究综述:认知、行为与治理[J]. 图书馆杂志, 2022, 41(5): 14-22.

DENG S L, GU Y F. A review of online health misinformation: recognition, action and governance[J]. Library journal, 2022, 41(5): 14-22.

Outlines

/

〈 〉