Research on Generative Artificial Intelligence-based Few-Shot Sentiment Identification Method for Emergency Enterprise Public Opinion

  • Li Kangjie Xie Yanxi
Expand
  • School of Management, Shanghai University of Engineering Science,Shanghai 201620
Xie Yanxi, Associate Professor, PhD, E-mail: .

Li Kangjie, Master's Candidate

Received date: 2026-03-24

  Online published: 2026-09-29

Supported by

National Social Science Fund of China General Project titled "Research on the Propagation Mechanism and Governance Strategies of Artificial Intelligence-Generated Online Rumors"(25BGL298)

Abstract

[Purpose/Significance] Targeting the core limitations of traditional sentiment analysis methods in emergency corporate public opinion scenarios—heavy reliance on annotated data, weak implicit sentiment recognition, and insufficient generalization—this paper examines the feasibility of Generative Artificial Intelligence (GAI) in achieving sentiment recognition and reputation risk segmentation under few-shot learning conditions, aiming to provide methodological support for emergency public opinion monitoring and early warning. [Method/Process] Using Weibo comments from the "Arc'teryx Himalayan Fireworks Incident" as empirical data, this paper constructed a single-inference dual-task output GAI sentiment analysis model integrating prompt engineering and in-context learning. A dual-process few-shot example construction scheme was adopted, and strictly controlled experiments were conducted between structured prompts and general prompts. Traditional machine learning and deep learning baseline models were incorporated for horizontal comparison, and reliability was further validated through dual example-set robustness testing. [Result/Conclusion] All three GAI models outperform the traditional baseline models in this experiment. Doubao-Seed-1.6 achieves an overall accuracy of 84.22% with a negative sentiment recall of 90.71% under structured prompts. Structured prompts outperform general prompts in both overall accuracy and negative sentiment recognition, while simultaneously outputting four core and other reputation risk labels alongside the three-class sentiment classification. Experimental results demonstrate good repeatability and robustness. This method enables sentiment classification and risk segmentation with low reliance on labeled data, providing structured data support for tiered early warning and targeted crisis response in emergency corporate public opinion management.
Cite this article

Li Kangjie Xie Yanxi . Research on Generative Artificial Intelligence-based Few-Shot Sentiment Identification Method for Emergency Enterprise Public Opinion[J]. Knowledge Management Forum, 2026 , 11(5) . DOI: 10.13266/j.issn.2095-5472.2026.039

中国互联网络信息中心发布的第57次《中国互联网络发展状况统计报告》显示,截至2025年12月,我国网民规模达11.25亿人,互联网普及率突破80%,较2024年底提升1.1%,生成式人工智能用户规模达6.02亿人,较2024年底增长141.7%,普及率达42.8%,大幅提高25.2个百分点[1]。互联网的高速发展极大提升了信息传播效率,深刻重塑了网络舆情的生成、扩散与演化机制。
企业作为舆论场的核心主体之一,其网络舆情态势直接关系品牌声誉与市场稳定,突发企业舆情的场景特殊性体现在三个层面。第一,声誉损害的不可逆性。一般网络舆情的负向情感多为分散的个体不满,而突发企业舆情中的负向情感往往迅速凝聚为集体性声誉指控,直接冲击品牌资产与消费者信任,且此类冲击具有难以消弭的长尾效应。第二,负向情感的声誉风险指向性。企业舆情中的负向评论并非同质化的“差评”,而是指向不同类型的声誉风险,识别负向情感究竟指向哪类企业声誉风险,是企业应对舆情危机的核心信息需求。第三,少样本方法与突发企业舆情的天然契合性。突发舆情事件具有爆发急骤、演化迅速的特点,企业在事件发生后短时间内难以完成大规模语料标注,且不同突发事件的语境差异显著,基于历史数据训练的监督学习模型往往面临严重的领域迁移困境。少样本学习通过精心设计的提示工程与极少量高质量示例即可完成情感识别,匹配突发场景下“低标注资源、高响应时效”的双重约束,使其成为企业突发舆情情感识别的适配方法。
生成式人工智能(generative artificial intelligence,GAI)的迅速发展,为网络舆情中的情感分类研究提供了新的技术路径与方法支持。传统的网络舆情分析多依赖于情感词典、机器学习与深度学习等方法,大语言模型凭借其强大的语义理解能力与少样本学习特性,能够在有限标注数据中推断出复杂的情感标注规律,从而有效完成细粒度的情感分类任务。
基于此,本文围绕生成式人工智能实现突发企业舆情复杂语义环境下的情感识别,拟解决以下关键问题:①如何构建融合提示工程与上下文学习的分析框架,将企业舆情特定语境与模型能力深度结合,在低标注依赖下实现稳定、高精度的情感分类;②如何让生成式人工智能识别出突发企业舆情文本中的网络反讽、商业隐喻等复杂语义,并进一步辨别负向情感所指向的具体企业声誉风险类型,评估其相较于传统模型的性能边界,实现面向企业声誉风险的深度情感识别;③如何通过多模型对比与稳健性检验,验证该方法在真实企业舆情文本中的分类可靠性与泛化能力,为企业舆情智能分析提供技术方案。本研究既能拓展企业网络舆情分析的研究视角与理论边界,也能为生成式人工智能在舆情分析领域的落地应用提供可借鉴的创新思路与实践路径。

1 相关研究/Relevant research

1.1 基于生成式人工智能的网络舆情研究

GAI凭借强大的语义理解、上下文推理与少样本适配能力,正在重构网络舆情的生成、传播、研判与治理范式[2]。当前面向企业场景的GAI舆情分析仍处于探索阶段,研究多集中于技术应用、风险测度与传播规律挖掘,尚未形成适配突发舆情低标注、高时效需求的提示工程与少样本情感分析框架。江长斌等[3]基于信息生态理论构建GAI回应网民评论的流程,通过可解释机器学习方法识别出总词数、语言风格匹配度、工作词数等是影响回应有效性的关键因素,并进一步通过提示词工程优化生成内容,验证GAI在高校网络舆情中具备回应网民评论的能力。张艳丰等[4]构建智能生成网络舆情风险指标体系,为系统性评估GAI情境下的舆情风险提供了理论框架与方法支持。吴江等[5]基于引爆点理论,从内容、用户、情感三维度构建GAI舆情分析模型,发现GAI在微博平台上的舆情传播以技术进展、数字艺术与前景展望为核心议题,传播网络中以知名博主为关键节点,整体情感趋于积极,但人机关系争议仍是影响公众情绪的主要负面因素。梁循等[6]系统剖析人工智能生成内容(artificial intelligence generated content,AIGC)对舆情生态的深层影响与治理挑战,指出GAI可通过优化信息配置、提升流通效率、重组危机知识实现治理效能升级,且在不同风险特征舆情场域中存在异质性,为后续深入研究生成式人工智能的赋能机制提供了理论参照。

1.2 网络舆情情感分析

网络舆情情感分析旨在通过计算手段自动识别网络文本中所蕴含的情感倾向与主观观点,其相关研究最早由J. Yi等[7]提出。随着社交媒体成为公众意见表达的主要渠道,该技术在舆情监控、品牌管理等领域的重要性日益凸显。其方法论演进历经情感词典、传统机器学习、深度学习三大阶段,逐步向少样本、深语义、高鲁棒方向发展,但在突发企业舆情场景中仍存在标注依赖重、隐晦情感识别弱、泛化能力不足等瓶颈。
早期基于情感词典的方法依靠人工构建极性词典与规则匹配实现情感计算,直观易解释,但难以适配网络俚语、新词与动态语境,在反讽、隐喻等复杂表达上泛化性差。伏虎[8]通过构建领域词典并结合语义模式权值,提升舆情情感的识别效果。传统机器学习方法以朴素贝叶斯、支持向量机为代表,依赖特征工程将文本向量化后分类,一定程度上摆脱对词典的依赖,邓君等[9]结合Word2Vec与SVM对微博舆情情感进行演化分析,但其性能严重依赖于特征提取的质量,且难以捕捉深层次的上下文语义关联。深度学习方法依托神经网络自动学习文本特征,显著提升了情感分类精度。杨秀璋等[10]提出的BiLSTM-CNN-Attention混合模型,通过引入注意力机制有效聚焦关键情感信息;曹宇等[11]采用双向门控循环单元(bidirectional gated recurrent unit,BGRU)在保证性能的同时简化模型结构。F. Huang等[12]则利用模态标记长短期记忆(long short-term memory,LSTM)与自注意力机制进一步提升对区分性特征的捕捉能力。近年来,为应对舆情的多模态特性,多模态融合方法逐渐兴起。这类研究尝试整合文本、图像乃至语音信息,以更全面地理解用户情感。曾子明等[13]融合BERT(bidirectional encoder representations from transformers)与视觉Transformer(ViT)构建多模态负面情感识别模型;张换香等[14]则通过多头互注意力机制学习文本与语音、视觉模态之间的交互特征,并引入以文本为中心的交叉注意融合网络强化多模态特征表示,有效提升了中文隐式情感分析性能。
然而,上述研究仍存在一定的局限性,多数研究依赖于监督学习范式,其模型性能在很大程度上受限于大规模高质量标注数据的可得性,而这在突发舆情的快速响应场景中往往难以得到满足。此外,传统模型与深度学习方法在面对网络文本中常见的反讽、隐喻等复杂隐晦情感时,其语义理解深度仍显不足,存在性能瓶颈。因此,本文以生成式人工智能在企业突发舆情复杂语义场景下的精准情感识别可行性为核心议题,设计适配突发舆情的单次推理—双任务输出情感分析框架,为企业精准危机响应提供方法支撑。

2 研究设计/Research design

2.1 研究框架设计

本文以突发企业舆情事件为研究对象,构建基于生成式人工智能的企业舆情情感分类与风险识别模型。与通用情感分类任务不同,本研究的核心目标不仅在于判断公众评论的情感极性,更在于识别负向情感所指向的具体企业声誉风险类型,以支撑分级预警与精准危机响应。
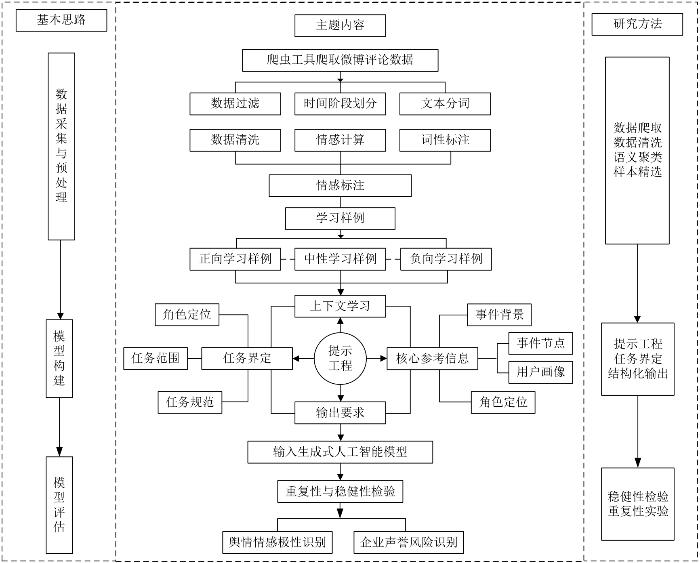
研究框架分为三部分:一是数据采集及预处理,采集突发企业舆情案例数据,经系统性清洗与语义处理后,同步构建含企业声誉风险类型标注的少样本示例集;二是双任务一体化模型框架构建,分别设计企业舆情风险识别导向的结构化提示词与通用提示词,在相同的事件背景、上下文学习机制与测试集条件下开展对照实验,核心差异仅在于任务界定中的角色设定与任务目标;三是模型性能评估与实证分析,构建多维度对比实验体系,将生成式人工智能模型与传统基线模型开展横向性能比对,通过多轮独立重复实验与稳健性检验,系统评估模型在双任务输出中的分类精度、稳定性与泛化能力。研究框架见图1。
图1 研究框架

Figure 1 Research framework

2.2 生成式人工智能情感分析模型设计

本研究基于生成式人工智能构建企业网络舆情情感分析与风险识别模型,在任务设计上划分为两个逻辑层次:第一层次为情感极性识别,依托提示工程与上下文学习,针对突发型企业舆情在少样本条件下实现精准的情感三分类[15];第二层次为企业声誉风险识别,针对情感极性判定为负向的评论,进一步细分其所指向的声誉风险类型。上述两个逻辑层次指任务目标的层级划分,并非两次独立的模型调用,两项任务均在单次推理中同步完成。
为系统评估场景化提示设计的有效性,本研究设置两组对照实验:结构化提示词组同时执行情感三分类与声誉风险类型识别两项任务,在单次推理中输出情感极性标签与风险类型标签;通用提示词组仅执行情感三分类的单一任务,作为基准对照组。两组提示词共用完全相同的事件背景描述、用户画像信息、上下文学习机制与少样本示例集,核心差异仅在于任务界定模块,前者将模型角色设定为“企业舆情声誉风险分析专家”并明确双任务目标,后者将模型角色设定为“通用情感分析模型”,仅要求完成情感极性分类。
模型架构主要包括4个核心组件,分别为任务界定、核心参考信息、上下文学习与提示工程融合机制和输出要求,下面将详述各组件内容。

2.2.1 任务界定

任务界定是本研究两套提示词对照实验设计的核心差异环节,用以明确模型在特定舆情场景下的角色定位与任务规范。两套提示词在统一框架下仅此组件存在差异,其余组件(核心参考信息、上下文学习融合机制、输出要求)完全一致,角色设定与任务层级确立为核心实验变量,除上述变量外其余实验条件均严格控制,最大限度保障对照实验的内部有效性。
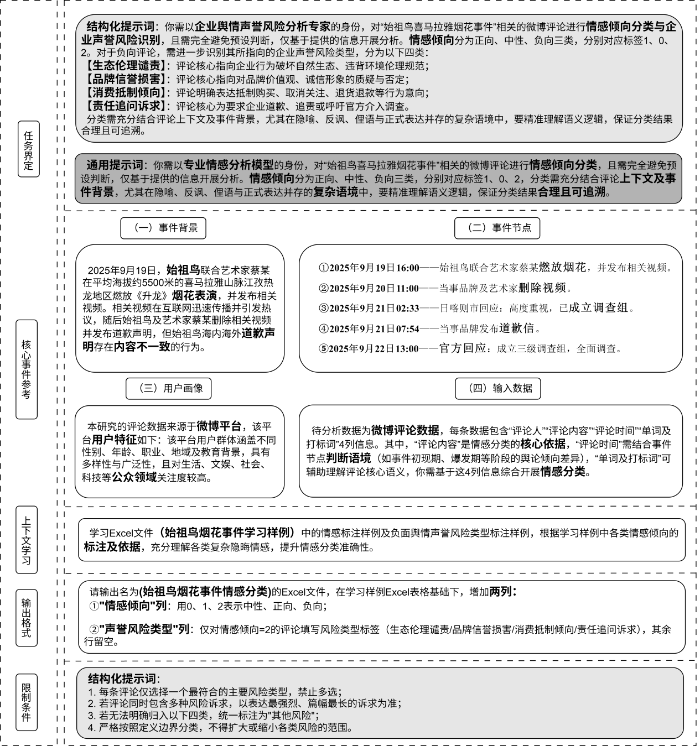
结构化提示词将模型角色设定为“企业舆情声誉风险分析专家”,并按两个任务层次分别界定任务目标。第一层次任务要求模型凭借对中文网络语言与企业舆情文化背景的深度理解,对微博评论进行正向、中性、负向三分类情感识别,并特别覆盖网络俚语、口语化表达、隐喻及反讽等复杂语义场景。第二层次任务仅对第一层次任务判定为负向的评论进行风险类型细分,识别四类核心及其他声誉风险类别,见表1。
表1 企业声誉风险类别

Table 1 Corporate reputation risk categories

风险类别 风险识别规范
生态伦理谴责 针对企业行为破坏自然生态、违背伦理规范的批评
品牌信誉损害 对品牌价值观、诚信形象的质疑与否定
责任追问诉求 要求企业道歉、追责或官方介入的诉求
消费抵制倾向 明确表达抵制购买、取消关注、退货退款等行为意向
其他风险 不明确指向上述4类的负向情感评论,包括风险类型混合或指向模糊的表达
输出格式统一为结构化数据,以确保结果的可追溯性与后续分析的便利性。

2.2.2 核心参考信息

核心参考信息组件为模型提供执行情感分类所必需的事件背景与语境描述,以增强模型对特定舆情事件的场景感知与语义理解。该组件涵盖4个模块:其一,事件背景,简述“始祖鸟喜马拉雅烟花事件”的起因与核心争议;其二,事件节点,列出从烟花视频发布至官方介入调查的关键时间线,为模型构建舆情演化的时序认知;其三,用户画像,描述新浪微博平台用户的典型特征与表达风格,辅助模型识别口语化与隐晦表达;其四,输入数据,说明评论数据的字段结构,引导模型准确解析各字段的语义角色。

2.2.3 上下文学习与提示工程融合机制

上下文学习作为大语言模型的核心能力,仅需在输入提示词中嵌入少量任务示例,模型即可自主理解任务逻辑并完成指定任务,无需更新模型参数[16]。依据示例供给方式,上下文学习可划分为零样本学习与少样本学习两类:零样本学习不提供任何任务示例,仅依靠自然语言指令明确任务目标与输出规范,模型直接基于指令完成推理与输出;少样本学习则在提示词内加入少量高质量任务示例(通常为1—10条),辅助模型快速习得任务规则、输出格式与分类边界,进而高效完成目标任务。已有研究证实,相较于零样本学习,少样本学习能够为模型提供更稳定、更精准的任务参考依据,显著提升复杂场景下的任务执行效果[17]。
提示工程是面向大语言模型的任务引导与语义约束技术,通过对提示文本进行角色化、结构化与场景化设计,精确界定模型的角色定位、任务目标、推理逻辑与输出规范,在无需对模型参数进行微调的前提下,充分激活模型的语义理解与推理能力,提升任务执行的稳定性与准确性[18]。
两者的协同融合,是本模型在少样本条件下实现复杂语义理解与精准情感分类的核心支撑。在提示结构设计层面,本研究将任务描述、角色设定、上下文信息、示例样本4类要素进行系统化整合,构建完整的推理环境,提供清晰的任务导向与语义约束。在情感分类任务建模层面,提示工程将情感识别转化为上下文感知的自然语言判别任务,通过精细化的提示内容优化,使模型在给定事件背景与输入评论的条件下,稳定输出符合任务要求的情感标签,从而提升分类准确率与鲁棒性,情感标签序列生成概率计算如公式(1)所示。
P ( Y X , C ) = ∏ t = 1 T   P y t ∣ y < t , X , C
其中, X为输入评论文本, C为提示上下文(包括任务描述、示例等), Y为情感标签序列, T为输出长度。通过优化提示内容 C,可最大化模型对目标情感标签 Y的生成概率。
针对反讽、隐喻等隐晦情感的识别难点,本研究在提示词设计中引入三层语义增强策略:一是关键词引导,在提示词中嵌入情感极性词与企业舆情领域术语,强化模型对关键情感特征的聚焦;二是语境约束,依托事件背景与舆情场景信息限定模型推理空间,压缩语义歧义;三是高质量少样本示例构建,精选覆盖多元情感强度与复杂语义场景(反讽、隐喻、口语化表达)的典型样本,引导模型从少量示例中精准归纳分类规则,有效提升对隐晦情感的识别效果[19]。

2.2.4 输出要求

为确保输出数据可直接用于后续分析与可视化,两套提示词均被要求以结构化形式输出结果。具体列项因任务层次不同而有所差异。通用提示词组在原始数据基础上新增“情感倾向”列,以整数值1、0、2分别标识正向、中性与负向情感。结构化提示词组在此基础上进一步增设“声誉风险类型”列,仅对情感倾向为2(负向)的评论填写对应风险类型标签,其余行留空。上述双列输出设计保障了从情感极性识别到声誉风险类型细分的全程可追溯性,为企业实施分级预警与精准危机干预提供了结构化的数据支撑。

3 实证分析/Empirical analysis

为验证生成式人工智能单次推理—双任务输出情感识别与声誉风险识别模型在突发企业舆情中的适用性与有效性,本研究围绕“始祖鸟喜马拉雅烟花事件”展开实证分析。通过采集微博平台相关评论文本,综合运用提示工程与上下文学习策略,以结构化提示词组与通用提示词组开展对照实验及稳健性检验,其中,结构化提示词在完成情感极性三分类的基础上,进一步实现对负向评论所指向企业声誉风险类型的细粒度识别。本部分将从数据预处理与提示词设计、模型性能评估等方面展开论述,旨在为突发企业舆情声誉风险的精准识别与分级应对提供实证依据与方法支持。

3.1 数据预处理与提示词设计

3.1.1 数据收集

新浪微博平台作为国内头部社交媒体平台之一,用户量居全国前列,其用户的评论及观点具有很高的代表性,同时,该平台具备信息传播实时性强、交互程度高等特点,为用户提供了表达情感的有效渠道[20]。相较于传统媒体,新浪微博平台上的用户情感表达更为直接且及时,使其成为分析社会舆论态势与公众情感倾向的重要场域,因此本研究选取该平台作为数据采集来源。
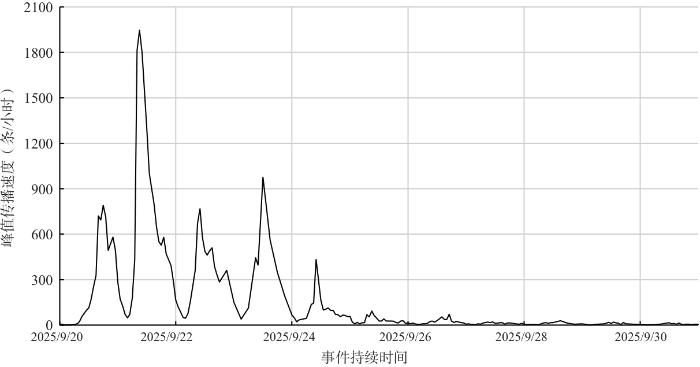
本研究选取“始祖鸟喜马拉雅烟花事件”作为实证案例,在于该事件具备突发企业舆情的典型特征:其一,事件具有高度突发性,从烟花视频发布至舆情全面爆发仅历时约20小时,符合突发企业舆情传播急骤、响应窗口极短的场景特征;其二,事件引发的公众情感表达高度多元,具有较强的代表性与分析价值;其三,事件舆情周期完整,为模型在不同传播阶段的情感识别提供了完整的语料覆盖;其四,事件中大量评论涉及网络反讽、隐喻等复杂语义表达,有助于充分检验模型的隐晦情感识别能力。
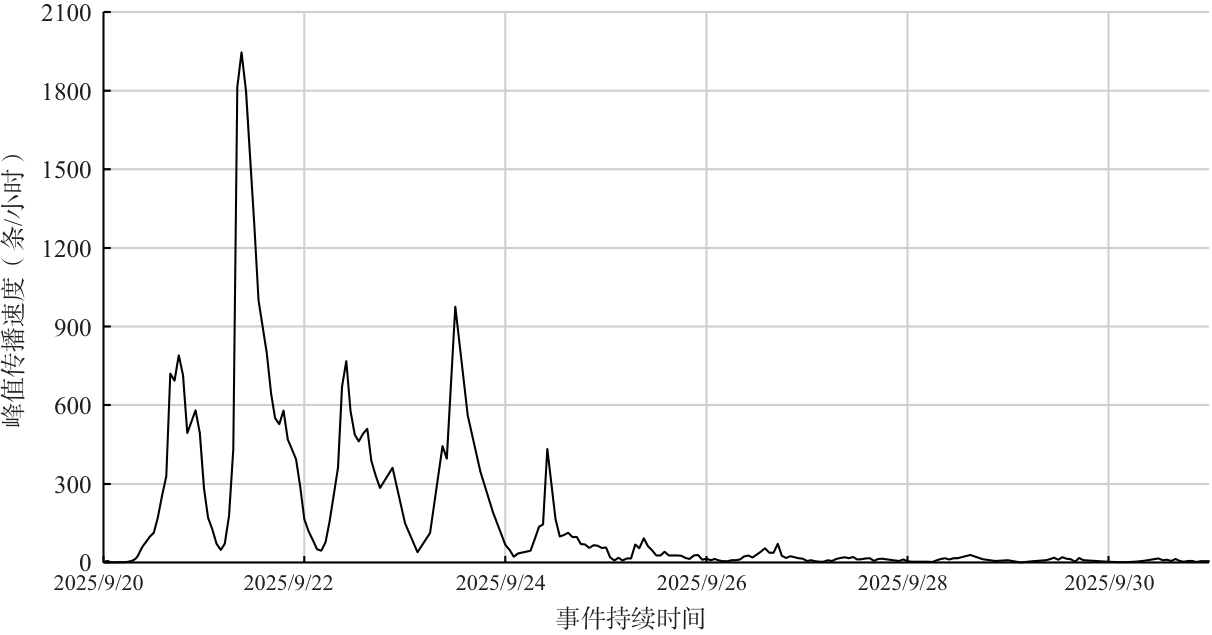
通过八爪鱼采集器抓取新浪微博平台上与“始祖鸟喜马拉雅烟花事件”相关的博文,采集时间跨度从2025年9月20日11:05至9月30日22:24,涵盖从事件首次爆发到舆情热度衰减至基线水平的全过程数据,最终爬取相关博文及评论共11 692条。
知微事见是一个全面的互联网热点事件聚合平台,提供深度的事件真相解读和动态追踪分析。本研究借助知微事见平台,得到了该事件在微博平台的传播趋势[21],见图2。
图2 事件传播趋势

Figure 2 Event propagation trend chart

3.1.2 数据处理

原始爬取数据与分析所需文本数据之间存在较大差异,需经系统性预处理方可保证数据质量。首先,根据舆论的时效性,选择性保留2025年9月20日至27日的评论数据。其次,删除重复条目,处理缺失值,清除网址链接、乱码及非文本表情符号等无关噪声。再次,构建“时序—语义”聚类法以增强上下文情感判断,即依据评论发布时间与文本内容相似性,构建虚拟讨论线程,模拟舆论场的群体互动效应,为模型理解复杂情感提供语义背景。经上述处理,最终保留了7 835条有效评论,其中,自然情感分布为:正向16.16%、中性17.73%、负向66.11%,呈现典型的企业负面舆情分布特征,负向评论占比显著高于正向与中性。最后,为避免示例过多引入噪声从而降低模型预测准确率,本研究基于少样本学习策略,采用两种方案构建少样本示例集。
(1)三阶段量化筛选流程。①针对原始文本,基于SnowNLP情感分析库对其预处理,仅保留置信度≥0.7的样本进入候选池;②采用随机分层抽样法,确保候选池中不同情感类别至少保留3个具有高度代表性的样本,且负向样本内部完整覆盖生态伦理谴责、品牌信誉损害、消费抵制倾向、责任追问诉求4类风险类型;③应用BERT-base-Chinese提取模型第12层的CLS(Classification)标记输出作为单条评论的整体语义向量,采用向量维度为768对候选文本向量化,计算两两余弦相似度,对于余弦相似度>0.5的样本,仅保留1个覆盖复杂表达的代表性样本,剔除其余冗余样本,通过迭代优化最终保留10个语义差异大、覆盖复杂表达(反讽、隐喻、口语化)及不同风险类别的高质量示例。
(2)双流程对照验证设计。针对少样本示例构建可能存在的工具偏好与偏差问题,本研究同时采用双流程对照验证设计,除SnowNLP构建的少样本学习方案,实验新增一套人工遴选与BERT语义去重的独立示例构建流程,最终形成10个语义差异显著、场景代表性强的少样本示例。
两种样本示例均覆盖了正向、中性及负向情感类别,其中负向情感类别完整涵盖4类核心风险类别,并确保在话题分布与表达方式上具有充分代表性,以辅助模型准确捕捉细微情感差异。通过将预处理后的数据与精选示例协同输入,有效提升了生成式人工智能在舆情分析任务中的上下文理解能力与情感分类精度,见表2。
表2 负面情感标注示例

Table 2 Negative sentiment annotation examples

评论内容 分词结果 情感标注依据 风险类别
这是致敬自然吗,是震慑自然吧,好傲慢的人类 致敬、自然、震慑、自然、傲慢的、人类 包含“震慑”和“傲慢”等负面性词汇,表达了对人类试图凌驾于自然之上的行为的强烈不满 生态伦理谴责
始祖鸟国内道歉和国外道歉说的完全不一样,双标品牌不值得信赖 道歉、双标、品牌、不值得、信赖 直接质疑品牌诚信形象,否定品牌价值观,对品牌公信力进行否定性评价 品牌信誉损害
看完这个视频我直接把始祖鸟旗舰店取关了,再也不会买 取关、旗舰店、再也不会买 使用“取关”和“再也不会买”,明确表达取消关注与拒绝购买的行为意向,具有典型的消费抵制特征 消费抵制倾向
到底有没有经过审批?相关部门应该介入彻查 审批、相关部门、介入、彻查 核心诉求为追问审批合规性并呼吁官方介入调查,属于责任追问类表达 责任追问诉求

3.1.3 提示词设计

在数据预处理基础上,本研究构建了两套融合提示工程与上下文学习的生成式人工智能情感分析提示词,用于开展对照实验:一为企业舆情风险识别导向的结构化提示词(结构化提示词组),作为本研究的主体实验方案;二为通用情感分类提示词(通用提示词组),作为对照基准。两套提示词均涵盖任务界定、核心参考信息、上下文学习与提示工程融合机制、输出要求核心组件,两套提示词框架对比见图3。
图3 提示词设计

Figure 3 Prompt design

3.2 模型性能对比

3.2.1 模型指标

本研究采用不同情感倾向的精确率、召回率、F1值以及模型整体准确率评估模型性能。
准确率(accuracy)反映模型在所有样本上的总体分类正确率,可综合评估模型的整体分类性能。在类别分布不均的舆情情感数据中,整体准确率有助于宏观衡量模型的稳健性与泛化能力,但需结合精确率、召回率与F1值进行综合解读,以防因类别不均衡导致指标高估。准确率的计算见公式(2)。
A c c u r a c y = ∑ k = 1 K     T P k N
其中, K为情感类别总数; T P k为第 k个类别的真正例数; N为测试集总样本数。
召回率用来衡量模型对真实情况的覆盖能力或灵敏度,其计算方式为模型正确预测为某一类别的样本数占所有真实为该类别样本总数的比例。对于企业而言,负面情感的高召回率是舆情风险管控的生命线,它确保了模型能够最大限度地捕捉到潜在的负面言论,防止关键风险信号被遗漏,从而避免企业因信息掌握不全而陷入被动、错失最佳的危机干预窗口。召回率的计算见公式(3)。
R k = T P k T P k + F N k
其中, R k为第k类情感的召回率, F N k是真实情感类别k但被模型漏判的样本数; T P k为模型正确预测情感类别为k的样本数。
F1值是精确率与召回率的调和平均数,用以综合评价模型在单一类别上的性能。在企业舆情管理的实际需求中,通常需要在“减少误报(高精确率)”和“防止漏报(高召回率)”之间寻求最佳平衡。F1值正是这一平衡点的量化体现。一个模型若为了捕捉所有负面评论而过度敏感,其精确率必然下降;反之,若过于保守则会导致召回率不足。因此,F1值是评估模型综合判别能力与实用性的关键指标。F1值的计算见公式(4)。
F 1 k = 2 × P k × R k P k + R k
其中 F 1 k为第k类情感的F1值, P k指对于特定类别 k的精确率; R k指对于类别k的召回率。

3.2.2 生成式人工智能模型评估与对照分析

为全面验证本文提出的生成式人工智能情感分析模型在企业网络舆情中的有效性,本研究设置了多维度对比实验。参与评估的模型涵盖三类。
(1)传统机器学习方法。以TF-IDF为特征提取的支持向量机(TF-IDF-SVM),采用线性核函数,正则化参数C设置为1.0,词向量维度为5 000,去除停用词,采用二元语法特征。
(2)深度学习方法。具有注意力机制的BiLSTM-CNN-Attention混合模型,隐层维度设置为128,CNN卷积核大小为3×1,卷积核数量为64,注意力机制采用加性注意力,训练轮次为20轮,批次大小为32,优化器为Adam,学习率为0.001,采用早停策略防止过拟合。
(3)生成式人工智能方法。包括Moonshot-Kimi-K2-Instruct、DeepSeek-V3.2-Exp和Doubao-Seed-1.6等主流大语言模型。
为验证生成式人工智能在情感分析领域的普适性,采用三种不同的生成式人工智能模型进行横向对比分析,为保证输出稳定性、降低随机性干扰,所有生成式模型温度参数统一设置为0.2,同时保证所有生成式人工智能实验流程与参数设置一致,并对三种大语言模型分别开展5次独立重复实验,确保实验结果的稳定性。此外,采用传统机器学习方法与深度学习方法作为基线模型对比,将正向、中性、负向情感比例设置为1:1:3。一方面,“始祖鸟喜马拉雅烟花事件”属于典型的企业负面突发舆情,公众情感以负向为主,原始数据中负向评论占比高达66.11%,能够更真实地模拟企业实际舆情监测场景,避免因样本分布过度均衡导致的模型性能高估;另一方面,适当提高负向样本比例有助于重点检验模型对负向情感的识别精度,聚焦本研究企业声誉风险识别的核心目标。
本研究结合舆情演化阶段进行双层分层随机抽样,从总样本中抽取20%构建1567条情感三分类测试集,该测试集数据通过双人双盲独立标注与专家仲裁的标准化流程获取,通过Kappa系数检验标注一致性,计算得Kappa=0.852。基线模型评估结果如表3所示,结构化提示词组与通用提示词组的生成式人工智能模型评估结果分别如表4与表5所示,便于两组对照条件的直观比较。
表3 深度学习与传统模型结果

Table 3 Results of deep learning and traditional models

模型 情感倾向 精确率 召回率 F1值 整体准确率
BiLSTM-CNN-Attention 0 0.883 7 0.870 8 0.877 2 0.773 7
1 0.768 2 0.780 8 0.774 5
2 0.758 3 0.666 7 0.709 6
TF-IDF-SVM 0 0.736 8 0.872 4 0.798 9 0.769 3
1 0.808 3 0.769 8 0.788 6
2 0.787 1 0.631 0 0.700 4
表4 结构化提示词生成式人工智能模型结果(SnowNLP示例)

Table 4 Results of GAI models with structured prompts (SnowNLP examples)

模型 情感倾向 精确率 召回率 F1值 整体准确率 整体准确率95% CI
Moonshot-Kimi-K2-Instruct 0 0.762 7 0.580 8 0.659 4 0.794 3 [0.785 8, 0.802 7]
1 0.880 4 0.911 8 0.895 8
2 0.731 6 0.825 9 0.775 9
DeepSeek-V3.2-Exp 0 0.668 8 0.819 9 0.736 6 0.802 5 [0.794 2, 0.810 9]
1 0.898 1 0.883 7 0.890 8
2 0.857 8 0.769 8 0.811 4
Doubao-Seed-1.6 0 0.909 5 0.624 3 0.740 5 0.842 2 [0.833 9, 0.850 5]
1 0.852 8 0.902 9 0.876 9
2 0.806 9 0.907 1 0.854 0
表5 通用提示词生成式人工智能模型结果(SnowNLP示例)

Table 5 Results of GAI models with general prompts (SnowNLP examples)

模型 情感倾向 精确率 召回率 F1值 整体准确率 整体准确率95% CI
Moonshot-Kimi-K2-Instruct 0 0.749 6 0.577 9 0.652 3 0.783 9 [0.776 6, 0.791 2]
1 0.882 0 0.890 4 0.885 9
2 0.728 5 0.824 2 0.773 3
DeepSeek-V3.2-Exp 0 0.672 9 0.798 0 0.730 1 0.794 0 [0.788 4, 0.799 5]
1 0.897 7 0.870 8 0.884 0
2 0.857 5 0.696 2 0.768 2
Doubao-Seed-1.6 0 0.905 9 0.635 0 0.746 5 0.836 3 [0.830 7, 0.841 9]
1 0.852 4 0.913 5 0.881 8
2 0.798 6 0.890 5 0.841 8
通用提示词组保持所有实验参数与测试集不变,仅将任务界定模块替换为通用情感分类设定,实验结果见表5。
对比表4与表5可知,三种大语言模型在结构化提示词条件下的整体准确率及负向情感识别指标均优于通用提示词。具体而言,Doubao-Seed-1.6整体准确率由通用提示词的83.63%提升至84.22%,提升0.59个百分点;Moonshot-Kimi-K2-Instruct由78.39%提升至79.43%;DeepSeek-V3.2-Exp由79.40%提升至80.25%。在负向情感F1值方面,三种模型在结构化提示词条件下亦均有不同程度提升。上述结果表明,结构化提示词通过场景化角色设定与双任务目标界定,在不显著增加实验复杂度的前提下,有效提升了模型在突发企业舆情场景下的情感识别性能,验证了场景化提示词设计策略的有效性。
进一步与基线模型比较,三种生成式人工智能模型(结构化提示词条件下)的整体性能在本实验中均优于传统机器学习与深度学习基线模型。在整体准确率方面,Doubao-Seed-1.6以84.22%位居第一,较TF-IDF-SVM(76.93%)与BiLSTM-CNN-Attention(77.37%)分别提升7.29个百分点与6.85个百分点。该结果证实,依托提示工程与上下文学习的协同赋能,生成式人工智能可更高效解析企业舆情中的复杂语义场景,有效突破传统模型在深层语义理解与上下文建模上的局限。
在情感分类细粒度性能上,Moonshot-Kimi-K2-Instruct在正向情感识别中F1值达0.895 8,表现突出;DeepSeek-V3.2-Exp在负向情感精确率上最优(85.78%),负向情感F1值为0.811 4,召回率为0.769 8,表明其对负向评论的判定置信度较高,误报率较低,适用于高精度负向风险预警场景;Doubao-Seed-1.6在负向情感识别上综合表现最优,召回率达0.907 1,F1值为0.854 0,表明其对负向评论的捕捉能力最强,漏判率最低,在企业舆情风险管控场景中具有最高的实用价值。
其中Doubao-Seed-1.6模型综合表现最优,该模型基于进阶Transformer架构,能够有效捕捉隐喻、反讽等复杂语义;同时,在结构化提示词中融入事件背景、关键时间节点、平台用户画像等多维语境信息,进一步引导模型将情感分类转化为上下文感知的自然语言理解任务。在结构化提示词的场景化角色设定引导下,模型对负向情感的语义边界判断更为精准,不仅可捕捉显性负面词汇,还能从表面上看似中性甚至正面的口语化反问表达中识别出隐含的讽刺与不满态度,实现对隐晦负向语义的有效识别。
对各模型开展5次独立重复实验,结果显示各组模型整体准确率的轮次间波动均较小,表明实验具备良好的可重复性与结果稳健性。
在结构化提示词组的输出结果中,模型在完成情感三分类的同时,对判定为负向的评论输出企业声誉风险类型标签,三种大语言模型的识别结果见表6。
表6 企业声誉风险类别比例 (%)

Table 6 Proportions of Corporate Reputation Risk Categories

模型 生态伦理谴责 品牌信誉损害 责任追问诉求 消费抵制倾向 其他风险
Doubao-Seed-1.6 14.33 43.84 12.84 23.46 5.53
DeepSeek-V3.2-Exp 14.65 44.27 11.89 23.25 5.94
Moonshot-Kimi-K2-Instruct 14.76 42.46 15.71 22.29 4.78
平均比例 14.58 43.52 13.48 23.00 5.42
三种模型的风险类型分布呈现高度一致性,平均来看,品牌信誉损害类评论占比最高;消费抵制倾向占比居次,表明此次舆情已从情感表达层面向行为意向层面发生实质性转化,公众不满情绪已具象化为取消关注、拒绝购买等可量化的市场行为威胁,对品牌的长期商业价值构成潜在冲击;生态伦理谴责与责任追问诉求占比相对较低但稳定存在。
三种模型在上述分布规律上的高度一致性,进一步验证了结构化提示词在声誉风险类型识别上的语义稳定性与跨模型可重复性,为企业针对不同风险类型制定差异化危机应对策略提供了可靠的数据依据。

3.2.3 模型稳健性评估

为避免SnowNLP工具的偏好与潜在偏差对示例质量产生系统性影响,本研究保持结构化提示词及所有实验参数不变,仅将SnowNLP筛选示例替换为由人工遴选结合BERT语义去重构建的独立示例集,对三种大语言模型分别开展5次独立重复实验,实验结果见表7。
表7 结构化提示词生成式人工智能模型结果(人工示例)

Table 7 Results of Generative AI Models (Manual Examples)

模型 情感倾向 精确率 召回率 F1值 整体准确率 整体准确率95% CI
Moonshot-Kimi-K2-Instruct 0 0.762 4 0.579 5 0.658 4 0.791 1 [0.787 3, 0.794 8]
1 0.882 3 0.909 3 0.895 6
2 0.730 8 0.821 9 0.773 6
DeepSeek-V3.2-Exp 0 0.669 4 0.814 7 0.734 9 0.801 2 [0.790 0, 0.812 5]
1 0.898 5 0.882 4 0.890 2
2 0.857 6 0.770 0 0.811 4
Doubao-Seed-1.6 0 0.907 7 0.617 3 0.734 7 0.841 2 [0.838 1, 0.844 3]
1 0.857 3 0.886 9 0.871 7
2 0.806 5 0.900 4 0.850 9
上述结果表明,更换人工筛选示例集后,三种大语言模型的各项核心指标波动较小,各项指标未出现明显偏移,正负向情感识别能力与分类稳定性基本保持一致。本研究前期采用的SnowNLP置信度筛选与BERT语义去重示例构建流程,未对大语言模型的情感分类性能引入显著系统性偏差,实验设计具备良好的鲁棒性。同时,人工筛选示例下各模型性能未出现明显提升或下降,进一步验证了本文提示工程框架、少样本学习策略与实验流程的可靠性,为后续结论的有效性提供了稳健性支撑。

4 结语/Conclusion

本研究聚焦生成式人工智能在企业网络舆情情感分析中的应用效能,以“始祖鸟喜马拉雅烟花事件”为实证场景,围绕提示工程、上下文学习与少样本学习展开标准化实验设计,验证了大语言模型在该实证场景下复杂舆情语义环境中的情感识别能力与稳定性。结果表明,生成式人工智能模型可有效识别网络俚语、反讽、隐喻等隐晦情感,其整体准确率、负向情感召回率与F1值等关键指标在本实验中均优于传统机器学习与深度学习基线模型,且面向企业风险识别的结构化提示词优于通用提示词,其中Doubao-Seed-1.6模型综合表现最优。
本文将生成式人工智能的提示工程与少样本学习范式系统性引入突发企业舆情情感分析,构建涵盖数据抽样、双盲标注、多模型对比、对照实验与稳健性检验的完整分析流程,有效降低了对大规模标注数据的依赖,提升了反讽、隐喻等复杂语义场景下情感判别的精准度与稳定性。研究设计面向企业声誉风险识别的结构化提示词,实现情感极性分类与声誉风险细分的单次推理—双任务一体化分析,使分析结果能够直接支撑企业舆情风险预警与精准危机响应的实际决策需求。实验结论证实,生成式人工智能能够在低干预、少样本条件下稳定完成舆情情感分类与风险细分任务,可为企业突发舆情监测、声誉风险管控提供轻量高效的技术方案,也为生成式人工智能在舆情智能分析领域的落地应用提供了可复用的方法参照。
本研究仍存在一定的局限性。其一,BiLSTM-CNN-Attention深度学习基线模型采用中文文本情感分析领域通用超参数,未开展网格搜索、随机搜索等精细化调优。该设置虽保障了实验的可复现性与执行效率,但可能导致基线模型未达到其理论最优性能。后续研究可通过自动化超参数搜索优化基线模型配置,进一步提升对比实验的严谨性。其二,本研究仅以单案例开展验证,方法在不同行业、不同类型突发企业舆情中的跨场景泛化能力有待进一步检验。
未来研究将继续深化以下三个方面:一是将情感分析与实时数据流结合,提升舆情动态追踪与预警能力;二是在现有极性分类基础上拓展至细粒度情绪识别,更精准刻画公众情感动因;三是完善多场景验证,进一步提升模型在不同行业、不同类型企业突发舆情中的泛化能力,推动生成式人工智能在企业舆情智能治理中更规范、更可靠地落地应用。
[1]
中国互联网络信息中心 .第57 次中国互联网络发展状况统计报告[EB/OL].[2026-08-18].https://www.cnnic.net.cn/n4/2026/0304/c88-11549.html.

China Internet Network Information Center .The 57th statistical report on the development of China's internet[EB/OL].[2026-08-18].https://www.cnnic.net.cn/n4/2026/0304/c88-11549.html.

[2]
刘茂辉 .生成式人工智能时代虚假信息治理的困境与出路[J].现代商贸工业,2025(21):204-206.

Liu Maohui .Dilemma and outlet of false information governance in the era of generative artificial intelligence[J].Modern Business Trade Industry,2025(21):204-206.

[3]
江长斌,何珂,黄英辉,等 .基于生成式人工智能的高校网络舆情评论回复研究[J].情报科学,2026,44(4):42-50.

Jiang Changbin, He Ke, Huang Yinghui,et al .Response of online public opinion comments in universities based on generative artificial intelligence[J].Information Science,2026,44(4):42-50.

[4]
张艳丰,黄亚婷,易臣何 .生成式人工智能情境下智能生成网络舆情风险测度实证研究[J].情报资料工作,2026,47(2):19-29.

Zhang Yanfeng, Huang Yating, Yi Chenhe .Empirical research on the measurement of intelligent generated network public opinion risks in the context of generative artificial intelligence[J].Information and Documentation Services,2026,47(2):19-29.

[5]
吴江,黄茜,贺超城,等 .基于引爆点理论的人工智能生成内容微博网络舆情传播与演化分析[J].现代情报,2023,43(7):145-161.

Wu Jiang, Huang Qian, He Chaocheng,et al .Propagation and evolution of public opinion in the outbreak of AIGC based on the theory of tipping point[J].Journal of Modern Information,2023,43(7):145-161.

[6]
梁循,王涵玉,张森森,等 .人工智能生成内容对舆情生态的影响、挑战和治理[J].管理世界,2025,41(6):129-158.

Liang Xun, Wang Hanyu, Zhang Sensen,et al .Impacts,challenges,and governance of artificial intelligence generated content on the public opinion ecosystem[J].Management World,2025,41(6):129-158.

[7]
Yi Jeonghee, Nasukawa T, Bunescu R,et al .Sentiment analyzer: extracting sentiments about a given topic using natural language processing techniques[C]//Third IEEE international conference on data mining.Melbourne: IEEE,2003:427-434.

[8]
伏虎 .多媒体网络突发事件舆情语义识别及危机响应研究[J].情报科学,2021,39(5):70-74,90.

Fu Hu .Research on semantic recognition and crisis response of multimedia network incidents[J].Information Science,2021,39(5):70-74,90.

[9]
邓君,孙绍丹,王阮,等 .基于Word2Vec和SVM的微博舆情情感演化分析[J].情报理论与实践,2020,43(8):112-119.

Deng Jun, Sun Shaodan, Wang Ruan,et al .Evolution analysis of Weibo public opinion emotion based on Word2Vec and SVM[J].Information Studies: Theory & Application,2020,43(8):112-119.

[10]
杨秀璋,郭明镇,候红涛,等 .融合情感词典的改进BiLSTM-CNN+Attention情感分类算法[J].科学技术与工程,2022,22(20):8761-8770.

Yang Xiuzhang, Guo Mingzhen, Hou Hongtao,et al .Improved BiLSTM-CNN+Attention sentiment classification algorithm fused with sentiment dictionary[J].Science Technology and Engineering,2022,22(20):8761-8770.

[11]
曹宇,李天瑞,贾真,等 .BGRU:中文文本情感分析的新方法[J].计算机科学与探索,2019,13(6):973-981.

Cao Yu, Li Tianrui, Jia Zhen,et al .BGRU:new method of Chinese text sentiment analysis[J].Journal of Frontiers of Computer Science and Technology,2019,13(6):973-981.

[12]
Huang Feiran, Wei Kaimin, Weng Jian,et al .Attention-based modality-gated networks for image-text sentiment analysis[J].ACM transactions on multimedia computing,communications,and applications(TOMM),2020,16(3):1-19.

[13]
曾子明,孙守强,李青青 .基于融合策略的突发公共卫生事件网络舆情多模态负面情感识别[J].情报学报,2023,42(5):611-622.

Zeng Ziming, Sun Shouqiang, Li Qingqing .Multimodal negative sentiment recognition in online public opinion during public health emergencies based on fusion strategy[J].Journal of the China Society for Scientific and Technical Information,2023,42(5):611-622.

[14]
张换香,李梦云,张景 .基于多模态信息融合的中文隐式情感分析[J].计算机工程与应用,2025,61(2):179-190.

Zhang Huanxiang, Li Mengyun, Zhang Jing .Implicit sentiment analysis for Chinese texts based on multimodal information fusion[J].Computer Engineering and Applications,2025,61(2):179-190.

[15]
Smales L A .Classification of RBA monetary policy announcements using ChatGPT [J].Finance Research Letters,2023,58(3): 104514.

[16]
Li Jinyuan, Li Han, Pan Zhou,et al.Prompting ChatGPT in MNER: Enhanced multimodal named entity recognition with auxiliary refined knowledge[PP/OL].V2.arXiv (2023-10-18)[2026-08-05].https://doi.org/10.48550/arXiv.2305.12212.

[17]
陈郅睿,陆雪松.基于开源代码大语言模型提示的学生代码修复[J].华东师范大学学报(自然科学版),2024(5):93-103.

Chen Zhirui, Lu Xuesong .Prompting open-source code large language models for student program repair[J].Journal of East China Normal University(Natural Science),2024(5):93-103.

[18]
刘华玲,张子龙,彭宏帅 .面向闭源大语言模型的增强研究综述[J].计算机科学与探索,2025,19(5):1141-1156.

Liu Hualing, Zhang Zilong, Peng Hongshuai .Review of enhancement research for closed-source large language model[J].Journal of Frontiers of Computer Science and Technology,2025,19(5):1141-1156.

[19]
江长斌,陈子涵,黄英辉,等 .基于ChatGPT的高校突发事件网络舆情情感分析研究[J].数字图书馆论坛,2025,21(6):53-62.

Jiang Changbin, Chen Zihan, Huang Yinghui,et al .Sentiment analysis of network public opinion in university emergencies based on ChatGPT[J].Digital Library Forum,2025,21(6):53-62.

[20]
殷芝玲,石晓雪,黄晓,等 .生成式人工智能技术的舆论动态与公众认知演化——基于ChatGPT的微博舆情研究[J].知识管理论坛,2025,10(4):335-347.

Yin Zhiling, Shi Xiaoxue, Huang Xiao,et al .Public opinion dynamics and public cognition evolution of generative artificial intelligence technology——a study on Weibo public opinion based on ChatGPT[J].Knowledge Management Forum,2025,10(4):335-347.

[21]
知微事见 .始祖鸟喜马拉雅烟花事件传播趋势[EB/OL].[2026-08-18].https://ef.zhiweidata.com/event/b95a4928a914870710092795/trend.(Zhiwei Shijian.Communication trend of the Arc'teryx Himalayan fireworks event[EB/OL].[2026-08-18].https://ef.zhiweidata.com/event/b95a4928a914870710092795/trend.)

Options
Outlines

/

〈 〉