Research on a Domain-Adaptive Large Language Model Fine-Tuning Framework for Dynamic Rumor Detection

  • Guo Yan ,
  • Wu Yifan ,
  • Yang Xianghao
Expand
  • School of Management, Shanghai University of Engineering Science, Shanghai 201620
Yang Xianghao, Professor, PhD, Master's Supervisor, E-mail: .

Guo Yan, Master's Degree;

Wu Yifan, Master's Degree.

Received date: 2026-04-25

  Online published: 2026-08-17

Abstract

[Purpose/Significance] Faced with emergent online rumors, large language models are restricted by static knowledge boundaries and fail to produce accurate judgments. Traditional static recognition schemes lack real-time fact-checking capability and cannot adapt to emerging and diversely expressed new rumors. This study designs and implements an integrated retrieval-learning dynamic rumor recognition paradigm to improve the model's recognition accuracy for newly emerging rumors and facilitate automatic governance of online public opinions. [Method/Process] Taking the fine-tuned Qwen3-8B as the base model, this study constructed a three-category discrimination mechanism including rumor, non-rumor and unknown. If the input information was judged as unknown by the model, the system automatically activated the Web search engine to capture evidence from authoritative sources, and took the retrieved results as real-time context for the model to conduct secondary accurate evaluation. The system structurally stored every successful query, supporting evidence and discrimination record to build an incremental sample set. Lightweight low-rank adaptive fine-tuning technology was adopted to periodically update the base model, so as to realize the integrated coordination of retrieval augmentation and continual learning, and form a complete closed loop of real-time verification, sample accumulation and model iteration. [Result/Conclusion] Experimental results show that the proposed method achieves excellent performance in the rumor recognition task, with an F1-score of 0.96 and an FTCA index of 94.8, which is significantly better than many mainstream baseline models. When dealing with sudden and novel rumors, it can effectively reduce the proportion of unknown judgments and presents favorable stability and practicability. It can provide technical references for the intelligent identification of dynamic online disinformation, and also offer new ideas for optimizing retrieval-augmented rumor detection models.
Cite this article

Guo Yan , Wu Yifan , Yang Xianghao . Research on a Domain-Adaptive Large Language Model Fine-Tuning Framework for Dynamic Rumor Detection[J]. Knowledge Management Forum, 2026 , 11(4) : 333 -344 . DOI: 10.13266/j.issn.2095-5472.2026.028

随着社交媒体与生成式人工智能的深度融合,网络谣言呈现出主题跨领域、传播即时性强、内容变体形式多的新特征,虚假信息可在数小时内完成跨平台扩散,对公共政策执行、社会秩序稳定及公众认知判断造成系统性冲击[1]。作为网络空间治理的核心环节,谣言识别已从传统人工核查转向智能技术驱动的自动化研判,但突发谣言的时效性与模型知识的静态性、复杂谣言的语义模糊性与识别技术的单一性之间的矛盾日益凸显[2]。从情报学视角看,谣言识别可视为动态情报服务在网络舆情治理中的具体应用,其关键在于实现情报获取、处理、分析与应用的快速衔接。然而,现有研究尚缺乏兼顾即时响应与持续演化能力的整体解决方案[3],构建适配动态舆情环境的智能谣言识别机制具有显著的理论价值与现实意义。
国内外相关研究主要沿3条技术路径展开,并取得了一定进展。①在谣言传播模型研究方面,学者借鉴流行病学理论提出易感—感染—恢复(susceptible-infected-recovered,SIR)等传播模型并结合博弈理论分析扩散机理[4],但此类方法侧重传播网络结构,对文本语义与内容真实性的刻画能力有限。②在基于深度学习的谣言检测研究中,卷积神经网络(convolutional neural network,CNN)、长短期记忆网络(long short-term memory,LSTM)、图卷积网络(graph convolutional network,GCN)等模型通过多维度建模在特定数据集上取得了较高精度[5],但对大规模标注数据依赖较强,面对突发谣言与对抗性伪造场景时泛化能力不足[6]。③在事实核查等任务中,大语言模型凭借零样本推理与复杂语义理解能力展现出应用潜力[7],但存在知识更新滞后与领域适配性不足等问题[8]。总体来看,现有研究尚未在即时推理、动态知识补全与模型持续演化之间形成有效协同[9],构建具备自更新能力的谣言识别智能体框架已成为重要发展方向[10-11]。
在此基础上,本研究提出一种检索与学习一体化的动态谣言识别框架,具体包括:构建“谣言—非谣言—未知”三段式判别机制,结合检索增强生成(retrieval-augmented generation,RAG)技术实现突发谣言的即时研判。设计动态自增长谣言知识库,通过语义分块与混合检索策略提升知识服务效率;基于低秩自适应(low-rank adaptation,LoRA)技术构建轻量化微调框架,实现模型知识的持续更新;引入链式思考(chain-of-thought,CoT)推理机制,增强识别结果的逻辑透明度。
本研究的边际贡献体现在3个方面:①提出“即时响应+持续进化”双驱动的谣言识别闭环架构,拓展了传统静态模型的应用边界;②构建多源异构动态数据体系与谣言主题分类框架,引入对抗性数据增强策略提升模型鲁棒性;③将情报循环理论融入模型设计,为网络谣言动态治理提供可解释性技术路径。

1 领域自适应谣言识别框架/A domain adaptive rumor identification framework

1.1 框架设计理念

随着生成式人工智能和社会化媒体的双重演化,谣言传播呈现主题跨域、时效敏感和内容变体化等新特征,现实场景中信息真伪判断的难度显著提升[12]。传统基于静态语料训练的谣言识别模型虽然在特定测试集上表现良好,但在面对突发事件、新兴议题或语义伪装内容时性能急剧衰减,难以应对真实世界中的持续变化情境[13]。纯粹依赖RAG的方法虽能动态获取外部证据,但每次推理都需重新检索,无法将已验证知识沉淀为模型自身能力,且检索质量高度依赖外部信源的可用性。本研究提出的领域自适应微调方案通过将成功的检索—验证—判定过程转化为增量训练数据,使模型逐步将外部知识内化为自身参数,实现从被动查证到主动识别与持续进化的范式转变。该框架的核心思想在于构建“即时响应+持续进化”双驱闭环,使模型同时具备实时求证、可解释推理与经验沉淀能力。
该框架体现出3个关键理论理念。①主动求证而非被动回答。当模型置信度不足时,以“未知”作为中间状态,避免幻觉输出,并主动触发外部证据链路。②推理过程即知识生产过程。每一次谣言识别的完整流程被视作软标签生成机制,使推理链比训练数据更具针对性和实战价值。③可持续进化的低成本机制。通过轻量化微调策略周期性地将增量知识内化,使模型能力随时间累积而不断进化,无需频繁依赖大规模重新训练。从理论根基来看,上述设计与情报循环理论具有内在对应关系。经典情报循环包含规划、收集、处理、分析、分发与反馈6个环节:规划环节对应三段式判别机制设计;收集环节对应动态知识获取层的检索流程;处理与分析环节对应数据清洗、指令生成及CoT循证推理;分发环节对应结构化响应输出;反馈环节对应增量样本回流与LoRA持续微调。这一对应关系表明,本框架也是情报循环理论在智能谣言治理场景中的实践性延伸。

1.2 框架总体架构

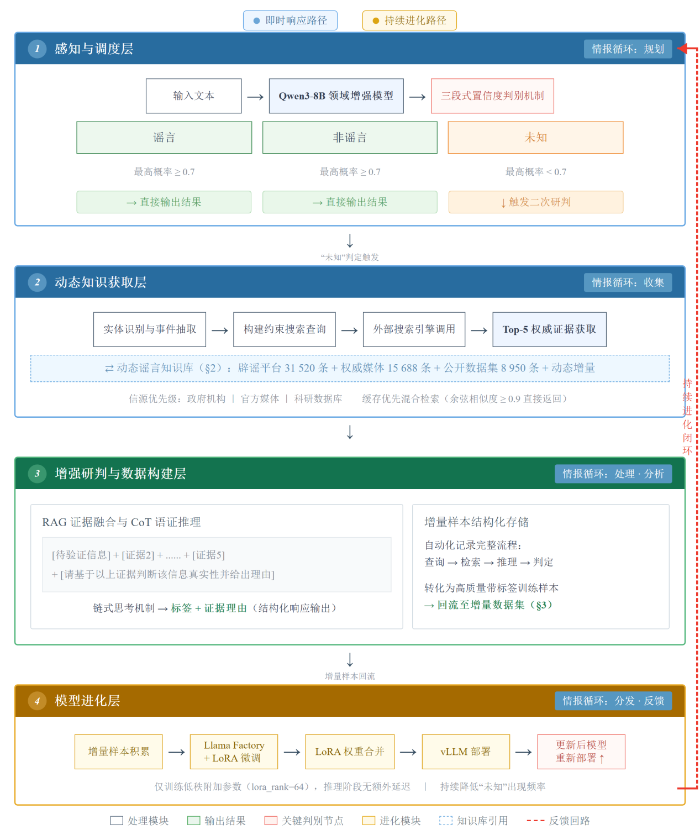
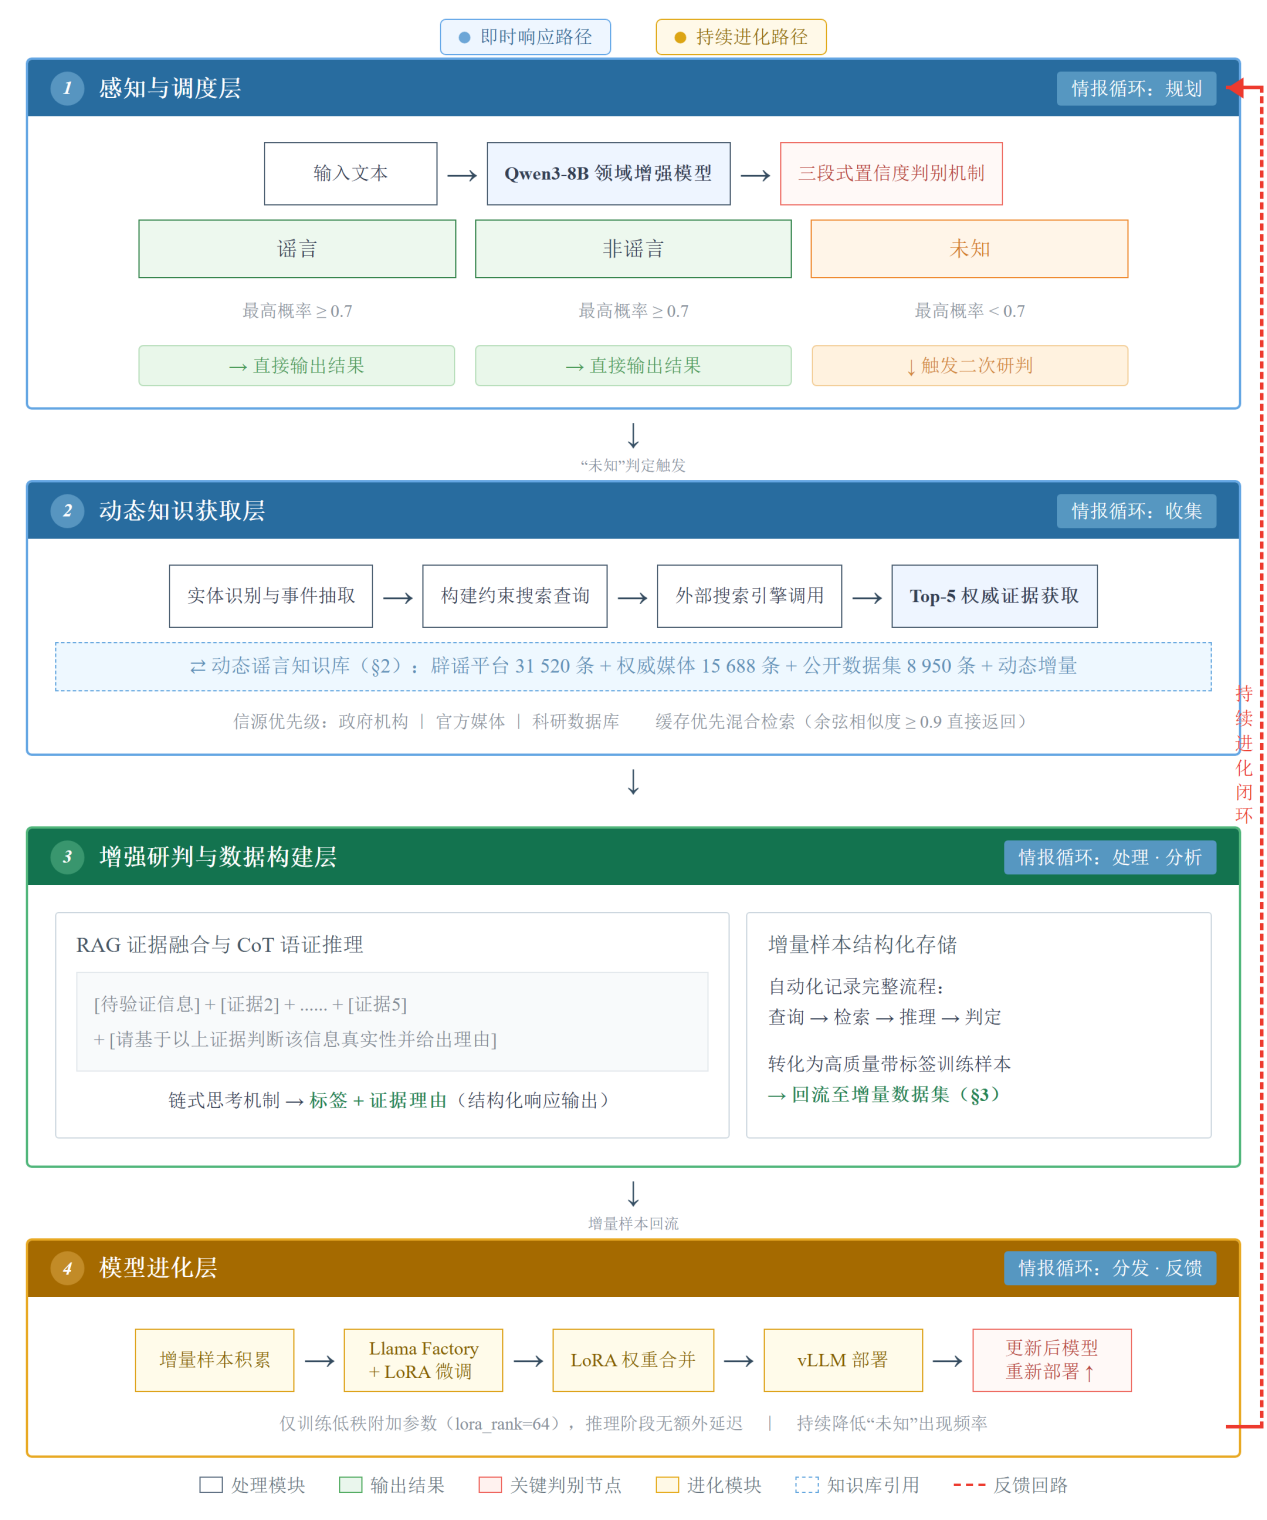
框架的整体设计遵循信息系统工程中的分层解耦与数据流导向原则,通过模块化方式将即时研判能力与长效知识沉淀机制相结合,构建一个具备循环更新与扩展能力的闭环智能体系。总体架构见图1。
图1 领域自适应谣言识别架构

Figure 1 Domain-adaptive rumor recognition architecture

(1)感知与调度层。在体系的最前端,系统首先对输入信息进行初始识别与任务分流。通过引入以Qwen3-8B为基础的领域增强模型,系统建立起“谣言—非谣言—未知”的三段式置信度判别机制。该机制的核心在于设置“未知”中间缓冲态,避免因不确定性引发的事实幻觉风险。模型对每条输入输出3个类别的概率分布,当最高概率低于置信度阈值(本研究设为0.7)时标记为“未知”并分流至下游模块。
(2)动态知识获取层。当上游模型判定某一输入属于“未知”时,系统随即进入动态知识获取流程,以解决静态模型难以应对知识时效性和突发性事件的问题。该流程首先对原始文本进行实体识别、事件抽取等处理,构建出约束明确的搜索查询;随后自动调用外部搜索引擎,并依据预设的信源权威性优先级,实时从政府机构、官方媒体及科研数据库等渠道获取增量事实证据[14]。
(3)增强研判与数据构建层。在完成外部证据获取后,系统进入增强研判阶段,这是实现实时决策与持续学习的关键环节。一方面,系统将动态检索得到的证据与原始输入进行语义融合,构造成结构化提示信息。系统将检索到的Top-5证据文本与原始输入按照“[待验证信息] + [证据1] + [证据2] + …… + [请基于以上证据判断该信息真实性并给出理由]”的模板拼接为结构化提示,通过检索增强生成技术输入模型,从而引导大模型在链式思考机制下进行基于证据的推理并给出最终判定。另一方面,系统会对整个“查询—检索—推理—判定”的处理过程进行自动化记录,将成功解决初始“未知”问题的完整推理流程转为结构化、带标注的高质量训练样本。这些样本直接来源于实际应用场景,往往集中反映模型的薄弱点与知识空白,因而能够更有针对性地支撑后续模型的能力提升。
(4)模型进化层。在增量样本持续积累的基础上,框架进入模型进化阶段,以实现模型对领域知识的长期吸收与不断适配。本研究采用Llama Factory框架结合LoRA微调方法,通过训练极少量附加参数将新知识内化为模型稳定能力,持续降低“未知”出现频率。微调后模型重新部署至系统入口,形成完整知识闭环。

2 动态谣言知识库与领域数据构建/Construction of dynamic rumor knowledge base and domain data

作为领域自适应微调框架的知识基础设施,本研究首先构建了一个具备动态自增长能力的多源谣言知识库。该知识库不仅是静态信息的集合,更是一个在与大模型交互中持续进化的智能系统。通过检索增强生成(RAG)技术与模型深度融合,知识库能够提供动态、可信的外部知识支撑。

2.1 多源异构数据采集与整合

谣言知识库的数据来源是静态权威数据导入与动态增量学习的结合体,确保了知识的权威性、时效性与持续成长性。其中,官方辟谣平台数据为核心数据,源自中国互联网联合辟谣平台,通过定向爬虫技术,系统性地整合了该平台发布的辟谣信息、事实核查报告及相关政策解读,共计31 520条[15]。该平台由中央网信办主管,数据经官方审核,事实可靠性高,适合作为知识库的基础锚点。权威媒体事实核查内容聚合了来自新华社求证栏目、人民网人民求真等主流媒体的事实核查板块内容,共计15 688条[15],以增强知识库对动态舆情的响应能力[16]。公开数据集引入了学界公开发布的中文谣言检测数据集Weibo 21,共计8 950条[17],丰富了模型测试的样本形态。动态学习增量数据是知识库自增长的关键,模型成功研判的新记录(含原始信息、检索证据与判别结果)将结构化存入知识库,持续填补知识盲区。本研究相关数据的获取与整理时间截至2025年12月1日。
为保证质量,本研究采用4级过滤机制:①规则层过滤无效或重复信息;②语义层识别信息完整性及文本冲突;③逻辑层剔除逻辑矛盾信息;④脱敏层对敏感信息进行匿名化处理[18]。

2.2 谣言主题分类体系构建

本研究利用自然语言处理技术对数据集进行主题建模,构建了涵盖9个类别的谣言主题分类体系(表1)。在实际运行中,主题分类体系在两个环节发挥支撑作用:①在检索阶段,系统根据输入文本的主题标签优先从对应类别的知识库分区中检索证据,缩小检索范围并提升匹配精度;②在推理阶段,主题标签作为上下文约束信息注入提示模板,帮助模型在特定领域知识框架内进行判断,降低跨领域语义混淆导致的误判风险。
表 1 谣言主题分类体系

Table 1 Rumor topic classification system

谣言主题类别 典型谣言特征/关键词
社会安全 紧急通知、人贩子偷小孩、有毒气体泄漏、公共场所安全隐患、暴力事件夸大
健康养生 食物相克、致癌警告、神奇疗法、偏方治大病、疫苗恐慌、养生伪科学
科学常识 超自然现象、伪科学解读、反智言论、地球异象、技术威胁论
公共政策与民生 燃油/电价调整、虚假补贴、新规误读、拆迁赔偿、社保/医保政策变动
食品安全 人造鸡蛋、塑料紫菜、无根豆芽、黑心作坊、食品添加剂恐慌、季节性水果谣言
历史文化 历史名人伪言论、历史事件杜撰、民族英雄污名化、传统文化曲解、伪造考古发现
财经商贸 公司破产、名人“被代言”、经济崩溃论、虚假理财产品、股市/楼市预测
国际关系 战争夸大、外交冲突杜撰、针对特定国家/种族的虚假负面新闻、海外华人安全
娱乐八卦 明星“被去世”、虚假恋情/绯闻、剧组内幕夸大、艺人关系不和、作品抄袭杜撰

2.3 知识库的向量化与检索优化

本研究采用语义文本分块策略将长文本切分为语义完整的向量化文本块,通过Qwen3-0.6B-Embedding模型向量化后存储于OpenSearch向量数据库中。
为兼顾响应效率与计算成本,本研究设计了缓存优先的混合检索机制。系统首先将查询向量化后执行近似最近邻搜索,若命中高相似度(余弦相似度>0.9)的已标注记录则直接返回。未命中时切换至RAG流程,检索Top-5相关文本块与权威证据,构建结构化提示后提交至Qwen3-8B进行循证推理。判定结果结构化存入增量数据层,形成“应用—学习—再应用”的动态反馈闭环。

3 领域自适应微调数据集的构建/Construction of domain adaptive fine-tuning datasets

在知识库构建完成的基础上,本章进一步构建领域自适应微调所需的高质量训练数据集。该数据集包括推理验证数据集、结构化指令生成数据以及对抗性增强样本,旨在模拟真实场景下的网络谣言环境,并提高模型在未知信息与复杂干扰条件下的识别能力。为便于理解本研究涉及的多类数据之间的关系,表2对各数据集的定位、来源与规模进行了汇总。微调训练集、验证集与测试集按8:1:1比例从约8 000条结构化指令数据中划分。推理验证数据集与微调数据完全独立,用于评估模型在未知场景下的泛化表现。
表 2 本研究数据集总体构成

Table 2 The overall composition of the dataset in this research

数据集名称 定位与用途 数据来源 规模
谣言知识库 RAG检索的知识底座 辟谣平台+权威媒体+Weibo21+动态增量 约56 000条(初始)
微调训练集 LoRA微调的训练数据 辟谣平台+权威媒体+Weibo21+动态增量 约6 400条(80%)
微调验证集 训练中超参数调优 辟谣平台+权威媒体+Weibo21+动态增量 约800条(10%)
微调测试集 训练后的离线评估 辟谣平台+权威媒体+Weibo21+动态增量 约800条(10%)
推理验证数据集 独立泛化能力评估 2025年8—11月时效性采集+干扰数据 14 000条

3.1 推理验证数据集构建

为确保数据对模型完全未知,本研究将时效性数据采集窗口设置在2025年8月7日至2025年11月1日。数据来源覆盖主流社交媒体、新闻聚合平台及论坛,利用基于Playwright的智能爬虫框架进行抓取。关键词库在覆盖常规辟谣与网络传播高频词汇的基础上,结合自然语言处理(natural language processing,NLP)技术动态追踪热点事件与高频讨论议题,以保证数据对未来事件具有代表性。采集的数据共8 000条,覆盖健康养生、科技、公共政策、娱乐等多个领域(表3)。
表3 时效性谣言数据关键词统计

Table 3 Statistics of keywords in timely rumor data

关键词 数量/条 占比/% 关联类型
#新型混合型流感 960 12 健康养生(一种不存在的新病毒传播,引发公众恐慌)
#AI虚拟人失控 880 11 科学常识/社会安全(某公司发布的AI伴侣攻击行为的虚假新闻)
#数字钱包强制升级 800 10 公共政策与民生(传闻央行数字货币钱包需强制升级)
#天问四号新发现 720 9 科学常识(杜撰中国火星探测器发现外星生命迹象的虚假)
#国庆高速新规 640 8 公共政策与民生(捏造国庆期间高速收费或限行的虚假政策)
#某某明星被封杀 560 7 娱乐八卦(针对当红艺人编造的虚假负面新闻)
#超级蔬菜致癌 560 7 食品安全(谣传某种通过基因技术改良的新型蔬菜会导致癌症)
#开学军训新模式 480 6 社会安全(夸大或捏造学校军训中出现的极端或危险训练项目)
#个人碳税开征 400 5 财经商贸/公共政策(谣传国家将开始对个人征收“碳排放税”)
其他零散谣言 2 000 25 (覆盖历史、国际关系等其他主题的零散、长尾谣言)
总计 8 000 100
为了测试模型在复杂环境下的鲁棒性,本研究构建了高迷惑性干扰数据集,包含未来预测、未经证实的个人爆料、强情感观点陈述、模糊事实的个人经历以及反讽或玩梗文本等典型形式。该数据集共6 000条,约占微调数据集总量的43%。
本研究设计了以Qwen3-8B为核心的多阶段数据清洗流程:首先,通过零样本分类(指令模板为“请判断以下文本是否与谣言识别相关”)过滤低价值内容,保留率约75%;其次,评估文本逻辑连贯性并抽取关键信息,实现结构化表示;最后,通过命名实体识别进行匿名化处理,构建高质量的训练与验证数据集。

3.2 结构化指令生成

结构化指令生成的目标是将清洗后的事件文本转化为可直接用于训练的“instruction-input-output-system”统一格式指令样本。为确保数据质量,本研究采用基于Qwen3-8B的自动生成策略,并结合链式思考(chain-of-thought,CoT)推理过程,以确保生成内容具备逻辑严谨性、事实可验证性与可审计性。指令模板设计遵循任务定义清晰、结构形式统一、理由可解释、便于质量审核4项原则。
本研究采用基于CoT的推理生成策略以降低幻觉率并提升可解释性。模型结合内部知识与权威信息对输入论断作出初步判断(真实/虚假/无法确认),并围绕判定结果给出论据支撑,最终整合为“标签+基于证据的简明理由”的统一格式输出。

3.3 对抗性数据增强

本研究采用语义保持的对抗生成策略,扩充原始谣言文本样本。
语义扰动注入使用Qwen3-0.6B-Embedding语义编码器对原始句子进行最小扰动重构,生成语义连贯的变体文本,并对高敏感领域样本插入预设谣言触发模式。改写次数服从参数为 ⋋ = 0.3的泊松分布,确保每条增强样本至少包含2个扰动特征。为避免语义偏移,对扰动幅度进行约束,见公式(1)。
∥ E ( x ) - E ( x ' ) ∥ 2 ≤ ϵ , ϵ = 0.25
其中, E ( ⋅ )为文本语义编码器,   ϵ控制重构文本与原文本的语义距离上限。
在主题关联映射方面,构建谣言主题与语义表达模式的关联矩阵,通过多头注意力机制计算文本片段与谣言知识库中典型谣言案例的语义相似度,选取相似度高于 γ = 0.9的样本作为对抗重构参考。

3.4 推理与回答生成

本研究的推理与回答生成模块旨在实现可解释谣言识别,并与检索增强模块和增量知识构建机制协同工作。
针对输入文本Query,基于Qwen3-8B模型提取多维判别信号,包括历史知识覆盖度 K、权威源匹配度 A、语义模糊度 U以及时间敏感性   T。风险指数 R通过加权 Sigmoid 函数计算,见公式(2)。
R = σ ( w k K + w a A - w u U + w t T )
其中, σ为 Sigmoid 激活函数, w k ,   w a , w u , w t分别为特征 K ,    A ,   U ,   T对应的可学习权重参数,通过历史验证数据集进行优化。随后,采用改进向量检索算法(基于 OpenSearch 向量库)计算文本与动态谣言知识库中相关记录的语义相似度 θ,见公式(3)。
θ = c o s ( v X ,   v D )
最后,结合风险指数 R和语义相似度 θ,依据以下规则做出最终判断:当语义相似度>0.9且风险指数超过阈值时判定为谣言;当语义相似度>0.9但风险指数较低时判定为非谣言(通常为辟谣类信息);其余情况判定为未知,触发动态检索层进行在线证据获取与辅助判断。
判定完成后,模型输出标准化结构化响应,包含核心判断标签(谣言/非谣言/未知)及基于CoT推理的证据理由,使每次输出都构成一份包含完整逻辑链条的事实核查报告。

3.5 数据质量检测与审核

本研究采用自动化检测与人工复核相结合的审核机制。首先利用Qwen3-8B对全部数据进行自动化扫描,交叉验证标签准确性与推理逻辑完整性;随后随机抽取10%—15%的样本交由领域专家进行双盲评审,重点评估标签精确度与理由合理性。只有同时通过自动化检测和人工复核且一致性得分达标的数据才被最终采纳,最终构建了约8 000条高质量训练样本。

4 模型微调与实验分析/Model fine-tuning and experimental analysis

在完成知识库与训练数据集的构建后,本章进入框架的核心环节,即基于Llama Factory框架与LoRA技术的领域自适应微调,并通过对比实验验证框架的有效性。该方案通过指令对齐向模型注入结构化响应生成与领域知识判断能力,微调后将LoRA模块与原模型权重整合生成可部署的推理模型。微调目标为最小化交叉熵损失。
假设微调数据集为 D = { T i , l i } i = 1 N     ,其中 T i  是第 i条文本, l i是对应的真实的标签。对于一个给定的文本 T i,模型 F(参数为 θ)输出其为谣言的概率 P = l r u m o r | T i ; θ。
则HRIF的损失函数 L S F T定义为:
$\begin{aligned}L_{S F T}(\theta)=- & \frac{1}{N} \sum_{i=1}^{N}\left[y_{i} \log \left(P\left(l_{r o m o r} \mid T_{i} ; \theta\right)\right)+\right. \\& \left.\left(1-y_{i}\right) \log \left(1-P\left(l_{r o m o r} \mid T_{i} ; \theta\right)\right)\right]\end{aligned}$
其中, y i=1表示 l i = l r u m o r, y i=0表示 l i = l t r u e。通过梯度下降等优化算法最小化 L   S F T,模型参数 θ得以更新,从而更好地拟合谣言文本的语言特征与逻辑模式。

4.1 领域自适应微调方案

本方案选择Qwen3-8B作为基座模型,该模型在中文语料上经过深度优化,8B参数规模在保证推理能力的同时可在标准硬件下高效微调与部署。
为提高微调效率并降低计算成本,本研究采用Llama Factory框架配合LoRA技术。微调策略包括:①指令微调,将数据转化为System/User/Assistant格式,训练模型生成“标签+证据理由”输出;②CoT注入,增强复杂语义推理能力;③LoRA参数高效微调,仅训练低秩附加矩阵,推理阶段无额外延迟。
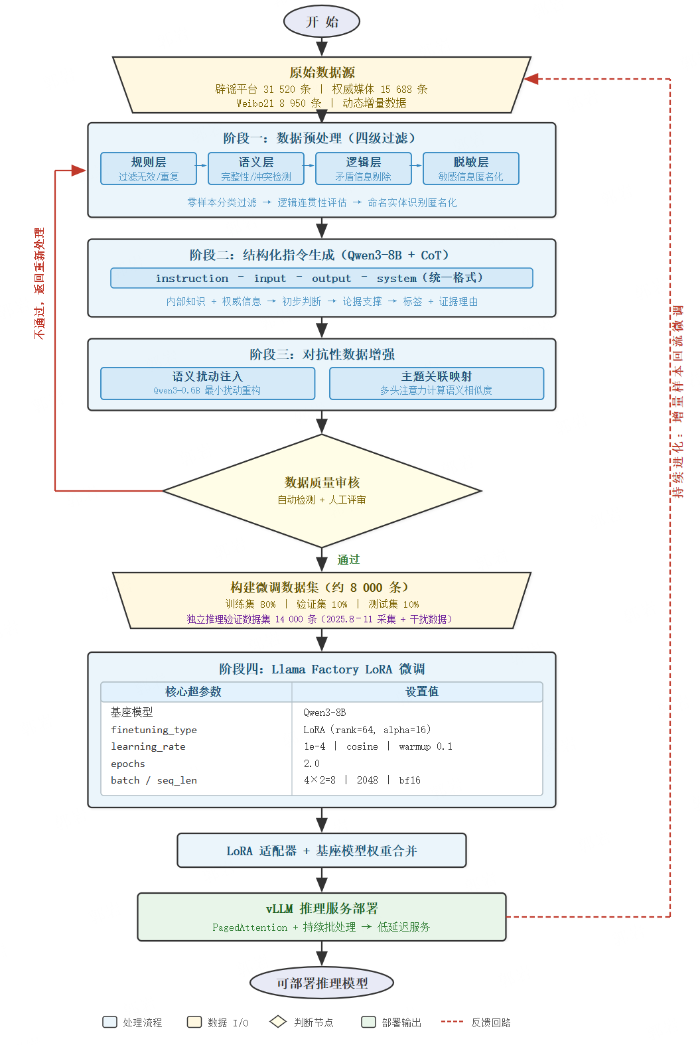
本研究利用Llama Factory的监督微调(supervised fine-tuning,SFT)指令微调模块,将第3部分构建的结构化数据集高效地转化为模型训练所需的格式,并对训练过程中的超参数进行精细化管理,从而实现了对模型行为的精准塑造。Llama Factory的监督微调训练流程见图2。
图2 Llama Factory的SFT训练流程

Figure 2 SFT training flow chart of llama factory

微调完成后,采用vLLM作为推理服务框架。vLLM通过PagedAttention算法和持续批处理机制实现高效显存管理与并发处理,将模型封装为低延迟的Web服务,满足动态谣言识别的即时响应需求。

4.2 实验设置

实验在AWS云服务器上完成,该服务器配备Intel Xeon Platinum 8488C处理器、64GB内存及NVIDIA L40S GPU(48GB显存),软件环境为PyTorch 2.7.0、Python 3.12.10及Llama Factory 0.9.1。在对基座模型Qwen3-8B进行指令微调时,关键的超参数设置见表4。
表 4 模型微调关键超参数设置

Table 4 Key hyperparameter settings for model fine-tuning

核心参数 值 说明
finetuning_type lora 训练方法:指定使用LoRA技术
lora_rank 64 模型容量:LoRA矩阵大小,平衡性能与效率
lora_alpha 16 学习强度:LoRA的缩放因子,调节更新幅度
learning_rate 1.0e-4 学习速率:权重更新的步长,影响收敛速度
num_train_epochs 2.0 训练轮次:数据集被完整训练的总次数
per_device_train_batch_size 4 批量大小:单次更新所使用的样本数量
gradient_accumulation_steps 2 梯度累积:用少量显存模拟更大的训练批量
lr_scheduler_type cosine 学习率策略:动态调整学习率的变化方式
warmup_ratio 0.1 训练预热:在训练初期稳定学习率
max_seq_length 2 048 文本长度:模型能处理的最大输入长度
bf16 true 混合精度:启用以加速训练并节省显存
seed 3 407 可复现性:固定随机种子,确保结果一致
实验数据集包括微调数据集和推理验证数据集,其中微调数据集是基于前章构建的结构化、匿名化、增强的谣言与干扰数据;推理验证数据集独立于训练数据,用于评估模型在未知、突发性谣言场景下的泛化能力。
为全面验证本研究提出的微调方案与动态识别框架的有效性,实验选取了4款当前业界主流的、参数规模相近的开源大语言模型作为基线进行对比,分别是LLaMA-3-8B-Instruct(Meta,通用对话与推理)、GLM-4-9B-Chat(智谱AI,中文原生优化)、Qwen2-7B-Instruct(阿里巴巴,强基线模型)及未微调的Qwen3-8B基座(用于衡量微调带来的性能增益)。
同时,为了全面、客观地评估模型在谣言识别任务上的综合性能,本研究设计了一套包含客观量化指标与主观质量评估的复合评价体系。主观质量评估方面,本研究邀请5名具有信息安全或自然语言处理研究背景的专家,对各模型的输出结果进行独立评分。评分采用1—5分的李克特量表,从3个维度展开:逻辑可解释性(推理过程是否清晰、证据引用是否恰当)、建议实用性(输出的防范建议是否具有可操作性)、语言专业性(表述是否准确规范、是否存在事实性错误)。每位专家独立完成评分,互不知晓彼此结果,最终得分取5位专家的算术平均值。客观量化指标采用标准的F1分数作为核心的二分类性能衡量指标,F1分数是精确率(precision)和召回率(recall)的调和平均值,能够综合反映模型在识别谣言/非谣言/未知标签时的准确性与完备性,其计算方法见公式(5)—公式(7)。
P r e c i s i o n    =   T P ( T P   +   F P )
R e c a l l    =   T P ( T P   +   F N )  
F 1 - S c o r e   =   2 * P r e c i s i o n * R e c a l l ( P r e c i s i o n   +   R e c a l l )
多分类准确率(fine-grained topic classification accuracy,FTCA)用于评估模型对不同谣言主题的分类识别能力。其计算方法见公式(8)。
F T C A = 1 N ∑ i = 1 N I y ^ ᵢ = = y ᵢ
其中,N为总样本数,ŷᵢ为模型对第i个样本的预测主题类别,yᵢ为该样本的真实主题类别。I(·)为指示函数,当预测正确时其值为1,否则为0。

4.3 结果与分析

实验从构建的推理验证数据集中划分出独立的测试集,该测试集与训练过程完全隔离,用于对本研究模型及所有基线模型进行统一评测。客观F1分数、FTCA(谣言主题分类准确率)与主观专家评分的最终结果见表5。
表5 各模型在动态谣言识别任务上的表现对比

Table 5 Performance comparison of various models in dynamic rumor recognition tasks

模型 F1分数 FTCA 逻辑可解释性 建议实用性 语言专业性
LLaMA-3-8B-Instruct 0.89 85.1 4.1 3.9 4.2
GLM-4-9B-Chat 0.88 86.5 4.0 3.8 4.4
Qwen2-7B-Instruct 0.90 87.2 4.2 4.0 4.3
Qwen3-8B (基座) 0.85 82.4 3.5 3.2 4.0
本研究模型 0.96 94.8 4.8 4.7 4.9

4.3.1 基线模型对比分析

从表5的结果来看,本研究模型在所有指标上均明显优于各基线模型。Qwen3-8B基座模型(未微调)的F1仅为0.85,与本研究模型相差0.11,FTCA相差12.4个百分点,这一差距直接反映了领域自适应微调的贡献。基座模型虽然具备较强的通用语义理解能力,但由于缺乏针对谣言识别任务的结构化输出训练和领域知识注入,在面对需要精确判断信息真伪并给出证据理由的任务时,输出质量明显不足,尤其在逻辑可解释性(3.5分)和建议实用性(3.2分)两个维度上与本研究模型差距最大,说明微调过程中CoT推理格式的注入对提升输出质量起到了关键作用。
在4个外部基线中,Qwen2-7B-Instruct表现最优(F1=0.90,FTCA=87.2),这与其在中文语料上的深度优化以及较强的指令遵循能力有关。LLaMA-3-8B-Instruct的F1为0.89,略低于Qwen2,主要原因在于LLaMA-3的预训练语料以英文为主,中文语料占比相对较低,在处理中文谣言中常见的隐喻、反讽、方言化表达等复杂语义时理解深度不足,导致部分样本出现误判。GLM-4-9B-Chat在FTCA上表现优于LLaMA-3(86.5 vs 85.1),得益于其对中文语境的原生优化,但其F1(0.88)反而略低,分析发现GLM-4在面对高迷惑性干扰数据(如强情感观点陈述、反讽文本)时,倾向于将非谣言内容误判为谣言,精确率偏低。总体而言,通用大模型的对话能力并不能直接迁移为谣言识别的专业判断能力,领域自适应微调是弥合这一差距的关键手段[19]。

4.3.2 消融实验分析

为量化各核心模块对整体性能的独立贡献,本研究设计了4组消融实验,分别去除RAG检索增强模块、增量学习机制、CoT数据格式以及同时去除RAG与增量学习(仅保留基础微调),结果见表6。
表6 消融实验结果

Table 6 Ablation study results

实验配置 F1分数 FTCA 逻辑可解释性
本研究完整模型 0.96 94.8 4.8
去除RAG检索增强模块 0.92 90.3 4.6
去除增量学习机制 0.90 89.1 4.5
去除CoT数据格式 0.94 93.2 4.3
去除RAG+增量学习 0.88 85.6 4.2
去除RAG检索增强模块后,F1从0.96下降至0.92,FTCA从94.8降至90.3。性能下降主要集中在推理验证数据集中的突发性谣言样本上,这些样本涉及的事件发生在2025年8月之后,超出了基座模型的知识截止时间(2025年6月),没有外部证据支撑时模型只能依赖内部知识进行推断,对于“#天问四号新发现”“#个人碳税开征”等全新话题的识别准确率下降尤为明显。这一结果验证了RAG模块在应对知识时效性挑战方面的不可替代性。
去除增量学习机制后,F1降至0.90,降幅达6个百分点,是所有单模块消融中影响最大的。进一步分析发现,在没有增量学习的情况下,模型在测试初期的表现与完整模型差距不大(前1 000条样本的F1差距仅为0.02),但随着测试推进,未知判定比例持续维持在较高水平而无法下降,导致整体性能逐步拉开差距。这说明增量学习机制的价值不在于即时提升,而在于通过持续积累使模型能力随时间递增,对于长期运行的谣言识别系统而言具有重要意义。
去除CoT数据格式后,F1仅小幅下降至0.94,但逻辑可解释性评分从4.8降至4.3,降幅达0.5分,是所有消融实验中该指标下降最显著的。分析发现,没有CoT格式训练的模型倾向于直接输出“谣言”或“非谣言”标签而不附带证据理由,或者给出的理由过于笼统(如“该信息不实”),缺乏具体的事实依据和推理链条。这表明CoT数据格式对模型的分类准确率影响有限,但对输出质量的可解释性和可审计性至关重要,而这恰恰是谣言识别系统在实际部署中获得用户信任的关键因素。
同时去除RAG与增量学习后,F1降至0.88,接近基线水平,证明了双驱机制的协同价值,RAG提供的实时证据与增量学习积累的领域知识之间存在互补关系。

4.3.3 各类谣言主题识别准确率分析

为评估模型在不同谣言主题上的识别表现,本研究按照表1的9类主题分类体系对测试集结果进行了分类统计,结果见表7。
表7 各类谣言主题识别准确率

Table 7 Recognition accuracy by rumor topic category

谣言主题类别 样本数/条 准确率/% 典型误判情况
社会安全 820 96.3 部分夸大性表述与真实安全预警的边界模糊
健康养生 1 050 97.1 少数伪科学内容因引用学术术语而被误判为非谣言
科学常识 780 95.5 前沿科技话题因信息不确定性较高导致未知比例偏高
公共政策与民生 920 96.8 政策解读类内容中,部分过度解读与真实解读难以区分
食品安全 680 97.5 该类谣言模式固定(如“XX致癌”),模型识别效果最好
历史文化 420 93.1 历史事件的真伪判断依赖专业知识,模型知识覆盖不足
财经商贸 560 94.6 涉及市场预测的内容,真伪边界本身模糊
国际关系 470 92.8 跨文化语境下的信息核实难度大,权威信源覆盖不足
娱乐八卦 700 95.7 部分未经证实的爆料与真实八卦难以区分
从表7可以看出,模型在食品安全(97.5%)和健康养生(97.1%)两类谣言上表现最优,这主要是因为此类谣言的语言模式相对固定(如“XX食物致癌”“XX偏方治百病”),且知识库中积累了大量对应的辟谣记录,模型能够通过模式匹配和知识库检索实现高精度识别。公共政策与民生类(96.8%)和社会安全类(96.3%)的准确率也较高,得益于政府机构和官方媒体对此类谣言的辟谣信息发布及时且权威,RAG检索能够有效获取可靠证据。
国际关系类(92.8%)和历史文化类(93.1%)准确率较低,前者受限于跨文化信息核实难度与中文权威信源覆盖不足,后者受限于历史学领域知识库深度有限。这一发现为后续知识库的定向扩充提供了方向。

4.3.4 持续学习稳定性分析

为验证持续学习机制在实际运行中的稳定性与有效性,本研究记录了模型在3轮增量微调过程中的性能变化趋势。
在未知类别判定比例方面,初始部署时模型对推理验证数据集中约18.5%的样本判定为未知。经过第1轮增量微调(新增约320条从实际运行中积累的高质量样本)后,未知比例下降至12.3%;第2轮微调(累计新增约580条)后降至8.7%;第3轮微调(累计新增约810条)后进一步降至6.2%。未知比例的持续下降表明,增量学习机制能够有效将模型在运行中遇到的新知识内化为自身能力,逐步缩小知识盲区。
在识别准确率方面,模型F1值从初始的0.96经过3轮微调后稳定在0.965左右,FTCA从94.8小幅提升至95.3。值得注意的是,准确率的提升幅度小于未知比例的下降幅度,这是因为初始模型对于能够明确判定的样本已经具备较高的准确率,增量学习的主要贡献在于将原本判定为“未知”的样本转化为可以正确识别的样本,而非提升已有判定的准确性。
知识库中的数据从初始约56 000条增长至3轮微调后约57 200条,增长速度与未知样本处理量正相关(突发期单日50—80条,平稳期10—20条),呈现自适应增长模式[20]。

4.3.5 典型案例分析

为直观展示框架的完整工作流程,本研究选取两个不同类型的典型案例进行分析。
案例一:科技类谣言“#AI虚拟人失控”。该谣言声称“某科技公司发布的AI伴侣产品出现攻击用户的行为,已造成多人受伤”。模型初始判定为未知(最高类别概率0.61,低于置信度阈值0.7),随即触发动态检索。系统从该科技公司官方公告、主流科技媒体报道及相关监管部门声明中检索到多条证据,均未发现任何关于AI伴侣产品攻击用户的报道或通报。基于检索证据,模型二次研判输出:标签为谣言,理由为“经检索官方声明及监管公告,未发现相关事件记录,原始信息缺乏具体时间地点,符合科技恐慌类虚构模式”。
案例二:公共政策类谣言“#个人碳税开征”。该谣言声称“国家将于年底开始对个人征收碳排放税,每人每年需缴纳2 000元”。模型初始判定为未知(最高类别概率0.52),触发动态检索后,系统从国务院政策文件库、财政部官网及国家税务总局公告中检索到相关政策原文,确认当前碳交易机制仅面向重点排放企业,并无任何针对个人的碳税征收计划。模型二次研判输出:标签为谣言,理由为“经检索财税政策文件,当前碳交易仅面向重点排放企业,无个人碳税征收计划,该信息系对碳达峰政策的误读”。
在谣言传播前6小时的早期识别测试中,模型F1达0.91,高于基座模型的0.78,验证了框架在早期干预中的有效性。

5 结语/Conclusion

本研究提出了一种基于Qwen3-8B的领域自适应微调方法,融合RAG检索增强、CoT推理与LoRA微调技术,构建了兼具高准确性、可解释性与低训练成本的谣言识别模型。实验表明,该模型在F1值(0.96)和FTCA(94.8)上均优于多种主流基线模型,消融实验验证了各核心模块的独立贡献,持续学习机制有效降低了未知判定比例。基于“标签—证据—推理理由”的输出形式增强了识别结果的可理解性与应用价值。
从应用层面看,本方法可为社交媒体平台、舆情监测系统及事实核查场景提供技术支持,尤其在谣言传播早期阶段保持较高识别稳定性。动态检索与增量学习机制使模型具备持续适应新事件与新话题的能力[21]。
本研究仍存在一定局限性,如数据与实验主要聚焦中文文本谣言,对跨语言与多模态场景覆盖不足[22]。在多模态方面,本框架在架构层面具备扩展潜力:感知层可引入视觉编码器进行跨模态融合,知识获取层可扩展多模态检索能力,增量学习机制同样适用于多模态样本。未来研究可在图文一致性检测、深度伪造识别等方向进一步拓展框架的应用边界,并强化算法透明性与伦理合规设计。
[1]
Vosoughi S, Roy D, Aral S. The spread of true and false news online[J]. Science, 2018, 359(6380): 1146-1151.

[2]
Zubiaga A, Aker A, Bontcheva K, et al. Detection and resolution of rumours in social media[J]. ACM computing surveys(CSUR), 2018, 51(2): 1-36.

[3]
郭长青, 侯勇光. 情报感知视角下社交媒体信息迷雾线索识别研究[J]. 情报杂志, 2023, 42(7): 140-146.

Guo Changqing, Hou Yongguang. Research on identification of social media information fog clues from the perspective of intelligence awareness[J]. Journal of intelligence, 2023, 42(7): 140-146.

[4]
朱鹏, 陈晓天, 王有建, 等. 融合超图的演化博弈网络谣言传播模型研究[J]. 情报理论与实践, 2025, 48(8): 11-20.

Zhu Peng, Chen Xiaotian, Wang Youjian, et al. Research on rumor propagation model of evolutionary game network based on hypergraph fusion[J]. Information theory and practice, 2025, 48(8): 11-20.

[5]
王根生, 朱奕, 李胜. 一种融合知识图谱的图注意力神经网络谣言实时检测方法[J]. 数据分析与知识发现, 2024, 8(6): 95-106.

Wang Gensheng, Zhu Yi, Li Sheng. A real-time rumor detection method based on the graph attention neural network integrated with the knowledge graph[J]. Data analysis and knowledge discovery, 2024, 8(6): 95-106.

[6]
曾子明, 张瑜. 基于数据增强和多任务学习的突发公共卫生事件谣言识别研究[J]. 数据分析与知识发现, 2023, 7(11): 56-67.

Zeng Ziming, Zhang Yu. Rumor detection of public health emergencies based on data augmentation and multi-task learning[J]. Data analysis and knowledge discovery, 2023, 7(11): 56-67.

[7]
潘杰, 王娟, 王楠. 大语言模型与谣言: 生成与检测的综述[J]. 计算机科学, 2025, 52(11): 1-12.

Pan Jie, Wang Juan, Wang Nan. Large language models and rumors: a survey on generation and detection[J]. Computer science, 2025, 52(11): 1-12.

[8]
司赟, 苏依拉, 仁庆道尔吉, 等. 基于多模态融合和知识感知的谣言检测方法[J].计算机应用与软件, 2025, 42(10): 177-182, 221.

Si Yun, Su Yila, Daoerji Renqing, et al. Rumor detection method based on multimodal fusion and knowledge perception[J]. Computer applications and software, 2025, 42(10): 177-182, 221.

[9]
吴诗苑, 董庆兴, 宋志君, 等. 社交媒体中错误信息的检测方法研究述评[J].情报学报, 2022, 41(6): 651-661.

Wu Shiyuan, Dong Qingxing, Song Zhijun, et al. Misinformation detection in social media[J]. Journal of the China Society for Scientific and Technical Information, 2022, 41(6): 651-661.

[10]
黄涛, 肖玉芝, 向洁萍, 等. 融合多层级特征表示的多领域谣言早期检测方法[J]. 情报杂志, 2025, 44(4): 127-135.

Huang Tao, Xiao Yuzhi, Xiang Jieping, et al. A multi-domain rumor early detection method fusing multi-level feature representations[J]. Journal of intelligence, 2025, 44(4): 127-135.

[11]
Zhou X, Zafarani R. A survey of fake news: fundamental theories, detection methods, and opportunities[J]. ACM computing surveys, 2020, 53(5): 1-40.

[12]
阳长征. 算法推荐语境下突发事件网络谣言信息时空泛化与共变影响研究[J]. 情报杂志, 2025, 44(5): 104-111.

Yang Changzheng. Spatio-temporal generalization and coupling of rumor information of network emergency events based on social network structure in the context of algorithm recommendation[J]. Journal of intelligence, 2025, 44(5): 104-111.

[13]
石锴文, 刘勘. 突发公共卫生事件中微博谣言的识别[J].图书情报工作, 2021, 65(13): 87-95.

Shi Kaiwen, Liu Kan. Weibo rumor identification in public health emergencies[J]. Library and information service, 2021, 65(13): 87-95.

[14]
丁浩, 刘清, 齐江蕾, 等. 基于网络突发公共卫生事件早期谣言识别研究——以新冠疫情谣言为例[J].情报科学, 2023, 41(4): 156-163.

Ding Hao, Liu Qing, Qi Jianglei, et al. Early rumor identification based on internet public health emergencies——taking the new crown epidemic rumor as an example[J]. Information science, 2023, 41(4): 156-163.

[15]
中国互联网联合辟谣平台. 中国互联网联合辟谣平台[EB/OL].[2026-06-23].

China Internet Joint Rumor-Busting Platform. China Internet Joint Rumor-Busting Platform[EB/OL].[2026-06-23].

[16]
陈燕方, 周晓英. 基于文本特征融合的衍生性网络健康谣言识别模型研究[J]. 图书情报工作, 2023, 67(14): 73-84.

Chen Yanfang, Zhou Xiaoying. Research on derivative online health rumors identification model based on text feature fusion[J]. Library and information service, 2023, 67(14): 73-84.

[17]
Weibo 21 中文谣言检测数据集. Weibo21中文谣言检测数据集[DS/OL].

Weibo 21 Chinese rumor detection dataset[DS/OL].

[18]
李贺, 杨心苗, 沈旺, 等. 启发式图结构增强的社交媒体短文本谣言检测研究[J]. 情报理论与实践, 2025, 48(3): 151-159.

Li He, Yang Xinmiao, Shen Wang, et al. Heuristic graph structure enhanced model for rumor detection in social media short texts[J]. Information studies: theory & application, 2025, 48(3): 151-159.

[19]
Kwon S, Cha M, Jung K. Rumor detection over varying time windows[J]. Plos one, 2017, 12(1): e0168344.

[20]
Parisi I G, Kemker R, Part L J, et al. Continual lifelong learning with neural networks: a review[J]. Neural Networks, 2019, 113: 54-71.

[21]
杨洋洋, 谢雪梅. 三元主体交互视角下网络谣言监管的博弈演化研究[J].现代情报, 2021, 41(5): 167-177.

Yang Yangyang, Xie Xuemei. Research on game evolution of internet rumor regulation from the perspective of ternary subject interaction[J]. Journal of modern information, 2021, 41(5): 167-177.

[22]
蒋超, 朱学芳. 基于模态融合增强的谣言检测研究[J]. 数据分析与知识发现, 2025, 9(7): 26-37.

Jiang Chao, Zhu Xuefang. Research on rumour detection based on modal fusion enhancement[J]. Data analysis and knowledge discovery, 2025, 9(7): 26-37.

Outlines

/

〈 〉