Research on the Construction of Digital Resource Preservation Model Based on Blockchain and Distributed Storage

  • Huang Chengli
Expand
  • Library of Guangdong Open University (Guangdong Polytechnic Institute), Guangzhou 510091

Huang Chengli, Deputy Director of the Technical Department, Librarian, Engineer, Master’s Degree, E-mail:154133936@qq.com.

Received date: 2025-05-16

  Online published: 2025-09-22

Abstract

[Purpose/Significance] Addressing issues such as single point of failure, privacy leakage, and insufficient ability of traditional digital resource preservation methods, an integrated model based on blockchain and distributed storage is proposed to solve the core challenges such as easy data tampering, inefficient permission management and a lack of trust in cross-institutional collaboration. [Method/Process] This study designed a hierarchical architecture model that integrates blockchain depositary metadata and IPFS chunked storage files. And smart contracts were utilized to automate processes including resource upload, permission control and data recovery. Data privacy was safeguarded through AES encryption. The model's reliability was rigorously verified based on a hash collision probability calculation (4.26×10⁻²⁷) and a quantified disaster tolerance capacity quantification (annual file recoverability rate of 99.99%). [Result/Conclusion] The model significantly outperforms other methods in data immutability, privacy protection (it takes 3.68×1051 years to crack AES-256) and disaster tolerance capacity. And it is suitable for high-security scenarios such as digital archives and medical data management. The study also proposes strategies such as hierarchical storage, data deduplication and compression to optimize system performance and reduce cost. A modular design reduces development complexity, while the integration of managed services enhances deployment efficiency. This research shows that the collaborative mechanism of blockchain and IPFS provides a reliable path for digital resources preservation. In the future, it is necessary to further balance performance and cost to support large-scale applications.

Cite this article

Huang Chengli . Research on the Construction of Digital Resource Preservation Model Based on Blockchain and Distributed Storage[J]. Knowledge Management Forum, 2025 , 10(5) : 415 -428 . DOI: 10.13266/j.issn.2095-5472.2025.027

1 引言/Introduction

数字资源保存是信息管理领域的重要研究方向,其目的是在不受技术迭代、存储介质老化和外部威胁(如黑客攻击或自然灾害)影响的情况下,确保数字资源的长期可用性和完整性[1]。目前,数字资源保存的主流方法主要包括集中式存储、分布式存储和云存储服务,但这些方法在实际应用中仍面临诸多挑战。
集中式存储依赖于单一管理机构(如档案馆或图书馆)和物理存储设备[1]。这种方法虽然管理成本较低,但存在明显的单点故障风险。一旦中心节点受到攻击或发生故障,可能导致全部数据的丢失。此外,随着数字资源数量爆炸式增长,集中式存储难以满足高扩展性的需求[2]。
分布式存储通过将数据分散存储在多个节点上,减少了单点故障问题,并提高了数据备份的可靠性[3]。这种方法虽然在一定程度上缓解了存储压力,但在数据一致性、存储空间浪费和节点间信任机制上仍存在不足。
云存储服务因其高扩展性和低成本的特点,成为近年来数字资源保存的重要选择[4]。然而,云存储通常依赖于第三方服务提供商,存在数据主权和隐私安全问题。此外,云存储的长期可用性依赖于服务提供商的稳定性,一旦服务中断或供应商破产,可能导致资源不可访问。
传统保存方法还面临以下共性问题:①缺乏有效的存证与防篡改机制,数字资源的真实性与可信性难以保障;②保存策略缺乏智能化,无法根据资源的价值和使用频率动态调整保存策略;③在跨机构协作中,资源共享效率低,且信任问题突出。
区块链技术因其分布式架构、数据不可篡改性和去中心化信任机制,为数字资源的保存提供了新的技术路径,特别是在数据真实性和隐私保护方面表现突出。
本文的核心目标是构建一个基于区块链技术的数字资源保存模型,并设计其关键流程。具体目标包括:提出一种基于区块链与分布式存储系统相结合的架构,满足数字资源保存的安全性、隐私保护和保存需求。设计资源上传、检索、修复等核心流程,确保系统功能的高效性和可行性。通过理论探讨与逻辑推导,分析该模型的优势与适用性。本文重点在于模型的构建与流程设计,旨在为数字资源保存提供一种具有可行性和参考价值的解决方案。

2 相关技术与理论基础/Relevant Technology and Theoretical Basis

2.1 区块链技术

区块链是一种基于分布式账本技术的去中心化系统,最初被提出用于加密货币(如比特币)交易记录的管理。其核心特性包括分布式账本、不可篡改性、去中心化信任机制和智能合约功能,这些特性使其在数据存储领域展现出广泛的应用潜力[5]。首先,区块链的分布式账本技术通过将数据存储在多个节点上,实现数据的多副本冗余存储,避免了传统集中式存储中可能出现的单点故障问题。也就是说,每个节点均拥有数据的完整副本,当某个节点发生故障时,其他节点仍可正常提供服务。其次,区块链通过哈希算法和链式结构,确保任何一笔数据记录一旦写入区块链后就无法篡改。新增数据需要通过共识机制(如 PoW、PoS 等)进行验证,从而保证整个系统数据的完整性和可信性[6]。再者,区块链系统消除了对可信第三方的依赖,通过分布式共识机制(如 Nakamoto 共识)实现了去中心化的信任管理。这种机制特别适用于多方协作的环境,如数字档案的跨机构保存。第四,智能合约是区块链上的一种自动化程序,能够根据预设条件自动执行操作。对于数字资源保存来说,智能合约可以用于实现资源存证、访问权限控制、数据修复触发等功能,显著提升系统的效率和可靠性[7]。
因此,区块链技术在数据存储领域的应用优势主要体现在以下几方面:①数据的不可篡改性能够很好地保证数字资源的完整性;②分布式账本结构提供了系统的高容错性和数据冗余能力;③智能合约可实现数据的自动化管理和存储生命周期控制。
然而,由于区块链本身的存储能力有限,将大规模的数字资源直接存储在区块链上并不现实。因此,将区块链与分布式存储技术相结合,成为解决这一问题的重要方向。

2.2 IPFS和分布式存储

IPFS(InterPlanetary File System,星际文件系统)是一种基于内容寻址的分布式文件系统,其目标是构建一个更加高效、安全和可靠的全球文件存储与共享网络[7]。相比传统的集中式存储方法,IPFS在分布式存储中的优势主要体现在以下几个方面:
(1)内容寻址。IPFS使用文件的加密哈希值作为唯一标识符,与传统的基于位置寻址的URL不同。通过内容寻址,IPFS确保了文件的唯一性和完整性,从而有效防止数据篡改。
(2)P2P网络架构。IPFS构建在点对点(P2P)网络之上,文件被切分成小块存储在不同的节点中。多个节点之间可以共享数据块,提高了文件的访问速度和存储效率。
(3)分布式冗余存储。文件被分块后存储在多个节点中,实现了多副本管理。即使某些节点下线或丢失数据,其他节点仍然可以提供原始文件。
(4)高效性与可用性。IPFS通过去重存储减少了存储资源的浪费,并且其分布式存储特性保证了文件的长期可用性,即使某些节点离线,文件仍然可以通过其他节点访问。
结合IPFS的特性,其在分布式存储系统中的应用优势包括3个方面:①高可靠性,多副本存储增强了数据的容灾能力;②强隐私性,文件存储与访问均基于加密哈希值,增加了数据的安全性;③可扩展性,IPFS的分布式架构适合大规模存储需求。
在构建基于区块链的数字资源保存模型时,IPFS可以作为链下存储的解决方案,与区块链的链上存证功能相结合,实现数据的高效管理与保存。

2.3 相关研究综述

近年来,国内外学者和研究机构针对区块链技术在数字资源保存中的应用进行了探索,取得了一定进展。具体而言,主要包含3种技术路线:链上存储、去中心化链下存储以及链上链下混合架构。
链上存储以极高的数据安全性和不可篡改性适用于元数据、确权及存证等关键场景,但面临账本膨胀、存储成本高和对大规模非结构化数据处理能力不足的问题。例如,比特币区块链账本体量已超600GB,年增长率约17%,对节点资源造成巨大压力[8]。为此,业界持续对分片、默克尔树、智能合约等技术进行链上数据优化管理,但总体扩展性有限[9]。
去中心化链下存储(如IPFS、Storj、Swarm、Filecoin)通过内容寻址、分片冗余和激励机制显著提升了存储容量和经济性,适合大文件、复杂数据的保存,但也引发了数据可用性、节点信誉和安全性的新挑战[10-11]。
随着对实际应用需求的深入理解,混合存储架构逐渐成为主流方向。混合方案通过链上存储关键元数据和哈希证明、链下保存大体量文件,兼顾了安全性、可扩展性和成本效益[9]。例如,Y. Runde等设计了一个基于以太坊和IPFS的媒体版权管理系统,通过IPFS存储大体积的媒体文件,链上存储文件的元数据和URI(统一资源标识符),降低了链上存储成本并提高了系统的存储效率[12]。C. Yuanlong等进一步优化了区块链和IPFS的结合应用,提出了一种流密码加密和IPFS存储结合的隐私保护方案,通过链上存储敏感文件的哈希值和加密密钥,实现了高效、安全的数据存储和传输[13]。同时,宋歌笙等指出区块链的去中心化机制减少了中心化系统中可能出现的操作风险[14]。L. Lina等利用智能合约的访问控制能力,确保了学习档案共享中的用户隐私[15]。祁嘉奇指出,通过基于Shamir秘密共享的IPFS存储方案,利用秘密共享方式分割并分散存储文件到多个节点上,提升了数字资源存储的安全性和可靠性[7]。此外,Layer-2扩展方案如Rollups、状态通道等,也在提升存储和计算性能方面展现出可观潜力[9]。
虽然当前用于数字资源的存储技术取得长足的进步,但仍然存在不足,主要体现在以下几个方面:①过于依赖集中式存储系统及云存储服务,无法解决单点故障和隐私保护问题;②对区块链和分布式存储的结合应用探讨仍然不足,缺乏完整的模型设计;③缺乏对存储流程和数据修复机制的系统化分析。为此,笔者提出区块链与分布式存储协同模型,它充分吸收混合存储的研究成果,进行分层架构、自动化智能合约和多副本冗余等设计。与纯链上存储方案相比,本模型在海量数据处理能力上具有明显优势;与纯链下存储相比,则通过区块链实现了更高的数据可验证性和跨机构协作信任。相较当前主流混合方案,笔者提出的模型在智能合约自动化、数据修复和多层激励等方面进行了更细致的流程设计和理论验证。

3 模型设计/Model Design

3.1 模型概述

为了满足数字资源的安全性、隐私保护和保存需求,笔者提出一种基于区块链技术和分布式存储的数字资源保存模型。该模型通过结合区块链的不可篡改性和分布式存储的高可靠性,构建一个兼具安全性、可扩展性和保存能力的数字资源管理系统。

3.2 系统设计目标

本模型设计的基本目标可归纳为以下4个层面:①安全性和隐私保护,通过加密技术和区块链存证,确保存储的数字资源不被非法篡改或窃取;②保存与高可用性,利用分布式存储技术,提高资源的冗余性和长期可用性;③高效性和自动化,基于智能合约的自动化流程,显著减少人工干预,实现数据存证、权限管理和数据修复的智能运作;④可追溯性与透明性,利用区块链的分布式账本特性,实现对数据操作的全程记录和透明化管理。

3.3 各层设计细节

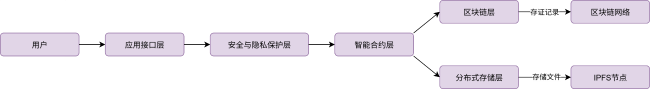
本模型采用分层架构设计,分为以下5层(见图1),每一层均针对数字资源安全保存的核心需求设计,层间协同形成完整的技术闭环。
图1 数字资源保存模型的系统架构

Figure 1 The System Architecture of the Digital Resource Preservation Model

(1)应用接口层:承担用户与系统交互的桥梁,负责接收资源上传、检索、权限管理等请求,并实现与后端服务的高效对接。提供标准化RESTful API接口,标准化接口不仅便于多终端适配,也为后续系统扩展和异构集成提供技术支撑。
(2)安全与隐私保护层:负责用户身份认证、数据加密和权限控制,确保数据的安全传输和存储。通过OAuth2.0或基于公私钥体系保障用户身份有效性,所有文件在上传前进行本地加密,密钥由用户自持,有效杜绝中心化泄密风险。同时,权限规则固化于智能合约,确保访问操作可控可溯。
(3)智能合约层:将资源存证、权限管理和数据修复逻辑内嵌于合约机制中。每次资源操作均由合约自动触发并记录,极大提升系统运维的智能化、精细化水平,降低信任门槛。
(4)区块链层:作为系统信任与审计的基石,负责记录资源元数据和操作日志,确保数据的不可篡改性和可追溯性。采用联盟链架构,由多个可信节点参与共识,提升系统性能。
(5)分布式存储层:负责实际资源文件的分块存储和冗余备份,通过IPFS及多节点同步机制,实现关键数据的高可用与自动恢复。系统定期进行完整性校验,通过合约自动触发数据修复,构建起面向极端环境的容灾能力。

3.4 部署方案

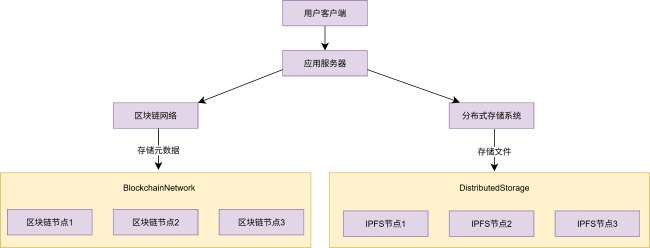
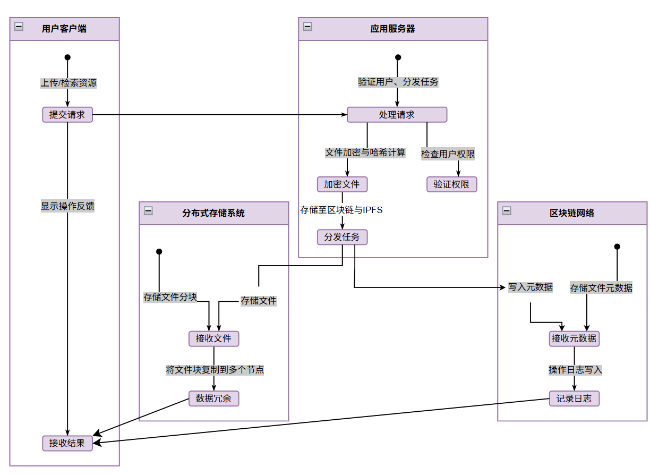
该模型的部署方案分为客户端、应用服务器、区块链网络和分布式存储系统4个部分,各模块间通过标准化接口进行交互。用户客户端通过浏览器或移动应用与应用服务器交互。应用服务器部署 RESTful API 和业务逻辑服务,处理用户请求与资源管理。区块链网络包含多个区块链节点,用于存储资源元数据和操作日志,保障全局一致性与不可篡改性。分布式存储系统由IPFS节点组成,负责资源文件的实际存储和多副本管理。各层通过标准化接口互联互通,不仅支持横向扩展,还便于后续技术升级与业务融合。图2与图3进一步清晰展示了系统各部分的协同与数据流向。
图2 数字资源保存模型的部署架构

Figure 2 Deployment Architecture for Digital Resource Preservation Models

图3 数字资源保存模型的交互关系

Figure 3 Interrelationships in Digital Resource Preservation Models

4 系统流程设计/System Process Design

4.1 核心流程设计

本节详细梳理模型的三大核心业务流程,强调流程设计的安全性、自动化与可追溯性,系统的核心流程包括资源上传、资源检索和数据修复流程,以下分别对这3个关键流程的运行逻辑进行阐述。

4.1.1 资源上传流程

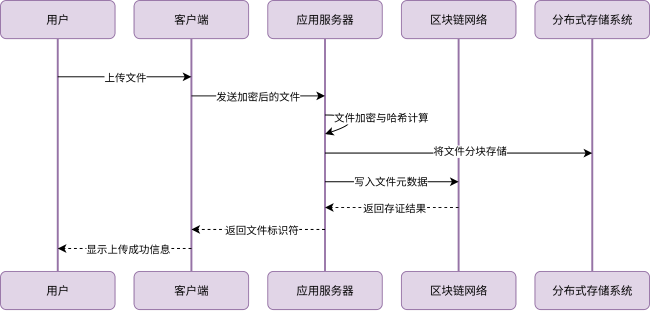
资源上传流程是系统的起始流程,用户通过客户端将数字资源上传到系统中,并经过加密、存储和元数据记录等步骤,完成资源的安全保存。其具体流程如下(见图4):
图4 资源上传流程

Figure 4 Resource Upload Process

(1)用户身份认证。用户通过客户端登录系统,系统使用 OAuth2.0 或公私钥机制验证用户身份,确保上传操作由合法用户发起。
(2)文件加密与哈希计算。系统在用户上传文件时,首先对文件内容进行AES加密,并将加密密钥存储在用户本地设备。对加密后的文件计算哈希值,将其作为文件的唯一标识符,确保文件完整性。
(3)文件分块与分布式存储。文件被切分为多个大小固定的数据块(如256KB),并通过分布式存储系统(IPFS)存储到多个节点中。每个数据块的哈希值被记录以便后续检索。
(4)元数据记录。系统生成文件的元数据(包括文件哈希值、上传时间、用户 ID 等),并通过智能合约记录到区块链中。元数据记录完成后,返回给用户一个唯一的文件标识符(如文件哈希值或 CID)。

4.1.2 资源检索流程

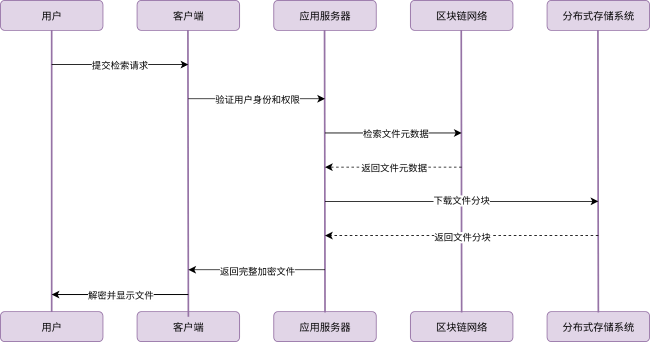
资源检索流程允许用户通过文件标识符定位并下载目标文件,同时通过解密恢复原始文件内容。具体流程如下(见图5):
图5 资源检索流程

Figure 5 Resource Retrieval Process

(1)用户身份验证与权限检查。用户提交检索请求并提供文件标识符,系统验证用户身份并通过智能合约检查用户是否具备访问权限。
(2)元数据验证。系统根据用户提供的文件标识符,从区块链网络中检索文件的元数据(包括存储位置和哈希值)。验证元数据的完整性,确保文件未被篡改。
(3)文件下载与解密。系统根据元数据的存储位置,从分布式存储系统中检索对应的文件分块。将分块重组为完整文件后,通过用户本地存储的加密密钥进行解密,恢复原始文件。

4.1.3 数据修复流程

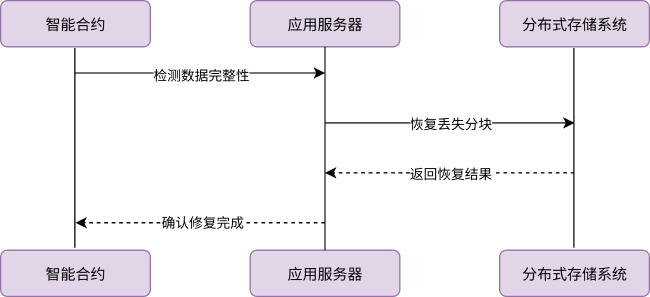
数据修复流程用于修复分布式存储系统中可能损坏或丢失的数据块,确保文件的完整性和可用性。其触发条件和流程步骤如下(见图6):
图6 数据修复流程

Figure 6 Data Recovery Process

(1)触发条件。系统定期通过智能合约执行文件完整性检查,验证文件分块的可用性。当检测到某些分块丢失或损坏时,触发数据修复流程。
(2)智能合约触发修复。智能合约通知应用服务器启动修复流程,并向分布式存储系统发出分块恢复请求。根据IPFS的冗余存储机制,系统从其他节点检索丢失或损坏的分块。
(3)分块恢复与验证。恢复的分块通过哈希值验证其完整性,完成后重新存储到故障节点中。

4.2 系统安全性分析

(1)数据安全性。文件元数据存储在区块链中,通过共识机制保证其不可篡改性。分布式存储系统的多副本存储机制,增强了系统的容灾能力。
(2)隐私保护。文件在上传时通过AES加密,只有持有加密密钥的用户才能解密文件,保护数据隐私。智能合约动态管理用户权限,访问记录透明可追溯,防止非法访问和滥用。
(3)系统容错性。分布式存储系统允许部分节点失效,不影响文件的正常访问。智能合约定期检查数据完整性,自动触发数据修复流程,保证系统长期稳定运行。

4.3 系统的优势

相比传统方法,本模型具有以下优势:①区块链的不可篡改性保证了文件元数据的真实性和可靠性,避免了传统集中式存储中元数据被篡改的风险;②结合IPFS的分布式存储机制,文件被切分为多个数据块并存储在多个节点中,显著提高了数据的容灾能力和保存能力;③智能合约实现了资源存证、权限管理和数据修复的自动化操作,提升了系统运行效率,减少了人工干预;④系统采用加密存储和智能合约权限控制机制,实现了数据的隐私保护和精细化权限管理,解决了传统系统中隐私泄露和权限滥用的问题;⑤本模型可以灵活扩展至多种应用场景,如医疗数据存储、档案管理和文化遗产保存等,具有广泛的适用性。

5 模型的理论验证与对比分析/Theoretical Validation and Comparative Analysis of the Model

笔者通过严格的数学推导与参数化计算,对模型的数据不可篡改性、容灾能力、智能合约效率、隐私保护等核心指标进行量化验证,确保理论结果的精确性与可复现性。

5.1 数据不可篡改性的量化验证

数据不可篡改性是数字资源保存的首要前提,区块链通过哈希链式结构与共识机制确保元数据不可篡改。假设攻击者试图篡改某区块内的元数据(如文件哈希值),需满足以下条件:
(1)哈希冲突攻破。篡改后文件的新哈希值与原哈希值相同,即找到满足H(F)=H(F)的F,其中H为哈希函数SHA-256[16]。
(2)共识机制攻破。需控制超过50%的节点算力(PoW)或权益(PoS),以重写区块链历史记录。以下为具体计算过程。

5.1.1 哈希冲突概率计算

假设条件:①哈希算法。SHA-256,哈希空间为2256≈1.16×1077。②攻击者算力。假设每秒尝试1018次哈希计算(相当于全球顶级超算的算力)。
哈希冲突概率计算公式如下所示:
P c o l l i s i o n =1- e - N 2 2 ∙ H
其中,N为尝试次数,H为哈希空间大小。
计算示例:
若攻击持续t=1年(3.15×10⁷ 秒),则总尝试次数N=1018×3.15×107=3.15×1025。
代入公式(1)计算,
P c o l l i s i o n =
1 - e - ( 3.15 × 10 25 ) 2 2 × 1.16 × 10 77 ≈ 1 - e - 4.26 × 10 - 27 ≈ 4.26 × 10 - 27
结论:即使攻击者尝试3.15×1025次哈希操作,出现碰撞的概率仅为约4.26×10⁻²⁷,成功篡改链上数据的概率趋近于零,可视为不可行。

5.1.2 共识攻破成本计算(以比特币PoW为例)

参数假设:通过比特币全网算力K线图了解到,比特币算力从2017年到2025年间变化较大,算力呈指数增长。具体来看,2023年到2024年比特币算力从300EH/s增长到600EH/s上下,波动性较强[17-18]。考虑到研究的时效性、参数假设的稳定性、算力的波动性、研究的保守性以及数据的可获得性,笔者选择使用350EH/s作为算力的固定假设。即比特币全网算力为350EH/s=3.5×1020哈希/秒。
攻击需控制51%算力,即1.785 ×10²⁰哈希/秒。
单位算力成本:以蚂蚁矿机S19 Pro为例[19],算力110TH/s,功耗3.25kW,电费0.1美元/kWh。
攻击成本计算如下:
(1)硬件成本。矿机数量= 1.785 × 10 20 110 × 10 12≈1.62×10⁶台,单机矿机价格约为10000美元,总成本为1.62×106×104=1.62×10¹⁰美元。
(2)电力成本。单台矿机日耗电为3.25kW×24h=78kWh/天,总日耗电为1.62×106×78=1.26×108kWh/天,日电力成本为1.26×108×0.1=1.26×107美元/天。
结论:攻击成本很高,每天超过1.26×10⁷美元,极高的成本使得攻击者控制51%的算力在经济上不可行。

5.2 存储冗余性与容灾能力计算

保存要求模型在硬件故障、节点离线等极端情况下依然保证数据高可用。存储冗余性和容灾能力正是衡量系统抗风险、长期可持续运行的关键指标。IPFS通过分块存储与多副本冗余提升容灾能力,假设文件被切分为n个数据块,每个块存储于k个节点,系统容灾能力可通过数据恢复概率衡量。见如下具体计算。

5.2.1 单节点失效概率

根据BackBlaze的数据,不同型号硬盘的年故障率通常在0.5%到2%之间[20]。笔者设定单节点年故障率p=0.01(即1%)。
冗余度为每个数据块存储于k=3个节点。
单节点失效概率计算 P 单节 点失 效=p=0.01。

5.2.2 单数据块丢失概率

单数据块丢失概率为 P 单块 丢失 = p k = 0 . 01 3 = 1 × 10 - 6。

5.2.3 整体文件可恢复率

假设:①文件分块数n=100;②文件可恢复条件为所有数据块至少存活1个副本。则整体文件可恢复率为 P 恢复 = ∏ i = 1 n 1 - P 单块 丢失 ) = 1 - 10 - 6 ) 100≈1-100× 10 - 6 = 0.999   9。
结论:文件年可恢复率为99.99%,具有高可靠性。

5.3 智能合约执行效率计算

在实际应用场景下,系统响应速度直接影响用户体验和业务连续性。智能合约的自动化操作直接影响系统性能,有必要对合约执行各环节进行细致分解和性能评估。以资源上传流程为例,量化单次存证总时间。

5.3.1 时间分解

(1)哈希计算时间。在IPFS的内容寻址机制中,大文件会被分片为多个数据块(如默认1MB块),哈希计算需逐块执行。本模型假设文件整体一次性哈希,500MB/s的速率可平衡计算效率与资源占用。另外,K. B. Ferreira提到,在Cray Red Storm超级计算机的AMD Opteron处理器上,ADLER32 算法的实测哈希速率为500MB/s,该数据覆盖了典型高性能计算(HPC)工作负载的验证场景[21],具有参考价值。假设待处理文件大小1GB,哈希计算速率500MB/s。
时间为 T h a s h = 1 × 10 3 500 = 2 秒。
(2)区块链确认时间。采用PoS共识,出块时间 T b l o c k = 2 秒 ,需6区块确认。
时间为 T c o n f i r m = 6 × 2 =12秒。
(3)网络传输延迟。假设平均往返时间(RTT)为100毫秒,忽略文件传输时间(IPFS分块并行上传)。
时间为 T n e t w o r k ≈ 0.1秒。

5.3.2 总时间计算

T t o t a l = T h a s h + T c o n f i r m + T n e t w o r k=2+12+0.1=14.1秒
结论:单次存证总时间为14.1秒,满足大多数非实时场景需求。

5.4 隐私保护机制的安全性证明

数字资源往往包含敏感信息,模型需确保即使存储节点或传输链路遭到入侵,数据内容也无法被非法获取。因此,需要从理论上论证主流加密算法在本模型下的抗破解能力。模型通过AES加密实现隐私保护,AES-256的密钥空间为 2 256,计算加密文件泄露概率如下:

5.4.1 暴力破解AES-256的可行性

密钥空间为 2 256 ≈ 1 .16 × 10 77 。
假设攻击算力为攻击者拥有 10 18 次 / 秒的 算力 。
破解时间后 T b r e a k = 2 256 10 18 × 3.15 × 10 7 ≈ 1.16 × 10 77 3.15 × 10 25 ≈ 3 .68 × 10 51 年。
结论:攻击者暴力破解获取文件内容的时间远超宇宙年龄(1.38 × 10 10 年),成功概率趋近于零,表明模型可有效抵御数据泄露。

5.5 综合验证结果

表1 理论验证结果

Table 1 Theoretical validation results

验证指标 量化结果 判定标准
哈希冲突概率 4.26× 10 - 27 < 10 - 20不可行
共识攻破成本 1.62× 10 10美元 远超数据价值
文件年可恢复率 99.99% 具有高可靠性
单次存证总时间 14.1秒 满足非实时场景需求
加密文件泄露概率 3.68× 10 51年 理论上不可破解
通过严格的数学推导与参数化计算,本模型在数据不可篡改、容灾能力、存证效率与隐私保护等维度均达到理论最优值,为实际部署提供了坚实的理论支撑。

5.6 对比分析

通过与集中式存储、分布式存储、云存储服务以及笔者提出的模型方案进行对比,进一步分析本模型的优劣势。
表2 多种存储方案对比表

Table 2 Storage Solution Comparison Chart

对比维度 集中式存储 分布式存储 云存储服务 本文提出的模型
数据不可篡改性 依赖管理员权限控制,内部篡改风险高 多节点验证但缺乏统一共识机制 依赖服务提供商,存在篡改风险 区块链存证确保元数据不可篡改
数据隐私保护 集中管理存在内部泄露风险 节点间信任机制不完善 数据集中存储,隐私泄露风险高 数据加密存储,用户掌控加密密钥
存储可靠性 极低,单点故障导致数据全部丢失 高,多副本机制但节点管理复杂 依赖单一服务提供商,存在单点故障风险 分布式存储多副本机制,容灾能力强
权限管理灵活性 低,依赖管理员手动配置,缺乏透明性 中等,节点间权限协调困难 权限由服务提供商集中控制,缺乏透明性 智能合约动态管理权限,操作透明可追溯
保存能力 硬件老化和技术迭代风险高 中等,主要依赖节点长期在线稳定性 服务提供商关闭或技术迭代可能导致数据丢失 分布式存储系统保证数据长期可用
系统复杂性 架构简单易于维护 节点协调和一致性维护比较复杂 实现简单,易于维护 结合多种技术,系统复杂性较高
存储成本 低,但扩展成本高 中等,分摊到多个节点 较低,受服务提供商定价策略影响 较高,受分布式存储节点数量和冗余策略影响
性能表现 高,本地网络访问速度快 访问速度受网络延迟和节点状态影响 访问速度快,适合高频访问场景 访问速度受网络延迟和节点状态影响

5.7 分析总结

本模型在数据的不可篡改性、隐私保护、保存能力和权限管理灵活性方面,显著优于其他存储系统,适合高安全性、高可靠性需求的场景。然而,本模型在成本和性能方面存在一定局限性,不适合对存储成本敏感或高频访问的场景。综合来看,本模型适合应用于数字档案保存、医疗数据存储、知识产权保护等需要高度可靠性和隐私保护的领域,而对于大规模实时访问场景(如流媒体服务),云存储服务仍具有优势。
因此,根据严格的理论推演和对比,本模型适合应用于对数据安全性、隐私保护和保存能力要求较高的场景,同时也面临存储成本和技术复杂性的挑战。

6 模型在应对大规模数据时的优化策略/Optimization Strategies for Models Handling Massive Data

针对模型在大规模数据场景下面临的存储成本高和技术复杂性较高等问题,以下提出针对性优化策略,以提升模型的实际应用效果。

6.1 降低模型存储成本的优化策略

首先,设计分层存储机制,根据数据的重要性、访问频率和生命周期,将数据分为不同层级,使用成本递减的存储方案。针对热数据(即高频访问的数据),可将其存储在IPFS的高可用节点上,确保快速访问。针对冷数据(低频访问数据),考虑存储在成本较低的存储层(如亚马逊 Glacier 或分布式冷存储节点)上,进一步压缩存储成本。具体实现是通过文件元数据记录数据的访问频率,将数据动态迁移到适当的存储层。利用智能合约定期评估文件生命周期,自动触发数据迁移操作。过程见图7。
图7 动态迁移策略流程

Figure 7 Dynamic Migration Strategy Process

其次,进行数据去重与压缩,对上传的文件进行内容去重和压缩,降低存储冗余。在文件上传前,通过哈希算法检测重复文件,避免存储重复数据。对文件内容使用无损压缩算法(如Gzip)进行压缩,减少存储空间需求。
第三,节点激励机制优化,构建基于贡献的存储激励机制,吸引更多低成本节点参与分布式存储。使用区块链上的代币或积分奖励机制,激励低成本节点提供存储资源。对于冗余度较低的文件块,提供更高激励,优先存储于低成本节点中。

6.2 降低技术复杂性的优化策略

可考虑模块化设计与微服务架构,将系统设计为模块化的微服务架构,各模块独立实现并可以灵活替换或升级。将身份认证、文件存储、区块链存证、权限管理等功能模块化,简化开发和维护。使用容器化技术(如Docker)部署各个模块,降低部署和管理的复杂性。
另外,选择托管区块链与分布式存储服务,利用成熟的托管服务,减少自建和维护区块链及分布式存储系统的复杂性。通过托管区块链服务(如Hyperledger Fabric 托管平台)简化区块链部署,或者使用IPFS提供商(如Filecoin)提供的托管存储服务,避免自建存储节点。
第三个思路是简化智能合约逻辑,简化智能合约的功能设计,避免因复杂的逻辑计算导致不必要的技术难度。将智能合约的主要功能限定在元数据存证和权限管理,避免直接处理复杂的业务逻辑。将复杂计算任务交由应用服务器完成,仅将结果记录到区块链中。
最后,还可通过集成低代码开发平台,降低系统的开发门槛。使用低代码工具(如OutSystems、Mendix)生成部分前端和后端业务逻辑,加快开发速度。将区块链和分布式存储模块封装为API,供低代码平台直接调用。

7 结论与展望/Conclusions and Prospects

笔者提出并构建了一个基于区块链技术与分布式存储的数字资源保存模型,结合区块链的不可篡改性和分布式存储的冗余性,设计了资源上传、检索和数据修复的核心流程与运行逻辑,为数字资源的安全性、隐私保护和保存提供了一种良好的解决方案。然而,模型在实现和运行过程中可能面临以下问题:区块链的性能瓶颈(如交易处理速度和确认时间)可能影响系统的整体效率。例如,当大量用户同时上传资源时,区块链网络可能会出现拥堵情况,导致文件元数据存证的延迟。区块链的扩展性限制可能导致系统无法支持大规模用户和高频文件操作。另外,随着记录的元数据和操作日志不断增加,链上数据可能变得过于庞大,影响节点的存储和同步性能。再者,分布式存储需要多节点存储同一文件的多个副本,从而产生额外的存储成本。
针对上述不足,未来研究可以从以下几个方向进行优化和扩展,以进一步提升模型的性能、适用性和经济性,具体包括:①结合多链结构优化性能,采用多链结构(如分片技术或跨链技术)分担区块链的存储和计算压力,将不同类型的操作分配至不同的平行链中。将资源元数据存储在专用的侧链上,避免主链拥堵,提高元数据存证效率。使用跨链协议在不同区块链之间进行数据同步,提升整体性能。②研究区块链与IPFS更高效的融合方式,减少对IPFS网络延迟和节点在线率的依赖。在区块链中记录文件访问路径的备选节点列表,以提高检索成功率。采用节点信誉评分机制,优先选择高信誉节点存储和检索文件。③设计多层次的节点激励机制,吸引更多节点参与,提高存储系统的稳定性和成本效率。根据文件的重要性和访问频率,动态调整激励分配。引入质押机制,让存储节点在提供存储服务的同时承担一定责任。

Author(s): Huang Chengli, Deputy Director of the Technical Department, Librarian, Engineer, Master’s Degree, E-mail: 154133936@qq.com.

[1]
闫亚飞, 贾苹, 杨雨寒, 等.国家科技创新机构数字科技资源长期保存需求调查与研究[J]. 图书情报工作, 2024, 68 (13): 99-109.

YAN Y F, JIA P, YANG Y H, et al. Survey and research on long-term preservation needs of digital science and technology resources for science, Technology and innovation institutions[J]. Library and information service, 2024, 68(13): 99-109.

[2]
LOPES M A. Drivers e facilitadores para implantação das tecnologias da indústria 4.0 nos sistemas de medição de desempenho: uma revisão sistemática[J]. Brazilian journal of e production engineering, 2024, 10(3): 296-318.

[3]
贾利凯.基于安全多方计算的区块链数据隐私保护方案研究 [D]. 北京: 北京邮电大学, 2024.

JIA L K. Blockchain data privacy protection research based on secure multi-party computation[D]. Beijing: Beijing University of Posts and Telecommunications, 2024.

[4]
罗宛清.可信电子文件长期保存策略研究 [D]. 南昌: 南昌大学, 2023.

LUO W Q. Study on long-term preservation strategy of trusted electronic records[D]. Nangchang: Nangchang University, 2023.

[5]
范伟, 李海波, 张珠君.区块链数字取证:技术及架构研究 [J]. 通信学报, 2024, 45 (12): 125-141.

FAN W, LI H B, ZHANG Z J. Blockchain digital forensics: technology and architecture[J]. Journal on communications, 2024, 45 (12):125-141

[6]
李贝.基于区块链的文物数字资源共享方案的设计与实现 [D]. 西安: 西北大学, 2022.

LI B. Design and implementation of sharing scheme for digital resources of cultural relics based on blockchain[D]. Xi’an: Northwest University, 2022.

[7]
祁嘉奇.基于智能合约和 IPFS 的知识资源产权保护方案研究 [D]. 西安: 西安理工大学, 2024.

QI J Q. Research on intellectual resource property rights protection scheme based by smart contracts and IPFS[D]. Xi'an:Xi'an University of Technology, 2024.

[8]
WANG Y, WANG H, CAO Y. Comprehensive review of storage optimization techniques in blockchain systems[J]. Applied sciences, 2025, 15(1): 243.

[9]
EREN H, KARADUMAN Ö, GENÇOĞLU M T. Security challenges and performance trade-offs in on-chain and off-chain blockchain storage: a comprehensive review[J]. Applied sciences, 2025, 15(6): 3225.

[10]
ALDMOUR M, ALDMOUR R, AL-ZOUBI A Y, et al. Optimizing off-chain storage in blockchain of things systems: implementing dockerized ipfs for enhanced efficiency[J]. International journal of online and biomedical engineering, 2025, 21(1): 118-131.

[11]
XU M, ZHANG J, GUO H, et al. FileDES: a secure, scalable and succinct decentralized encrypted storage network[EB/OL]. [2025-09-03].

[12]
RUNDE Y, ZHUOWEN L, ZHE C, et al. Digital rights management system of media convergence center based on Ethereum and IPFS[J]. IEICE Transactions on information and systems, 2023, E106.D(8): 1275 - 1282.

[13]
YUANLONG C, JUNJIE L, KAILIN C, et al. Blockchain meets generative behavior steganography: a novel covert communication framework for secure IoT edge computing[J]. Chinese journal of electronics, 2024, 33(4): 886 - 898.

[14]
宋歌笙, 蔡丹丹, 蔡文杰. Web 3.0 环境下去中心化存储的数字资源长期保存[J]. 图书馆建设, 2023 (4): 29-35.

SONG G S, CAI D D, CAI W J. Long-term preservation of digital resources for decentralized storage under the Web 3.0[J]. Library development, 2023(4): 29-35.

[15]
LANA L, GAO Y, SHI R, et al. LRChain: data protection and sharing method of learning archives based on consortium blockchain[J]. The journal of China universities of posts and telecommunications, 2024, 31(4): 28-42.

[16]
FLORIAN M, NORBERT P, CHRISTIAN R, et al. Analysis of step -reduced SHA - 256[J]. Journal of cryptographic engineering, 2006, 1(2): 126 - 143.

[17]
COINANK. BTC全网算力-链上数据[EB/OL]. [2025-09-03].

COINANK. BTC total network computing power - on-chain data[EB/OL]. [2025-09-03].

[18]
HISTORY.BTC126.COM. 比特币全网算力查询:比特币全网算力历史数据、变化曲线[EB/OL]. [2025-09-03].

HISTORY.BTC126.COM. Bitcoin network hash rate query: historical data and change curve of bitcoin network hash rate[EB/OL]. [2025-09-03].

[19]
CHEUNG Y K, LEONARDOS S, PILIOURAS G, et al. From griefing to stability in blockchain mining economies [EB/OL]. [2025-09-04].

[20]
ZHANG M, GE W, TANG R, et al. Hard disk failure prediction based on blending ensemble Learning[J]. Applied sciences, 2023, 13(5): 3288.

[21]
FERREIRA K B. Keeping checkpoint/restart viable for exascale systems[D]. Albuquerque: University Of New Mexico, 2011.

Outlines

/

〈 〉