面向动态谣言识别的领域自适应大语言模型微调框架研究
作者贡献声明/Author contributions:
郭 岩:模型构建,程序实现,实验结果分析,论文撰写;
吴依凡:论文思路整理,论文撰写及修改;
杨湘浩:研究总体设计和推进,论文框架设计。
|
郭岩,硕士; |
|
吴依凡,硕士。 |
收稿日期: 2026-04-25
网络出版日期: 2026-08-17
Research on a Domain-Adaptive Large Language Model Fine-Tuning Framework for Dynamic Rumor Detection
|
Guo Yan, Master's Degree; |
|
Wu Yifan, Master's Degree. |
Received date: 2026-04-25
Online published: 2026-08-17
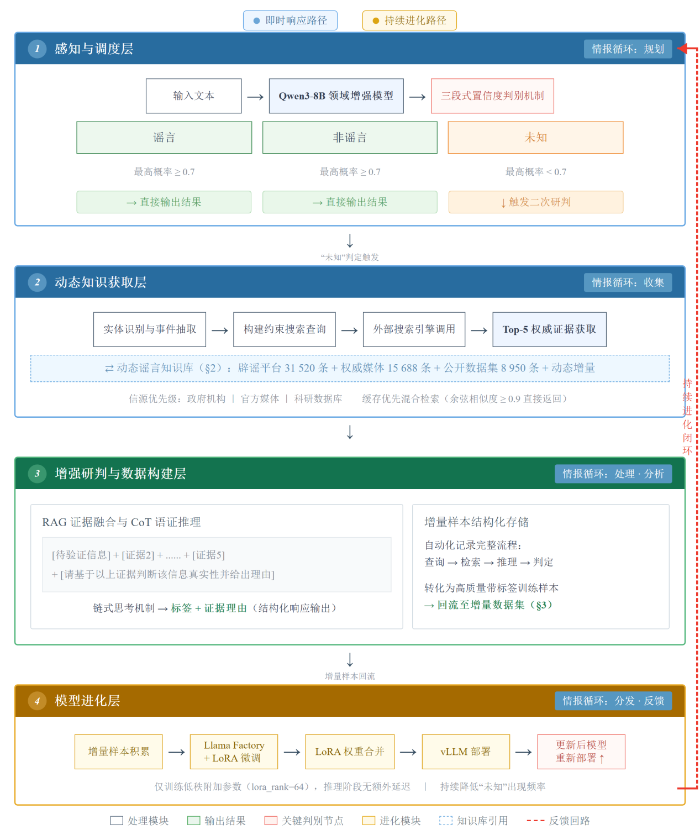
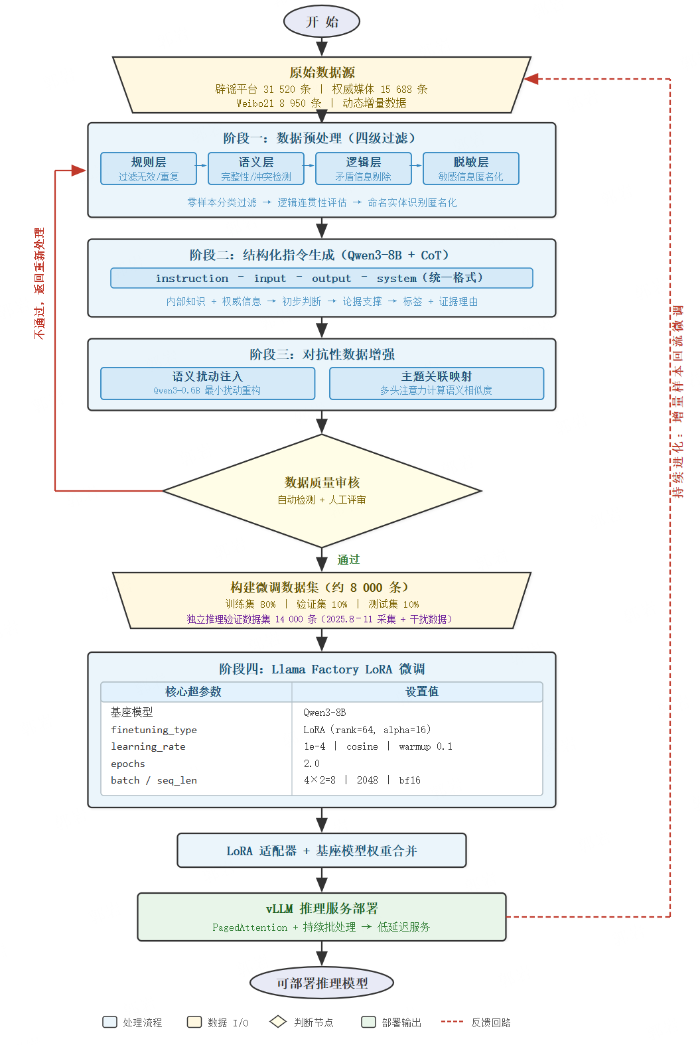
[目的/意义] 针对大语言模型在面对突发性网络谣言时受限于静态知识边界而无法准确判断的未知难题,传统静态识别方案缺少实时事实核查能力,难以适应不断涌现、形式多变的新型谣言,本研究设计并实现了一种检索—学习一体化的动态谣言识别新范式,提升模型对新发谣言的识别准确率,助力网络舆情自动化治理。[方法/过程] 本研究以Qwen3-8B微调模型为基础模型,设计谣言—非谣言—未知的三段式判断机制。当模型对输入信息判定为未知时,系统将自动触发网络搜索引擎,抓取权威信源证据,并将检索结果作为即时上下文,供模型进行二次精准研判。系统同时对每一次成功的查询、佐证与判别过程进行结构化存储,构建增量样本集,并采用轻量化低秩自适应微调技术,对基础模型进行周期性更新,从而实现检索增强与持续学习的一体化协同,形成实时查证、样本积累和模型迭代的闭环工作流程。[结果/结论] 实验结果表明,该方法在谣言识别任务中表现突出,F1值达到0.96,FTCA指标达到94.8,显著优于多种主流基线模型,且在应对突发与新型谣言场景中,能有效降低未知判定比例,表现出良好的稳定性与实用性,可为动态网络虚假信息智能研判提供技术参考,也为检索增强类谣言检测模型的优化提供新思路。
郭岩 , 吴依凡 , 杨湘浩 . 面向动态谣言识别的领域自适应大语言模型微调框架研究[J]. 知识管理论坛, 2026 , 11(4) : 333 -344 . DOI: 10.13266/j.issn.2095-5472.2026.028
[Purpose/Significance] Faced with emergent online rumors, large language models are restricted by static knowledge boundaries and fail to produce accurate judgments. Traditional static recognition schemes lack real-time fact-checking capability and cannot adapt to emerging and diversely expressed new rumors. This study designs and implements an integrated retrieval-learning dynamic rumor recognition paradigm to improve the model's recognition accuracy for newly emerging rumors and facilitate automatic governance of online public opinions. [Method/Process] Taking the fine-tuned Qwen3-8B as the base model, this study constructed a three-category discrimination mechanism including rumor, non-rumor and unknown. If the input information was judged as unknown by the model, the system automatically activated the Web search engine to capture evidence from authoritative sources, and took the retrieved results as real-time context for the model to conduct secondary accurate evaluation. The system structurally stored every successful query, supporting evidence and discrimination record to build an incremental sample set. Lightweight low-rank adaptive fine-tuning technology was adopted to periodically update the base model, so as to realize the integrated coordination of retrieval augmentation and continual learning, and form a complete closed loop of real-time verification, sample accumulation and model iteration. [Result/Conclusion] Experimental results show that the proposed method achieves excellent performance in the rumor recognition task, with an F1-score of 0.96 and an FTCA index of 94.8, which is significantly better than many mainstream baseline models. When dealing with sudden and novel rumors, it can effectively reduce the proportion of unknown judgments and presents favorable stability and practicability. It can provide technical references for the intelligent identification of dynamic online disinformation, and also offer new ideas for optimizing retrieval-augmented rumor detection models.
表 1 谣言主题分类体系Table 1 Rumor topic classification system |
| 谣言主题类别 | 典型谣言特征/关键词 |
|---|---|
| 社会安全 | 紧急通知、人贩子偷小孩、有毒气体泄漏、公共场所安全隐患、暴力事件夸大 |
| 健康养生 | 食物相克、致癌警告、神奇疗法、偏方治大病、疫苗恐慌、养生伪科学 |
| 科学常识 | 超自然现象、伪科学解读、反智言论、地球异象、技术威胁论 |
| 公共政策与民生 | 燃油/电价调整、虚假补贴、新规误读、拆迁赔偿、社保/医保政策变动 |
| 食品安全 | 人造鸡蛋、塑料紫菜、无根豆芽、黑心作坊、食品添加剂恐慌、季节性水果谣言 |
| 历史文化 | 历史名人伪言论、历史事件杜撰、民族英雄污名化、传统文化曲解、伪造考古发现 |
| 财经商贸 | 公司破产、名人“被代言”、经济崩溃论、虚假理财产品、股市/楼市预测 |
| 国际关系 | 战争夸大、外交冲突杜撰、针对特定国家/种族的虚假负面新闻、海外华人安全 |
| 娱乐八卦 | 明星“被去世”、虚假恋情/绯闻、剧组内幕夸大、艺人关系不和、作品抄袭杜撰 |
表 2 本研究数据集总体构成Table 2 The overall composition of the dataset in this research |
| 数据集名称 | 定位与用途 | 数据来源 | 规模 |
|---|---|---|---|
| 谣言知识库 | RAG检索的知识底座 | 辟谣平台+权威媒体+Weibo21+动态增量 | 约56 000条(初始) |
| 微调训练集 | LoRA微调的训练数据 | 辟谣平台+权威媒体+Weibo21+动态增量 | 约6 400条(80%) |
| 微调验证集 | 训练中超参数调优 | 辟谣平台+权威媒体+Weibo21+动态增量 | 约800条(10%) |
| 微调测试集 | 训练后的离线评估 | 辟谣平台+权威媒体+Weibo21+动态增量 | 约800条(10%) |
| 推理验证数据集 | 独立泛化能力评估 | 2025年8—11月时效性采集+干扰数据 | 14 000条 |
表3 时效性谣言数据关键词统计Table 3 Statistics of keywords in timely rumor data |
| 关键词 | 数量/条 | 占比/% | 关联类型 |
|---|---|---|---|
| #新型混合型流感 | 960 | 12 | 健康养生(一种不存在的新病毒传播,引发公众恐慌) |
| #AI虚拟人失控 | 880 | 11 | 科学常识/社会安全(某公司发布的AI伴侣攻击行为的虚假新闻) |
| #数字钱包强制升级 | 800 | 10 | 公共政策与民生(传闻央行数字货币钱包需强制升级) |
| #天问四号新发现 | 720 | 9 | 科学常识(杜撰中国火星探测器发现外星生命迹象的虚假) |
| #国庆高速新规 | 640 | 8 | 公共政策与民生(捏造国庆期间高速收费或限行的虚假政策) |
| #某某明星被封杀 | 560 | 7 | 娱乐八卦(针对当红艺人编造的虚假负面新闻) |
| #超级蔬菜致癌 | 560 | 7 | 食品安全(谣传某种通过基因技术改良的新型蔬菜会导致癌症) |
| #开学军训新模式 | 480 | 6 | 社会安全(夸大或捏造学校军训中出现的极端或危险训练项目) |
| #个人碳税开征 | 400 | 5 | 财经商贸/公共政策(谣传国家将开始对个人征收“碳排放税”) |
| 其他零散谣言 | 2 000 | 25 | (覆盖历史、国际关系等其他主题的零散、长尾谣言) |
| 总计 | 8 000 | 100 |
表 4 模型微调关键超参数设置Table 4 Key hyperparameter settings for model fine-tuning |
| 核心参数 | 值 | 说明 |
|---|---|---|
| finetuning_type | lora | 训练方法:指定使用LoRA技术 |
| lora_rank | 64 | 模型容量:LoRA矩阵大小,平衡性能与效率 |
| lora_alpha | 16 | 学习强度:LoRA的缩放因子,调节更新幅度 |
| learning_rate | 1.0e-4 | 学习速率:权重更新的步长,影响收敛速度 |
| num_train_epochs | 2.0 | 训练轮次:数据集被完整训练的总次数 |
| per_device_train_batch_size | 4 | 批量大小:单次更新所使用的样本数量 |
| gradient_accumulation_steps | 2 | 梯度累积:用少量显存模拟更大的训练批量 |
| lr_scheduler_type | cosine | 学习率策略:动态调整学习率的变化方式 |
| warmup_ratio | 0.1 | 训练预热:在训练初期稳定学习率 |
| max_seq_length | 2 048 | 文本长度:模型能处理的最大输入长度 |
| bf16 | true | 混合精度:启用以加速训练并节省显存 |
| seed | 3 407 | 可复现性:固定随机种子,确保结果一致 |
表5 各模型在动态谣言识别任务上的表现对比Table 5 Performance comparison of various models in dynamic rumor recognition tasks |
| 模型 | F1分数 | FTCA | 逻辑可解释性 | 建议实用性 | 语言专业性 |
|---|---|---|---|---|---|
| LLaMA-3-8B-Instruct | 0.89 | 85.1 | 4.1 | 3.9 | 4.2 |
| GLM-4-9B-Chat | 0.88 | 86.5 | 4.0 | 3.8 | 4.4 |
| Qwen2-7B-Instruct | 0.90 | 87.2 | 4.2 | 4.0 | 4.3 |
| Qwen3-8B (基座) | 0.85 | 82.4 | 3.5 | 3.2 | 4.0 |
| 本研究模型 | 0.96 | 94.8 | 4.8 | 4.7 | 4.9 |
表6 消融实验结果Table 6 Ablation study results |
| 实验配置 | F1分数 | FTCA | 逻辑可解释性 |
|---|---|---|---|
| 本研究完整模型 | 0.96 | 94.8 | 4.8 |
| 去除RAG检索增强模块 | 0.92 | 90.3 | 4.6 |
| 去除增量学习机制 | 0.90 | 89.1 | 4.5 |
| 去除CoT数据格式 | 0.94 | 93.2 | 4.3 |
| 去除RAG+增量学习 | 0.88 | 85.6 | 4.2 |
表7 各类谣言主题识别准确率Table 7 Recognition accuracy by rumor topic category |
| 谣言主题类别 | 样本数/条 | 准确率/% | 典型误判情况 |
|---|---|---|---|
| 社会安全 | 820 | 96.3 | 部分夸大性表述与真实安全预警的边界模糊 |
| 健康养生 | 1 050 | 97.1 | 少数伪科学内容因引用学术术语而被误判为非谣言 |
| 科学常识 | 780 | 95.5 | 前沿科技话题因信息不确定性较高导致未知比例偏高 |
| 公共政策与民生 | 920 | 96.8 | 政策解读类内容中,部分过度解读与真实解读难以区分 |
| 食品安全 | 680 | 97.5 | 该类谣言模式固定(如“XX致癌”),模型识别效果最好 |
| 历史文化 | 420 | 93.1 | 历史事件的真伪判断依赖专业知识,模型知识覆盖不足 |
| 财经商贸 | 560 | 94.6 | 涉及市场预测的内容,真伪边界本身模糊 |
| 国际关系 | 470 | 92.8 | 跨文化语境下的信息核实难度大,权威信源覆盖不足 |
| 娱乐八卦 | 700 | 95.7 | 部分未经证实的爆料与真实八卦难以区分 |
| [1] |
|
| [2] |
|
| [3] |
郭长青, 侯勇光. 情报感知视角下社交媒体信息迷雾线索识别研究[J]. 情报杂志, 2023, 42(7): 140-146.
|
| [4] |
朱鹏, 陈晓天, 王有建, 等. 融合超图的演化博弈网络谣言传播模型研究[J]. 情报理论与实践, 2025, 48(8): 11-20.
|
| [5] |
王根生, 朱奕, 李胜. 一种融合知识图谱的图注意力神经网络谣言实时检测方法[J]. 数据分析与知识发现, 2024, 8(6): 95-106.
|
| [6] |
曾子明, 张瑜. 基于数据增强和多任务学习的突发公共卫生事件谣言识别研究[J]. 数据分析与知识发现, 2023, 7(11): 56-67.
|
| [7] |
潘杰, 王娟, 王楠. 大语言模型与谣言: 生成与检测的综述[J]. 计算机科学, 2025, 52(11): 1-12.
|
| [8] |
司赟, 苏依拉, 仁庆道尔吉, 等. 基于多模态融合和知识感知的谣言检测方法[J].计算机应用与软件, 2025, 42(10): 177-182, 221.
|
| [9] |
吴诗苑, 董庆兴, 宋志君, 等. 社交媒体中错误信息的检测方法研究述评[J].情报学报, 2022, 41(6): 651-661.
|
| [10] |
黄涛, 肖玉芝, 向洁萍, 等. 融合多层级特征表示的多领域谣言早期检测方法[J]. 情报杂志, 2025, 44(4): 127-135.
|
| [11] |
|
| [12] |
阳长征. 算法推荐语境下突发事件网络谣言信息时空泛化与共变影响研究[J]. 情报杂志, 2025, 44(5): 104-111.
|
| [13] |
石锴文, 刘勘. 突发公共卫生事件中微博谣言的识别[J].图书情报工作, 2021, 65(13): 87-95.
|
| [14] |
丁浩, 刘清, 齐江蕾, 等. 基于网络突发公共卫生事件早期谣言识别研究——以新冠疫情谣言为例[J].情报科学, 2023, 41(4): 156-163.
|
| [15] |
中国互联网联合辟谣平台. 中国互联网联合辟谣平台[EB/OL].[2026-06-23].
China Internet Joint Rumor-Busting Platform. China Internet Joint Rumor-Busting Platform[EB/OL].[2026-06-23].
|
| [16] |
陈燕方, 周晓英. 基于文本特征融合的衍生性网络健康谣言识别模型研究[J]. 图书情报工作, 2023, 67(14): 73-84.
|
| [17] |
Weibo 21 中文谣言检测数据集. Weibo21中文谣言检测数据集[DS/OL].
Weibo 21 Chinese rumor detection dataset[DS/OL].
|
| [18] |
李贺, 杨心苗, 沈旺, 等. 启发式图结构增强的社交媒体短文本谣言检测研究[J]. 情报理论与实践, 2025, 48(3): 151-159.
|
| [19] |
|
| [20] |
|
| [21] |
杨洋洋, 谢雪梅. 三元主体交互视角下网络谣言监管的博弈演化研究[J].现代情报, 2021, 41(5): 167-177.
|
| [22] |
蒋超, 朱学芳. 基于模态融合增强的谣言检测研究[J]. 数据分析与知识发现, 2025, 9(7): 26-37.
|
/
| 〈 |
|
〉 |