研究论文

社交媒体平台的公众档案需求识别—分类—预测框架研究——以知乎为例

  • 张滋荷 1 ,
  • 昌欣颖 2 ,
  • 黄体杨 , 3
展开
  • 1. 中国人民大学信息资源管理学院 北京 100872
  • 2. 吉林大学商学与管理学院 吉林 130012
  • 3. 云南大学历史与档案学院 昆明 650091
黄体杨,副教授,博士,E-mail: 。

作者贡献声明/Author contributions:

张滋荷:负责数据采集、清洗与分析,设计研究方案,进行实证研究,撰写与完善论文;

昌欣颖:参与实证研究,辅助完成资料收集与论文撰写;

黄体杨:设计研究命题,提出研究方案,修改论文与定稿。

张滋荷,博士研究生;

昌欣颖,硕士研究生。

收稿日期: 2026-03-21

  网络出版日期: 2026-08-26

Research on the Framework of Public Archival Demand Identification, Classification and Prediction on Social Media Platforms: A Case Study of Zhihu

  • Zhang Zihe 1 ,
  • Chang Xinying 2 ,
  • Huang Tiyang , 3
Expand
  • 1. School of Information Resource Management, Renmin University of China, Beijing 100872
  • 2. School of Management, Jilin University, Jilin 130012
  • 3. School of History and Archives, Yunnan University, Kunming 650091
Huang Tiyang, Associate Professor, PhD, E-mail: .

Zhang Zihe, Doctoral Candidate;

Chang Xinying, Master's Candidate.

Received date: 2026-03-21

  Online published: 2026-08-26

摘要

[目的/意义] 针对现有档案需求研究多聚焦机构层面、对公众个体化和场景化档案诉求刻画不足的问题,以社交媒体平台用户生成内容为研究对象,构建面向公众档案需求的“识别—分类—预测”分析框架,为档案服务精准供给与动态适配提供方法支撑。[方法/过程] 以知乎平台档案相关问答文本为语料,综合运用BERTopic主题模型、人工核验与大语言模型辅助语义归纳方法,识别公众档案需求主题并完成类别归并;进一步基于各类别月度频次构建时间序列,比较SARIMA与Prophet模型的预测效果,并对未来短期需求变化进行预测。[结果/结论] 研究发现,公众档案需求可归纳为人事档案流转与凭证类需求,机构日常档案管理类需求,监督、合规与问责类档案需求3类,分别对应个人事务办理、机构运行管理和治理监督问责3个层面。时序分析显示,人事档案流转与凭证类需求和机构日常档案管理类需求具有长期基础性和周期性特征,监督、合规与问责类档案需求则具有较强事件驱动性。研究结果表明,社交媒体平台能够有效反映公众真实的档案诉求,语义主题模型与时间序列模型的结合可为档案部门开展需求感知、资源配置和人事档案智能化服务提供参考。
本文引用格式

张滋荷 , 昌欣颖 , 黄体杨 . 社交媒体平台的公众档案需求识别—分类—预测框架研究——以知乎为例[J]. 知识管理论坛, 2026 , 11(4) : 352 -365 . DOI: 10.13266/j.issn.2095-5472.2026.030

Abstract

[Purpose/Significance] To address the limitations of existing archival demand studies, which have mainly focused on the institutional level and paid insufficient attention to individualized and scenario-based archival needs among the public, this study takes user-generated content on social media platforms as its research object and constructs an “identification-classification-prediction” analytical framework for public archival demand, providing methodological support for the precise provision and dynamic adaptation of archival services. [Method/Process] Using archival-related Q&A texts from Zhihu as the corpus, this study integrated the BERTopic topic model, manual verification, and large language model-assisted semantic induction to identify public archival demand topics and consolidated them into categories. Furthermore, monthly frequencies of each category were used to construct time series, the forecasting performance of SARIMA and Prophet models was compared, and short-term future changes in demand were predicted. [Result/Conclusion] The results show that public archival demand can be summarized into three categories: personnel archive circulation and credential-related demand, institutional routine archive management demand, and archive demand related to supervision, compliance, and accountability, corresponding respectively to personal affairs handling, institutional operation and management, and governance supervision and accountability. Time-series analysis indicates that personnel archive circulation and credential-related demand, as well as institutional routine archive management demand, exhibit long-term foundational and periodic characteristics, while archive demand related to supervision, compliance, and accountability is strongly event-driven. The findings suggest that social media platforms can effectively reflect the public's real archival needs, and that combining semantic topic models with time-series models can provide references for archival departments in demand sensing, resource allocation, and the optimization of intelligent personnel archive services.

随着智慧城市与数字政府建设的推进,档案服务正从传统的静态保存转向现代化的动态供给,在行政透明、人才流动、文化传承等场景中持续释放价值。要提供更有针对性的服务,档案机构首先需要准确把握用户的真实档案需求。然而,在互联网环境下,公众获取档案的方式已从到馆查阅转向线上检索与即时交互,需求随之呈现出个性化、多样化与场景化的特征:用户期望借助便捷的检索入口与智能推荐,高效获取精准的档案信息。知乎作为问答型社交平台,其用户生成内容能够反映公众对档案议题的关注程度,揭示日常生活与职业发展场景中的档案需求及痛点。因此,对这类内容开展主题提取与动态感知预测,对于优化档案服务、实现精准供给具有重要意义。
当前档案需求研究多聚焦于权力机构与档案事业的宏观机制,方法多为问卷调查与深度访谈。这一取向有其合理性,但公众个体层面的微观档案诉求长期缺乏系统刻画,其困难有以下三方面:一是公众的档案诉求大量发生于日常生活中,如升学就业、考公政审、人事调转、归档维权等真实场景,公众往往会从网络中寻求帮助,但这类碎片化、弥散于现实事件中的诉求,传统调研手段难以实现广覆盖的系统捕捉;二是问卷与访谈的预设框架带有较强的样本引导性,难以捕捉公众自发、情境化的真实表述;三是公众并非被动的利用者,而是兼具形成者、保存者与利用者多重身份,其需求横跨档案的形成、整理、保管与利用全流程,传统的调研范式难以完整覆盖。因此,如何获取广覆盖、场景化的数据以刻画公众的微观档案需求,成为本研究的核心切入点。
本文所指的“公众档案需求”,是公众作为档案的形成者、保存者与利用者,在档案形成、整理、保管和利用4个环节中产生的认知、诉求与求助。已有研究指出,文件与档案的形成者几乎涵盖全体社会成员,即“人人都是档案工作者”,公众档案现象贯穿档案生命周期全过程;而现行以档案法治意识、保护与利用意识、家庭建档意识为主的宣传框架,难以充分覆盖新时代全社会的真实档案需求[1]。据此,本研究将公众档案需求置于形成、整理、保管、利用的全流程视角下加以识别与分类,以期弥补以往研究对公众微观、馆外档案诉求刻画的不足。
为此,本研究在内容上以更具真实性、广泛性与隐蔽性的用户生成内容为基础,分析个体社会生活中普遍存在的相关问题,识别其主题结构并分析其社会现实影响;在方法上将定量、定性与大语言模型辅助相结合,运用主题建模与时间序列预测技术,构建公众档案需求的“识别—分类—预测”分析框架,既把握当前的需求格局,又预测其短期演化趋势。总的来说,本研究重点回答两个问题:一是社交媒体平台中公众表达的核心档案需求包含哪些范畴,可为档案机构提供何种参考;二是如何依托“识别—分类—预测”框架,构建兼具预警与决策支持功能的需求动态感知机制,从而提升档案服务的前瞻性与适配性。

1 相关研究/Literature review

1.1 档案需求研究与服务模式演化

在档案服务内容方面,国际上档案服务的发展趋向于数字化、开放性、用户中心化,包括利用人工智能、大数据分析和在线交互等技术手段以提升用户体验[2]。例如,美国国家档案馆等提供档案开放获取与远程查阅等功能,法国将网络档案作为一种新型档案进行服务开发。另外,也有学者强调档案工作者在档案服务中关键但易被忽略的作用[3]。
在用户需求分析方面,国外档案馆普遍利用Google Analytics、用户热图等数据分析工具监测用户行为,以优化档案检索和界面设计。另外,他们更强调用户参与模式,如英国的众包档案标注法鼓励公众在线标注档案,以提高档案的利用率。另外,C. L. Borgman等[4]认为数据存档的贡献与用户需求方面存在持续的不平衡,导致存档消耗的物力人力资源较多。
在档案领域的用户研究方面,E. Freeman早在1984年就在《美国档案学家》[5]中提到,档案工作者要从用户的角度进行档案管理。C. L. Borgman等[4]通过访谈和调查来研究在实体和数字档案馆背景下用户特征的认知和社会档案素质,为专业档案工作者构建了能力框架;E. Tansey[6]将社交媒体的用户生成内容作为用户个人存档的方式之一,探究用户档案管理的问题。
总而言之,国际上的档案服务更关注用户的需求,强调通过与用户互动来增强档案的可利用性。此服务方式对我们有借鉴意义,但需要从我国的国情和档案管理制度出发,重新梳理本土用户的档案需求,为我国的档案服务拓宽路径。
在国内档案学研究中,档案信息需求领域成果显著。常愉[7]从用户需求视角出发,系统梳理发现档案需求包括获取的便利性、利用的个性化、产品的多样化以及对档案服务的深度参与,并据此提出适配高校档案服务场景的优化策略。在档案产业市场研究方面,徐拥军等[8]基于市场调研与实证分析发现,当前档案产业市场需求集中于档案整理、档案数字化加工、档案管理咨询等核心专业服务范畴。在档案需求研究方法上,叶然·吐尔逊江等[9]以5种服务质量差距模型为分析工具,开展档案服务质量评估;靳文君等[10]聚焦档案信息供需失衡问题,指出档案信息开放性不足是导致该问题的关键症结,进而提出利用人工智能与大数据分析技术提升档案服务质量。在档案信息服务层面,崔旭等[11]从技术驱动视角切入,探究智慧档案平台赋能档案服务转型的优化路径,以提升档案服务效率。
总的来说,现有研究存在三方面不足:首先,政府机构、机关单位仍是主要档案需求调研方,而公众个人在社会生活场景中的档案诉求尚未得到系统刻画;其次,档案的满意度调查常通过问卷填写或模型框架等方式,问卷设计的预设框架在面对个体化、情境化的微观诉求时存在天然局限;再次,需求内容研究多从宏观政策视角观察档案资源开发与利用,但档案需求的真实源头多来自个体微观情境。

1.2 用户生成内容的主题分析方法

用户生成内容在档案、信息科学等领域受到了越来越多的重视。其不仅体量庞大,更新迅速,还承载着用户意图、情感与行为模式等多维信息,因此成为开展主题分析的重要源泉。
许多学者提出了用户生成内容的主题分析方法,主要路径分为两种:一是侧重于从大量文本中自动提取主题的定量方法。潜在狄利克雷分配(latent Dirichlet allocation,LDA)[12]作为生成式概率模型,将文本视为若干主题的集合,并由关键词的概率分布代表相关主题。BERTopic[13]结合BERT嵌入与主题聚类算法,生成语义一致且易于解释的主题并实现可视化。在政务数据的主题挖掘中,程越欣等[14]基于BERTopic模型对政府数据开放领域文献展开了主题分析,实现了关注方向的挖掘。二是随着模型技术的进步,多数研究逐渐采用定量与定性相结合的方法来实现主题分析。例如,金燕等[15]结合LDA主题模型、主题词网络的创新性与传播性分析政策的嬗变逻辑,揭示了数据要素政策主题的嬗变逻辑和扩散动向;纪潇玲等[16]基于结构主题模型(structural topic model,STM)探究了图书馆学和情报学30年来的整体发展态势、主题偏好以及差异对比。同时,大语言模型也深入应用到相关研究之中,如曹雅宁等[17]通过“人工标注+LLM辅助+人工核验”方法标注社会纠正和非社会纠正评论,进而挖掘社会纠正评论的内容特征。

1.3 主题时序预测方法

时序预测作为数据挖掘与机器学习领域的重要研究方向,长期以来在金融、医疗、交通、社会舆情等领域得到广泛应用。其核心逻辑在于通过历史数据构建预测模型,推断未来发展趋势,进而为决策制定提供辅助支持。随着大数据技术与深度学习理论的兴起,传统统计模型在时序预测领域逐渐被神经网络驱动的预测方法所补充与拓展。其中,主题时序预测作为信息服务场景中的重要研究热点,通过模型拟合与预测分析,刻画主题随时间维度的演化轨迹,精准识别特定主题的周期性波动特征与突发性变化规律。
目前,已有研究将时序与主题协同构建以预测主题的发展趋势,如动态主题模型(dynamic topic model, DTM)[18]假设文档集按时间顺序组织,以揭示主题在不同时间点的变化趋势。D. A. Dobariya等[19]利用神经网络模型实现动态主题出现频率建模,预测社交媒体中的主题在未来的变化趋势。
而在传统时序模型应用方面,陈煜杰等[20]在科技文献发表数量预测研究中,基于主题热度的周期性特性选用季节性自回归积分滑动平均模型(seasonal autoregressive integrated moving average,SARIMA)进行预测,实验比较结果表明,SARIMA模型性能优于自回归积分滑动平均模型(autoregressive integrated moving average,ARIMA),其对季节性数据具有良好适应性;G. O. Ferreira等[21]也指出,在网络流量预测场景中,将SARIMA模型与聚类分析相结合处理周期性流量数据,其效果显著优于非季节性模型。此外,针对主题模型与特定时序模型的融合应用,张鑫等[22]进一步提出结合LDA主题模型与Prophet时间序列预测的框架,通过计算内容、共现及趋势相似度来衡量主题关联性,并借助Prophet的Logistic增长模型预测主题强度的演化趋势。M. Daraghmeh等[23]亦指出,Prophet模型尤其适合处理具有明显季节性、节假日效应的时间序列数据,如社交媒体话题热度、科研论文发表趋势等。
Y. Hua等[24]研究指出,基于长短期记忆网络(long short-term memory,LSTM)等深度学习模型的方法能有效捕捉非线性趋势、季节性波动和突发事件模式,显著优于传统线性模型。在主题预测层面,Y. Mehta等[25]提出利用LSTM趋势预测模型,从社交媒体非结构化文本数据中预测技术演变趋势;与之类似,Y. Miao等[26]提出了一种基于神经变分推理的主题建模方法,通过循环网络和破棒结构实现可扩展的无限主题发现,并在多个文本数据集上验证了其高效性与有效性,与利用神经网络对主题进行建模类似。相较于现有研究,本研究侧重于通过时序模型实现聚合主题的时序构建与短期预测,同时将时序预测模型融入公众需求识别与分类的研究体系,最终为档案服务领域提供精准的需求预测及决策支持。

2 研究设计/Research design

2.1 用户需求主题建模

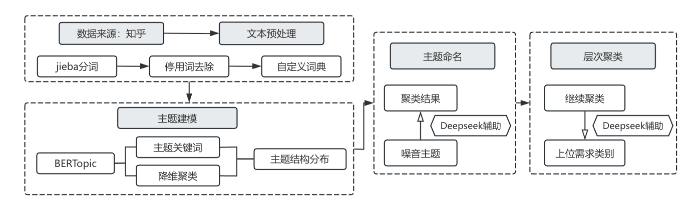
本研究采用语义主题建模方法识别用户在社交媒体平台上关于档案的具体需求认知以及潜在主题结构,研究框架见图1。
图1 步骤1:用户需求主题建模

Figure 1 Step 1: user demand topic modeling

首先,本论文选取知乎社交媒体平台数据作为数据来源,通过“档案”“档案查询”“档案利用”等关键词对问答内容进行批量爬取和人工初步筛选。同时,引入DeepSeek-Chat大语言模型对语料进行语义层面的初步过滤,以提高主题聚类的准确性,确保用于建模的文本与档案需求相关主题具有较高相关性。
在文本预处理阶段,采用分词工具对文本进行标准中文分词处理,利用停用词表剔除“后来”“首先”等无效高频词。同时,为了提升模型对档案领域关键词的识别效果,确保后续主题建模能够保留文本中的专业语义特征,本论文整合数据和《档案学名词》[27]等专业资料构建的术语词典作为用户自定义词典,最终收录有效短语616个。
在主题建模环节,本研究采用基于Transformer架构的BERTopic模型,该模型通过上下文感知嵌入捕获语义,并利用密度聚类实现无监督主题识别,尤其适用于处理中文文本中复杂、细粒度的需求表述。在整体方法链条中,BERTopic承担语义聚类与层次结构识别的核心任务。基于此,对模型输出的多维空间进行降维与聚类分析,并提炼出用户的档案需求在语义空间中的结构性模式。
在主题命名过程中,为了解决传统主题建模方法在处理社交媒体用户生成内容时出现的主题分散、语义碎片化等问题,本研究采用DeepSeek-Chat作为BERTopic聚类后的主题识别处理工具。需要注意的是,DeepSeek大语言模型仅承担辅助归类命名(DeepSeek-R1)与噪声文本筛选(DeepSeek-Chat)两类受限任务,且所有输出内容均经人工核验。具体而言,在完成文本聚类和主题分类后,一方面根据主题关键词和代表性文本进行主题命名,并辅以人工修正;另一方面,将BERTopic模型判断为噪声的文本数据重新提取,通过构建标准化Prompt模板对原始文本内容进行分类,并辅以人工审核完成原有主题归并。为保证可重复性,所有LLM调用均采用固定参数,保留原始输入输出日志,并由两名研究者独立核验,不一致处经讨论裁定。
用于主题命名的标准化提示词模板示例如下:“你是一名档案学领域研究员。以下是一组通过BERTopic聚类得到的文本片段,及其代表关键词:{关键词列表};代表性文本:{文本片段}。请基于上述信息,用10个汉字以内概括该主题,命名须能反映其核心档案事务或相关诉求,不出现停用词、噪音词等。”
在层次聚类分析环节,本研究进一步对初步建模生成的主题结果开展结构重组,构建更高层级的档案用户需求分类体系。该过程能够有效整合海量碎片化的档案用户表述信息,并提炼出稳定的档案需求结构,为后续档案用户需求动态趋势建模工作奠定了清晰的主题语义基础。

2.2 用户需求的动态预测

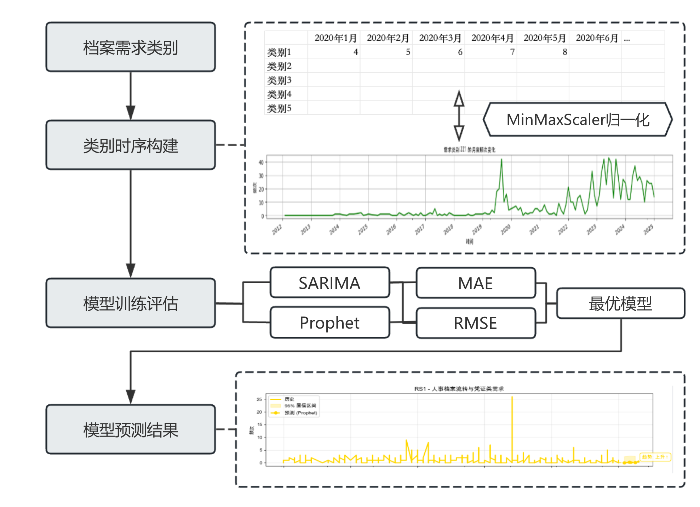
由于BERTopic中的动态时序功能输出的是主题代表关键词随时间的漂移可视化,并不能提供未来的点预测与置信区间,因此本研究另行选择SARIMA、Prophet时间序列建模方法,对2012—2025年间不同大类的主题月度频次变化进行分析并进行未来3个月的趋势预测。研究目标主要包括:一是比较经典计量经济时序模型与基于贝叶斯思想的结构化时序模型在短期预测中的表现差异;二是检验不同类别需求在时间维度上的趋势与季节性特征;三是基于模型结果,为未来3个月的变化趋势提供定量预测与置信区间估计,见图2。
图2 步骤2:用户需求动态预测

Figure 2 Step 2: Dynamic prediction of user demand

首先,对原始数据进行标准化处理:将时间序列统一为月度频率,并采用零项填充等方式修正缺失值,保障数据连续性与可比性。随后按时间顺序划分实验样本,将最近若干个月数据设为测试集,其余作为训练集,以此评估模型短期预测的稳定性与准确性。
其次,在建模阶段,研究选取两类主流时间序列模型进行拟合与预测:一是基于Box-Jenkins框架的SARIMA模型;二是Facebook的Prophet模型,该模型以加性分解思想为核心,可将时间序列拆解为趋势、季节性及假期效应等组成部分。所有模型均基于训练数据进行参数学习,生成未来3个月预测结果及对应置信区间,代表预测不确定性范围。
上述模型预测结果可用于分析知乎平台用户档案需求的结构性演化特征,进而为档案管理实践中的内容推荐、资源调配及服务实时优化提供可量化依据。

3 实证分析/Empirical analysis

3.1 数据来源与概况

本研究的数据来源于知乎平台,选取“档案”“档案查找”与“人事档案”等多个关键词进行内容检索与筛选,利用Python和八爪鱼软件爬取了与档案需求话题相关的问答内容,时间截至2025年1月30日。初步获取的回答数据共计4 914条,经人工清洗与去重后,保留有效文本4 003条。为进一步聚焦档案需求相关内容,考虑到互联网平台中提及“档案”的内容未必都指向真实档案需求,本研究在去重后增设一道语义相关性筛选:以DeepSeek-Chat对每条文本判断其是否表达与档案管理、政务应用相关的实际诉求,并辅以两名研究者人工核验,对模型判定结果不一致处经讨论裁定,最终保留相关文本2 331条。该步骤旨在剔除仅在话题层面提及但无实质档案诉求的内容,确保后续建模语料与研究对象一致,数据概况见表1。
表1 数据概况

Table 1 Data overview

时间 文本内容 文本分词
2022/10/13 有权的,他们(档案管理员)接受了档案以后,是要查看具体内容的,然后完成档案的整理和登记,如果有不符合条件的材料,会联系你本人补材料 有权、接受、档案、查看、具体内容、档案、整理、登记、符合条件、材料、补、材料
2021/3/25 人事档案在网上是否能查询要看当地是否已经完成了档案数据数字化。如果有数字化系统是可以在线查询的。如果没有数字化,就需要电话或者去窗口去查询了 人事档案、网上、查询、档案、数据、数字化、数字化、系统、在线、查询、数字化、电话、窗口、查询
2024/1/29 基层员工,基本不会查,甚至档案也不是放公司,而是放在人才市场。只有一定的级别才有可能查档案或者放在公司 基层、员工、查、档案、放、公司、放在、人才、市场、级别、查档案、放在、公司
本研究主要采用jieba分词工具对文本进行中文分词处理,并基于实际语料构建停用词表,去除无实义的高频词。与此同时,为提高模型对专业语义的识别精度,特别引入由《档案学名词》[27]等专业资料整理形成的档案术语词表,作为用户自定义词典加入分词过程,以提升专业领域术语的整体识别效果。此部分数据作为后续文本分析的语料基础。

3.2 用户需求识别

3.2.1 主题提取结果

BERTopic模型基于BERT嵌入与主题聚类,能够从大规模文本中提取潜在主题结构及其支撑关键词,辅助理解海量文本数据中的主要讨论内容与主题分布。应用该模型对收集的知乎文本数据进行识别,提取出多个相关主题及其代表性关键词,并利用DeepSeek-R1模型基于主题代表性关键词和文本形成规范化主题名称,见表2。
表2 BERTopic模型的主题分析

Table 2 Topic analysis of the BERTopic model

主题编号 主题名称 代表关键词
0 人才中心档案补办 ['人才', '单位', '中心', '补办', '存档', '学校', '人事档案', '材料', '毕业', '死档']
1 部门档案管理需求 ['领导', '工作', '材料', '部门', '单位', '体制', '岗位', '办公室', '组织部']
2 低负荷部门运行 ['单位', '清闲', '办公室', '工作', '部门', '领导', '上班', '岗位', '业务']
3 家庭档案管理规范 ['档案袋', '女儿', '孩子', '母亲', '父母', '封条']
4 组织部办公室事务档案 ['组织部', '打印', '办公室', '单位', '领导', '档案馆']
5 档案管理证书报考 ['档案管理', '人事档案', '材料', '证书', '报考', '档案管理员', '文件', '管理']
6 毕业生档案查询 ['学校', '毕业', '查询', '毕业生', '就业', '单位', '人才市场', '中心', '人才']
7 公务员录用政审档案 ['录用', '政审', '公务员', '学校', '材料', '处分', '取消', '影响']
8 档案馆等参公单位工作 ['档案馆', '辖区', '存档', '老干部', '离休', '参公']
9 公务员考录入职档案 ['公务员', '考上', '单位', '工作', '入职', '考录']
10 人事档案智能化需求 ['人事档案', '管理', '智能', '软件', '功能', '信息', '企业', '员工']
11 档案工作人才市场咨询 ['档案工作', '人才市场', '档案管理', '档案袋', '评语', '托管']
12 政审档案材料审核 ['咨询', '材料', '人事档案', '审核', '行政拘留', '单位', '学校']
13 档案去向查询咨询 ['档案在哪里', '毕业', '户籍地', '查询', '人才', '流动']
14 人才单位档案调转 ['人才', '单位', '考察', '同学', '学校', '户籍地', '调转']
15 公务员违纪处分档案 ['违纪', '警告', '违反', '处分', '公务员', '纪律处分', '旷工', '违规']
16 数字档案权限管控 ['管理', '权限', '系统', '数字档案馆', '智能', '利用', '文档']
17 人事档案数字化管理 ['纸质', '电子档案', '档案数字化', '电子化', '干部人事']
18 税务干部培训档案 ['税务局', '干部学校', '税务', '干部', '培训']
19 违纪举报档案案例 ['举报', '浏览', '疫情', '党内', '纪委', '警告', '单位']
可见,知乎用户讨论的档案主题内容覆盖广泛,既包括与档案流转、调阅、归档相关的具体事务处理与实际需求,如人才中心档案补办、毕业生档案查询与公务员政审档案等,也包括反映档案管理现代化趋势的主题,如数字档案权限管控、人事档案智能化需求等。此外,个别主题如家庭档案管理规范、违纪举报档案案例还涉及社会生活中的档案应用场景。这一步将收集到的零散数据转化为可归类的需求单元。

3.2.2 主题语义空间可视化

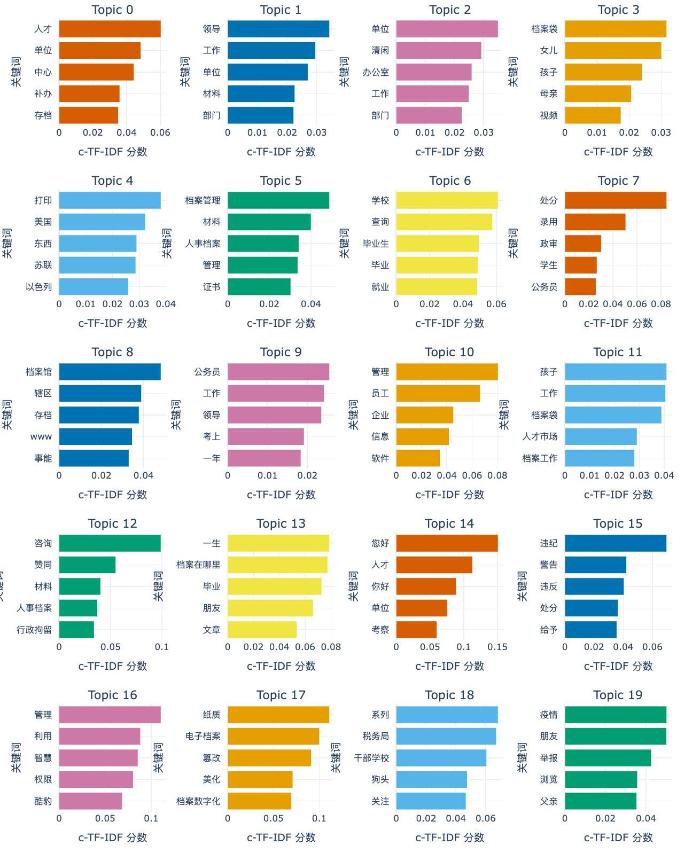
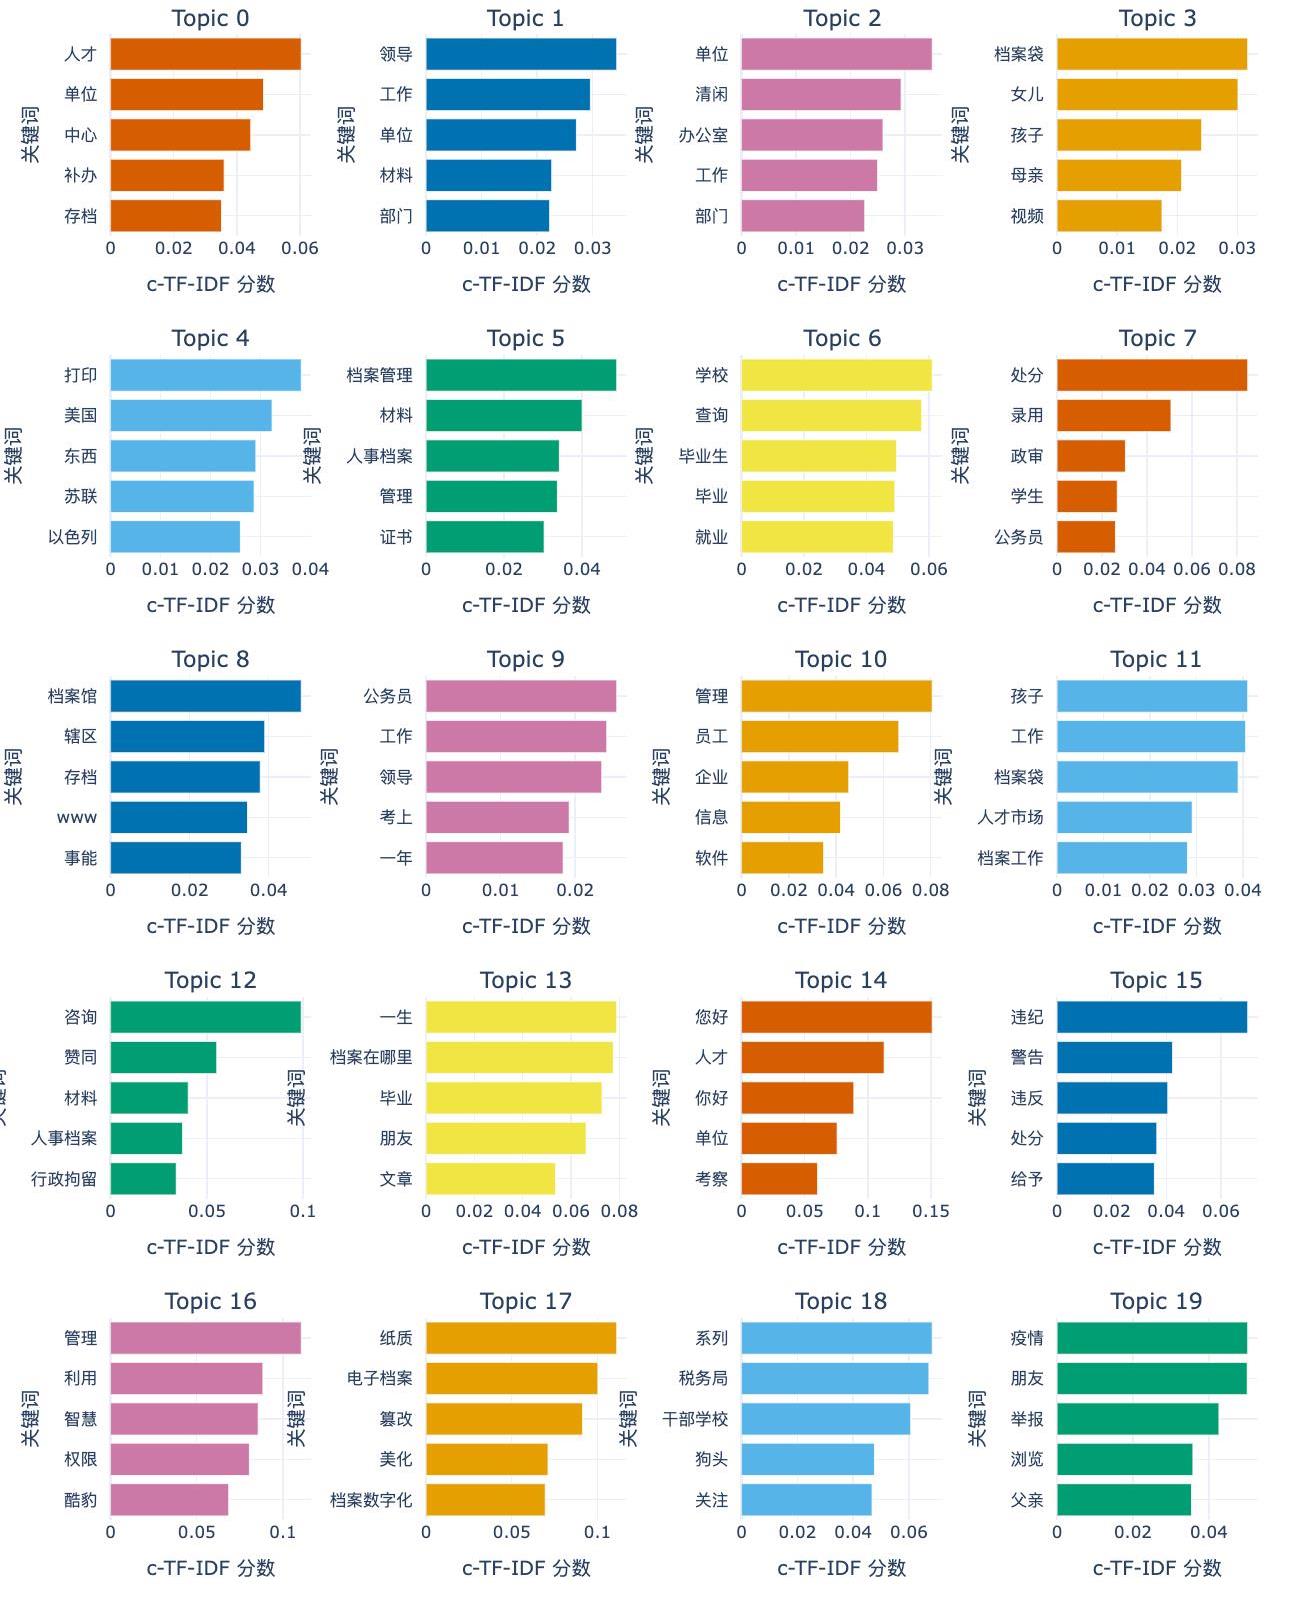
本研究基于BERT语义嵌入、UMAP降维、HDBSCAN聚类与c-TF-IDF关键词提取的BERTopic主题关键词分布,将各主题高权重关键词进行可视化呈现(图3)。这种可视化以条形图为载体,直观呈现各主题关键词的权重分布特征,直观揭示各主题的语义核心词汇,为解析主题内容构成及主题间差异提供直观支撑,有助于理解每个主题的内容构成和差异性。
图3 基于BERTopic的20个主题及其关键词分布

Figure 3 Distribution of 20 topic keywords based on BERTopic

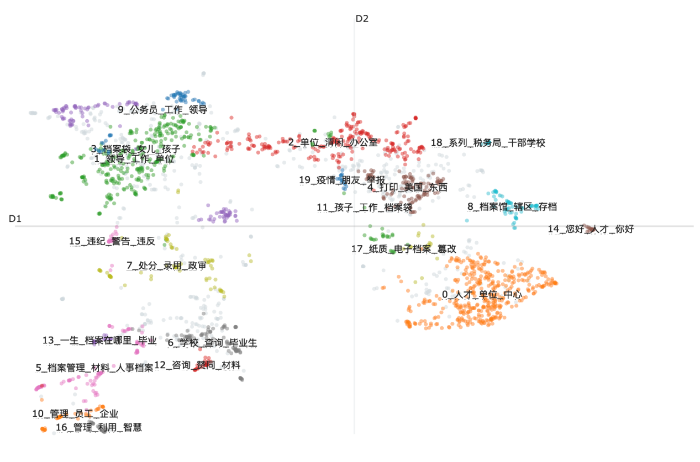
图4通过对档案需求文本进行语义嵌入与二维降维展示,揭示了不同需求子类在语义空间中的相对位置与聚类关系。从整体分布上看,20个需求主题呈现出若干明显的主题簇,体现出良好的语义可分性。
图4 基于BERTopic的主题分布

Figure 4 Topic distribution map based on BERTopic

同时,各主题在二维语义空间中呈现出较为明显的聚集与分化特征。首先,基础档案管理与规范类主题在左上区域形成较密集分布。主题1“部门档案管理需求”、主题3“家庭档案管理规范”与主题9“公务员考录入职档案”位置较为接近,说明这类文本主要围绕档案管理要求、档案规范、入职建档等基础性问题展开,语义关联度较高,属于档案管理需求中较为集中的核心板块。
其次,人事档案办理与流转类需求在图中右下及中部区域较为突出。主题0“人才中心档案补办”形成规模较大的独立聚类,表明档案补办类问题在用户咨询中占有较高比重;主题14“人才单位档案调转”、主题17“人事档案数字化管理”以及主题11“档案工作人才市场咨询”分布在其周边或相邻区域,显示出人才服务、档案调转、档案数字化管理等议题之间存在一定语义联系。这说明用户在实际办理过程中,更关注档案遗失补办、单位接收、人才市场托管及线上化管理等具体事务。
再次,政审、毕业生档案与公务员录用相关主题主要集中在左下区域。主题6“毕业生档案查询”、主题7“公务员录用政审档案”、主题12“政审档案材料审核”、主题13“档案去向查询咨询”以及主题15“公务员违纪处分档案”相互距离较近,反映出毕业去向、考录政审、材料审核和档案查询等需求在语义上具有较强关联。这类主题通常与升学就业、公务员录用、政审审查等关键节点相关,说明特定身份转换阶段的档案需求较为集中。
此外,机关单位事务类主题在图中部至右侧形成相对独立的分布,部分技术性和新兴议题表现出一定离散性。这些关键词的重要性排序及集中程度可辅助主题命名与优化,提升主题内容概括的精准度,并为后续主题结构评估与档案需求类别划分奠定坚实基础。

3.3 用户需求分类

3.3.1 需求类别的静态语义分布

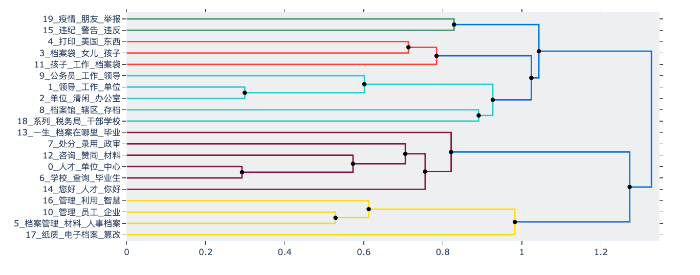
BERTopic模型可根据聚类路径反映档案需求现实表述中的自然语义分化趋势,如图5的主题层次聚类所示,其呈现了20个主题的分布特征与关联程度。依据图中聚类路径着色规则,可识别出绿色、红色、蓝色、紫色、黄色5个主要簇。
图5 BERTopic模型的主题层次聚类

Figure 5 Topic hierarchical clustering diagram of the BERTopic model

其中,5个颜色的簇对应5个上位类别。然而,鉴于BERTopic的聚类结果中存在与档案需求弱相关及跨主题交叉的情况,本研究在层次聚类确定结构骨架后,增设一道人工核验环节:由研究者依据档案功能相关性(主题代表文本是否表达明确的档案形成、整理、保管或利用诉求)与所属档案业务环节两项标准,对20个二级主题逐一判定,对相关性弱的主题剔除或降权,对语义跨簇的主题按其档案业务实质重新归并为三大类需求。
在3类结构已确定的前提下,DeepSeek-R1根据各簇内的主题关键词与代表性文本进行语义归纳与类别命名。这种分工使得分类的结构性决定权由可复现的BERTopic算法承担,LLM仅承担受限的语义归纳任务,由此降低商业大模型版本迭代对结果可复现性的影响。
最终归纳出3类语义相近的主题群组,分别为人事档案流转与凭证类需求、机构日常档案管理类需求、档案监督、合规与问责类需求,见表3。
表3 基于BERTopic模型的档案需求聚类结果

Table 3 Clustering results of archive demand based on the BERTopic model

名称代码

主题编号与名称(人工核验后)

需求类别名称 人工调整说明 文本数量/条

RS1

0_人才中心档案补办
6_毕业生档案查询
7_公务员录用政审档案
11_档案工作人才市场咨询
12_政审档案材料审核
13_档案去向查询咨询
14_人才单位档案调转
17_人事档案数字化管理

人事档案流转与凭证类需求

本类主要整合与个人人事档案形成、查询、补办、调转、托管、政审及数字化管理相关的主题。虽然各主题涉及毕业、就业、政审、人才市场等不同场景,但其核心均指向个人档案在流转过程中的凭证使用与服务办理需求,因此合并为同一类别

846

JG2

1_部门档案管理需求
4_组织部办公室事务档案
8_档案馆等参公单位工作
10_人事档案智能化需求
16_数字档案权限管控
18_税务干部培训档案

机构日常档案管理类需求

本类主要聚焦机关、企事业单位及参公单位在日常运行中的档案管理需求,包括部门材料管理、组织部办公室事务、档案馆工作、干部培训档案、系统权限管控及智能化管理等内容。相关主题共同体现出机构层面的文书归档、材料管理、流程运行与数字治理需求

691

JD3

3_家庭档案管理规范
5_档案管理证书报考
9_公务员考录入职档案
15_公务员违纪处分档案
19_违纪举报档案案例

监督、合规与问责类档案需求

本类主要围绕档案在合规审查、资格准入、纪律处分和监督问责场景中的使用需求展开。其中,家庭档案管理规范涉及档案袋封存与材料完整性问题,档案管理证书报考体现从业合规要求,公务员考录入职、违纪处分及举报案例则体现档案在身份审查、纪律监督和责任追溯中的凭证功能

330

剔除项

2_低负荷部门运行
-1_未分类离群点

弱相关/噪音主题

该主题关键词主要集中于“清闲”“上班”“岗位”“部门”等职业体验或岗位运行话题,缺乏明确的档案办理、档案管理或档案利用诉求,故不纳入档案需求类别框架

287+177
人事档案流转与凭证类需求(RS1)主要聚焦于人事档案在补办、查询、调转、归档、政审审核与凭证利用等环节中的现实诉求,涵盖人才中心档案补办、毕业生档案查询、公务员录用政审档案、政审材料审核、人才单位档案调转等主题。该类需求呈现出明显的个人事务链条特征,突出档案在人生阶段转换、就业流动、政审录用与身份确认中的凭证功能,是公众档案需求中最具基础性和高频性的语义聚合块。典型表达群体为应届毕业生、考公考编人员、政审环节当事人、档案调转中的职场人员以及人事档案管理相关人员。
机构日常档案管理类需求(JG2)主要聚焦于机关单位、参公单位及相关组织在日常运转中的档案管理事务,涵盖部门档案管理需求、组织部办公室事务档案、档案馆等参公单位工作、人事档案智能化需求、数字档案权限管控与税务干部培训档案等主题。该类需求呈现出典型的机构性和事务性特征,强调文书材料归档、干部档案维护、单位内部档案流转、培训记录保存以及数字档案系统权限治理之间的协同关系,是组织运行过程中管理型档案需求的集中体现。典型表达群体为机关单位文书人员、组织部门工作人员、档案馆及参公单位职员、干部培训管理人员与数字档案系统使用者。
监督、合规与问责类档案需求(JD3)主要聚焦于档案在监督管理、合规审查、责任追溯与制度问责场景中的利用诉求,涵盖家庭档案管理规范、公务员考录入职档案、公务员违纪处分档案、违纪举报档案案例、档案管理证书报考等主题。该类需求虽然覆盖家庭、职业准入、违纪处分、举报案例和行业整改等多元场景,但其共同指向在于档案的证据属性、规则约束与责任确认功能,体现出档案作为制度执行依据和合规凭证的治理价值。典型表达群体为公务员考录与入职人员、受处分或被审查人员、举报事件相关公众、档案从业资格报考者、家庭档案纠纷当事人以及城建档案整改相关人员。
基于上述3种档案需求类别的静态空间聚类结果,下面将映射到时间序列维度,以探究不同类别需求的出现频次随时间变化的动态趋势。

3.3.2 需求类别的动态时序构建

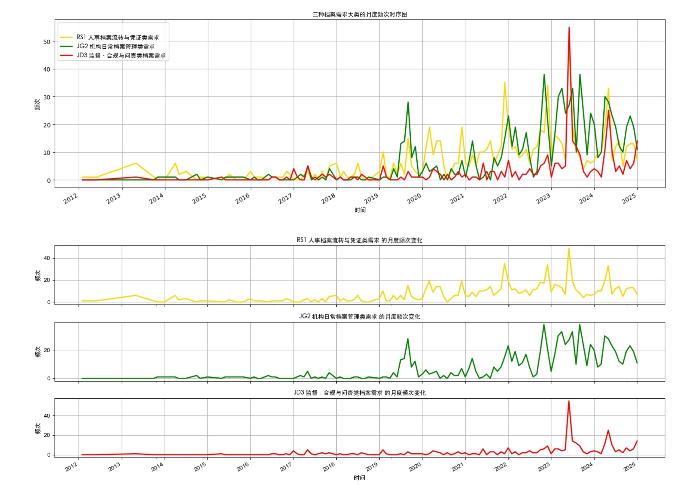
为揭示3类档案需求大类在时间维度上的演化差异,本研究基于人工核验后的需求类别归并结果,结合文本发布时间构建月度频次时间序列,并分别对人事档案流转与凭证类需求(RS1)、机构日常档案管理类需求(JG2)以及监督、合规与问责类档案需求(JD3)进行统计与可视化。
从图6可以看出,3类需求在2012—2018年间整体处于低频零散状态,说明早期社交平台中公众对档案议题的集中表达尚不明显;2019年以后,各类需求频次逐步提升,并在2021年后呈现出更强的波动性和阶段性集聚特征,反映出档案事务逐渐进入公众线上求助与讨论空间。
图6 不同需求类别的时序分布

Figure 6 Temporal distribution of different demand categories

具体来看,RS1属于长期基础型需求,其月度频次持续存在并多次形成峰值,主要与毕业生档案查询、人才档案调转、公务员政审材料审核等周期性事务相关,显示出人事档案在升学就业、考公考编和职业流动中的高频凭证功能。JG2在2019年前后开始出现明显增长,并在2022—2024年间进入高位波动阶段,表明机关单位、参公单位及组织部门在日常文书归档、干部档案管理、培训档案保存和数字权限管控等方面的讨论热度不断增强,体现出机构运转中档案管理需求的持续释放。JD3整体基数相对较低,但具有突发性强、峰值集中的特点,尤其在2023年前后出现显著爆发,说明家庭档案私拆、违纪处分、举报案例、入职审查和整改问责等事件型议题容易引发公众集中关注。
总体而言,3类需求共同呈现出基础事务需求持续存在、机构管理需求稳步增强、监督问责需求事件驱动爆发的动态格局,说明公众档案需求已由单一的人事流转事务逐渐扩展至组织治理、合规监督与责任追溯等更复杂的档案应用场景。

3.4 用户需求预测

3.4.1 时序预测模型训练与评估

本研究采用SARIMA模型与Prophet模型,对各档案需求类别的月度时间序列开展建模与预测。首先,对原数据进行预处理,包括将2012年至2025年1月的日期字段规整为月初时间戳,并将其按时间序列排序;继而采用零项填充法补全缺失值,以保障时间序列的连续性与稳定性。最后按时间先后顺序,将序列末端最近6个月数据设为测试集,剩余部分作为训练集,用于检验模型在短期滚动预测中的外推性能。
在SARIMA模型设计中,考虑到数据具有显著的年度季节性特征,本研究将季节长度参数m设定为12(对应月度数据的年度周期)。差分阶数d(非季节差分)与D(季节差分)的选择由算法在模型训练阶段自动判断,用于消除时间序列的趋势性与季节性非平稳性。模型参数识别借助auto_arima函数完成,通过逐步搜索给定阶数组合范围筛选最优模型,以赤池信息准则(Akaike information criterion,AIC)作为模型选择依据实现模型复杂度与拟合优度的均衡;随后开展该模型对测试集区间多步递推趋势预测,生成对应点预测值及95%置信区间,用于评估模型的预测性能。
同样,在Prophet模型构建中,本研究启用年度季节性分量,关闭周度与日度季节性成分,以凸显月度时间序列的长期演化趋势。同时,为提升模型对非线性季节模式的拟合效能,增设周期为12个月的自定义季节性项。依托Prophet的加性回归框架建模趋势、季节性与误差项,采用默认优化算法估计模型参数。
随后将模型预测结果与实际观测值进行比对,通过计算平均绝对误差(mean absolute error,MAE)、均方根误差(root mean square error,RMSE)量化模型预测精度,两类模型对3个档案需求类别的拟合及预测表现见表4。其中,JG2类别中SARIMA模型的MAE和RMSE下降幅度较为明显,表明其对机构日常档案管理类需求的短期变化具有较好的拟合效果。相比之下,Prophet模型在RS1中的MAE和RMSE均低于SARIMA模型,说明其对该类需求的预测表现更优。综合而言,后续预测分析以SARIMA模型为主,同时结合Prophet模型在RS1类别中的优势,对不同档案需求类别的预测结果进行综合判断。
表4 不同档案需求类别的模型评估情况

Table 4 Model evaluation of different archive demand categories

类别 指标
MAE RMSE
Prophet SARIMA Prophet SARIMA
JD3 0.749 0.668* 0.806 0.772*
JG2 0.684 0.52* 0.846 0.709*
RS1 0.24* 0.401 0.384* 0.413

3.4.2 档案需求类别预测结果

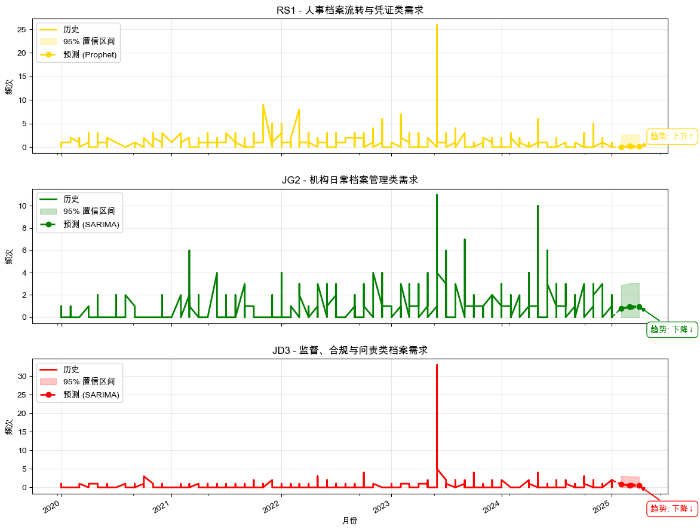
为了实现档案需求类别的准确预测,对JD3、JG2采用SARIMA,对RS1采用Prophet,实现2025年2月至2025年4月的3类档案需求频次预测(图7)。图7分别展示人事档案流转与凭证类需求(RS1)、机构日常档案管理类需求(JG2)以及监督、合规与问责类档案需求(JD3)的历史月度频次、预测结果及95%置信区间,以及3类档案需求的历史变化及短期预测结果。整体来看,3类需求在历史序列中均以低频波动为主,但不同时段存在程度不同的突增现象,说明档案需求具有一定的阶段性和事件驱动特征。
图7 不同档案需求类别的SARIMA模型预测结果

Figure 7 Prediction results of SARIMA model for different archive demand categories

其中,人事档案流转与凭证类需求(RS1)长期处于较低水平,但在部分月份出现明显峰值,表明毕业生档案查询、人才档案调转、档案补办和政审材料审核等需求通常受毕业季、就业流动和考录节点影响。预测结果显示,RS1短期内呈小幅上升趋势,说明该类需求仍将保持一定活跃度。机构日常档案管理类需求(JG2)整体波动相对平稳,但历史阶段中多次出现小幅峰值,反映机关单位、参公单位及组织部门在日常归档等方面存在持续性需求。监督、合规与问责类档案需求(JD3)的事件驱动特征最为明显,历史序列中虽多数月份频次较低,但个别月份出现显著峰值,表明违纪处分、举报材料、政审审查和合规问责等事项往往由特定事件触发。

4 总结与展望/Conclusion and outlook

4.1 总结与讨论

随着数字化与社交媒体的深度发展,公众档案需求已从传统“到馆查阅”逐渐转向线上检索与即时交互的新形态,档案服务供给与公众动态需求之间的适配问题日益凸显。本研究围绕“公众在社交媒体平台上表达了哪些核心档案需求”以及“如何对公众档案需求进行动态感知与趋势预测”两个问题,以知乎平台档案相关问答文本为研究对象,构建“公众档案需求识别—分类—预测”分析框架,并得出以下结论。
第一,从需求识别结果看,BERTopic模型能够有效揭示公众表达中具有现实指向性的档案需求主题。研究发现,公众档案需求并非局限于传统查档利用,而是广泛分布于人事档案调转、毕业生档案查询、公务员政审、机关单位档案管理等多元场景。这说明档案在组织运行与合规监督等实际事务中的深度嵌入,成为连接个人发展、机构管理与社会治理的重要信息凭证。
第二,从聚类结果看,经模型聚类与人工核验后,本研究将公众档案需求归纳为人事档案流转与凭证类需求、机构日常档案管理类需求以及监督、合规与问责类档案需求3类。3类需求分别对应个人事务办理、机构内部管理和治理监督问责3个层面,体现出公众档案需求由基础事务型需求向组织治理型、制度支撑型需求拓展的趋势。
第三,从需求预测结果看,SARIMA时序预测模型在3类档案需求的短期预测中整体表现出较好的稳定性。预测结果显示,人事档案流转类需求在未来短期内呈小幅上升趋势,说明基础性档案事务和机构管理型档案需求仍将持续存在;监督、合规与问责类档案需求则具有较强的事件驱动特征,在热点事件退潮后可能出现阶段性回落。
进一步地,面向“十五五”时期档案事业高质量发展[28],公众档案需求的动态识别与预测具有重要现实意义。当前,人事档案仍是公众线上求助中最集中、最基础的需求领域之一,但其服务模式仍存在查询路径不清、流转环节复杂、跨部门协同不足、智能化水平不高等问题。未来档案事业发展应更加重视人事档案智能化建设,通过推进档案数字化归集、跨平台信息共享、智能检索与自动提醒等方式,提高人事档案在形成、归档、转递、审核和利用全过程中的服务效率。同时,应将公众在社交媒体中表达的真实需求纳入档案服务优化与资源配置的参考体系,推动档案服务从被动响应转向主动感知、从经验判断转向数据驱动、从单一查阅服务转向全流程智能服务。
总体而言,本研究不仅揭示了社交媒体平台中公众档案需求的主题结构与类别特征,也验证了语义模型与时间序列模型结合用于档案需求动态感知的可行性。研究结果可为档案管理部门识别公众核心诉求、优化档案服务供给、推进人事档案智能化和提升档案治理能力提供参考,也为“十五五”时期档案事业数字化转型和精准化服务提供方法支持。

4.2 不足与展望

本研究在公众档案需求的识别、分类与预测层面取得了一定进展,但围绕“公众档案需求”这一研究对象,仍存在一些局限与值得拓展的方向。
其一,数据来源单一,公众覆盖面有限。本研究仅采用知乎一个平台的数据,而公众的档案诉求实际上分散于微博、短视频平台、12345政务留言、各地档案馆办事记录等多种渠道。单一平台数据可能在用户结构(年龄、地域、职业)与表达风格上形成系统性偏倚,遗漏未上网或在其他平台表达的诉求(如农村地区档案诉求)。未来研究需扩展到多平台、多群体的公众档案需求图景,并尝试与档案馆办事记录交叉验证。
其二,本研究主要刻画了公众的显性档案表达,尚未区分不同公众群体(如农村居民、老年人群、不上网群体)在档案诉求上的差异,也未细分公众在档案形成、整理、保管、利用不同环节上的需求强度差异。未来可结合用户画像与环节分层,构建覆盖“沉默群体”的公众档案需求精细感知机制。
其三,对冷门档案需求的预测能力有限。本研究采用的时序模型适合刻画常态化、周期性的公众档案需求波动,但对政策突变、舆情触发等偶发性公众诉求的预测能力较弱,对样本量稀疏的冷门档案诉求亦难以稳健建模。未来可引入外生变量驱动的时序模型与大语言模型辅助的事件早期检测,以增强对公众档案诉求的感知能力。
[1]
黄体杨, 张斌. 档案素养: 增强全社会档案意识的理论内核[J]. 山西档案, 2024(11): 7-14.

Huang Tiyang, Zhang Bin. Archival literacy: theoretical core of enhancing the archival awareness of the whole society[J]. Shanxi archives, 2024(11): 7-14.

[2]
Aubry S. Introducing Web archives as a new library service: the experience of the national library of France[J]. LIBER quarterly, 2010, 20(2): 179-199.

[3]
Vilar P, Šauperl A. Archives, quovadis et cum quibus? archivists' self-perceptions and perceptions of users of contemporary archives[J]. International journal of information management, 2015, 35(5): 551-560.

[4]
Borgman C L, Scharnhorst A, Golshan M S. Digital data archives as knowledge infrastructures: mediating data sharing and reuse[J]. Journal of the Association for Information Science and Technology, 2019, 70(8): 888-904.

[5]
Freeman E. In the eye of the beholder: archives administration from the user's point of view[J]. The American archivist, 1984, 47(2): 111-123.

[6]
Tansey E. Archives without archivists[J]. Reconstruction: studies in contemporary culture, 2016, 16(1): 1-20.

[7]
常愉.基于用户需求的高校档案服务创新[J].山西档案, 2024(12): 54-57.

Chang Yu. Innovation of university archives services means based on user demands[J]. Shanxi archives, 2024(12): 54-57.

[8]
徐拥军, 唐懿飞, 陈晓婷. 我国档案产业市场需求调查研究[J]. 浙江档案, 2025(2): 14-19.

Xu Yongjun, Tang Yifei, Chen Xiaoting. Research on market demand of archives industry in China[J]. Zhejiang archives, 2025(2): 14-19.

[9]
叶然·吐尔逊江, 王兴广. 基于5GAP模型的档案馆服务质量提升策略研究[J]. 北京档案, 2024(12): 26-30.

Tuerxunjiang Yeran, Wang Xingguang. Research on strategies for improving archive service quality based on the 5GAP model[J]. Beijing archives, 2024(12): 26-30.

[10]
靳文君, 黄霄羽. 数字时代赋能型档案服务的概念内涵、理论图景与价值阐释[J]. 北京档案, 2025(2): 11-18.

Jing Wenjun, Huang Xiaoyu. Concept connotation, theoretical picture and value interpretation of empowering archive service in the digital era[J]. Beijing archives, 2025(2): 11-18.

[11]
崔旭, 胡辰曦, 景家圆. 基于DEA-Tobit的综合档案馆服务效率、影响因素及提升策略[J]. 山西档案, 2025(2): 29-38.

Cui Xu, Hu Chenxi, Jing Jiayuan. Service efficiency, influencing factors and enhancement strategies of integrated archives based on DEA-Tobit archive[J]. Shanxi archives, 2025(2): 29-38.

[12]
Blei D M, Ng A Y, Jordan M I. Latent Dirichlet allocation[J]. Journal of machine learning research, 2003, 3: 993-1022.

[13]
Grootendorst M. BERTopic: neural topic modeling with a class-based TF-IDF procedure[PP/OL]. arXiv[2026-05-25].

[14]
程越欣, 杨峰, 郭剑明. 基于BERTopic模型的国内政府数据开放研究主题挖掘及内容分析[J].图书馆学研究, 2025(5): 26-37, 65.

Cheng Yuexin, Yang Feng, Guo Jianming. Topic mining and content analysis of research on government data openness in China based on BERTopic[J]. Research on library science, 2025(5): 26-37, 65.

[15]
金燕, 陈登建, 曹玲静. 中国数据要素政策主题的嬗变逻辑及扩散动向分析[J].现代情报, 2026, 46(4): 123-135.

Jin Yan, Chen Dengjian, Cao Lingjing. Analysis of the evolutionary logic and diffusion trends of China's data element policy themes[J]. Journal of modern information, 2026, 46(4): 123-135.

[16]
纪潇玲, 张明平, 刘桂锋, 等. 基于STM的我国图书馆学与情报学研究主题演化与差异分析[J].图书馆学研究, 2025(5): 2-15, 52.

Ji Xiaoling, Zhang Mingping, Liu Guifeng, et al. Comparative analysis of the evolution of research topics in library science and information science in China based on STM[J]. Research on library science, 2025(5): 2-15, 52.

[17]
曹雅宁, 柯青, 李悦, 等. 用户参与虚假信息社会纠正的行为模式[J].图书馆论坛, 2025, 45(11): 111-122.

Cao Yaning, Ke Qing, Li Yue, et al. Behavioral patterns of user participation in social correction of misinformation[J]. Library tribune, 2025, 45(11): 111-122.

[18]
Wang Chong, Blei D M, Heckerman D. Continuous time dynamic topic models[C]//Proceedings of the 24th conference on uncertainty in artificial intelligence. Helsinki: AUAI Press, 2008: 579‑586.

[19]
Dobariya D A, Raval R. Dynamic topic modeling in real-time social media streams using neural temporal contexts[PP/OL]. arXiv[2026-02-24].

[20]
陈煜杰, 王一蒙, 任飞亮. 应用SARIMA模型预测主题词研究热度[J].小型微型计算机系统, 2022, 43(10): 2022-2027.

Chen Yijie, Wang Yimeng, Ren Feiliang. Based on SARIMA model to predict the research popularity of subject words[J]. Journal of Chinese mini-micro computer systems, 2022, 43(10): 2022-2027.

[21]
Ferreira G O, Ravazzi C, Dabbene F, et al. Forecasting network traffic: a survey and tutorial with open-source comparative evaluation[J]. IEEE access, 2023, 11: 7498-7533.

[22]
张鑫, 文奕, 许海云, 等. Prophet预测—修正的主题强度演化模型——以干细胞领域为实证[J]. 图书情报工作, 2020, 64(8): 78-92.

Zhang Xin, Wen Yi, Xu Haiyun, et al. Prophet prediction-correction topic evolution model——a case study in stem cell field[J]. Library and information service, 2020, 64(8): 78-92.

[23]
Daraghmeh M, Agarwal A, Manzano R, et al.Time series forecasting using Facebook prophet for cloud resource management[C]//2021 IEEE international conference on communications workshops. Montreal: IEEE, 2021: 1-6.

[24]
Hua Yuxiu, Zhao Zhifeng, Li Rongpeng, et al. Deep learning with long short-term memory for time series prediction[J]. IEEE communications magazine, 2019, 57(6): 114-119.

[25]
Mehta M Y, Lad K, Buch S. Technology trend prediction from social media using long short term memory network[J]. International journal of engineering research, 2020, 9(4): 836-840.

[26]
Miao Yishu, Grefenstette E, Blunsom P. Discovering discrete latent topics with neural variational inference[C]//International conference on machine learning. PMLR, 2017: 2410-2419.

[27]
全国科学技术名词审定委员会. 档案学名词[M]. 北京: 科学出版社, 2024.

China National Committee for Terms in Sciences and Technologies. Terms of archival science[M]. Beijing: Science Press, 2024.

[28]
新华社. “十五五”时期全国档案事业将着力保障和改善民生[EB/OL]. [2026-01-15].

Xinhua News Agency. National archives undertakings in the 15th Five-Year Plan Period will focus on ensuring and improving people's livelihood[EB/OL]. [2026-01-15].

文章导航

/

〈 〉