研究论文

《通用人工智能行为准则》解读及其对人工智能大模型归档的启示

  • 王孟涵 1, 2 ,
  • 吴志杰 1, 3 ,
  • 张静 , 1, 2, 3
展开
  • 1. 中国科学院文献情报中心 北京 100190
  • 2. 中国科学院大学经济与管理学院信息资源管理系 北京 100190
  • 3. 中国科学院档案馆 北京 100190
张静,中国科学院档案馆副馆长,研究馆员,博士,硕士生导师,E-mail:。

作者贡献声明/Author contributions:

王孟涵:论文撰写及修改;

吴志杰:论文指导及修改;

张 静:论文指导及修改。

王孟涵,硕士研究生;

吴志杰,副研究馆员,博士。

收稿日期: 2026-04-12

  网络出版日期: 2026-08-25

The General-Purpose AI Code of Practice:Interpretation and Archival Implications for AI Models

  • Wang Menghan 1, 2 ,
  • Wu Zhijie 1, 3 ,
  • Zhang Jing , 1, 2, 3
Expand
  • 1. National Science Library, Chinese Academy of Sciences, Beijing 100190
  • 2. Department of Information Resources Management, School of Economics and Management, University of Chinese Academy of Sciences, Beijing 100190
  • 3. Archives of Chinese Academy of Sciences, Beijing 100190
Zhang Jing, Deputy Director, Archives of Chinese Academy of Sciences, Research Librarian, Master’s Supervisor, PhD, E-mail: .

Wang Menghan, Master Candidate;

Wu Zhijie, Associate Research Librarian, PhD.

Received date: 2026-04-12

  Online published: 2026-08-25

摘要

[目的/意义] 人工智能大模型的开发与应用具有分级监管风险、全生命周期动态治理等特殊要求,使得其归档有着不同于一般信息管理系统或平台归档的特殊性。对AI大模型归档研究,有助于适应当前人工智能发展形势,丰富档案管理工作。[方法/过程] 以《通用人工智能行为准则》为研究对象,分别运用BERTopic模型进行主题识别以梳理《准则》中关于AI大模型开发与应用的要求与主要风险,运用DeepSeek V4模型进行内容抽取以归纳面向风险治理的举措及其形成的文件材料。在此基础上,从强调分级监管AI大模型风险、实施全生命周期动态治理及注重完善治理架构3个方面系统分析与解读《准则》,并探讨档案部门作为后端管理主体应如何主动应对上述要求与风险。[结果/结论] 基于上述分析,本文提出档案部门可从实施与风险治理相适应的分级归档、明确AI大模型全生命周期的归档要求以及完善面向风险治理的文件材料归档范围3个方面着手,为我国开展人工智能大模型归档工作提供参考。
本文引用格式

王孟涵 , 吴志杰 , 张静 . 《通用人工智能行为准则》解读及其对人工智能大模型归档的启示[J]. 知识管理论坛, 2026 , 11(4) : 345 -351 . DOI: 10.13266/j.issn.2095-5472.2026.029

Abstract

[Purpose/Significance] The development and application of AI models are subject to specific regulatory requirements covering tiered risk regulation and dynamic full-lifecycle governance, resulting in archiving characteristics distinct from those of conventional information management systems or platforms. Research on the archiving of AI models can keep pace with the evolving landscape of artificial intelligence and enrich both the theory and practice of archival management. [Method/Process] This paper took the General-Purpose AI Code of Practice as the research object. It applied the BERTopic model for topic identification to outline the requirements and major risks concerning the development and application of AI models in the Code of Practice, and employed the DeepSeek V4 model for content extraction to summarize the documents and materials formed for risk governance. Based on this, the paper systematically analyzed and interpreted the Code of Practice from three dimensions: emphasizing tiered risk regulation for AI models, implementing dynamic full-lifecycle governance, and discussed how archival institutions, as back-end management subjects, should actively respond to the above requirements and risks. [Result/Conclusion] Based on the above analysis, this paper proposes that archival institutions can advance the archiving of AI models from three dimensions: implementing tiered archiving matching risk governance, clarifying full-lifecycle archiving specifications, and optimizing the scope of records collection oriented toward risk management, to provide references for the domestic practice of AI models archiving in China.

人工智能大模型(以下简称“AI大模型”)归档是指对AI大模型开发与应用各阶段形成的具有保存价值的文件材料进行系统整理并交由档案部门保存的过程。AI大模型开发与应用过程具有不同于一般信息管理系统或平台的要求与风险。这些要求和风险决定了监管、开发和使用部门在此过程中必须采取相关的应对举措,从而影响了全过程记录及归档要求。档案部门作为社会活动原始记录管理者,必须主动关注并响应AI大模型开发与应用的要求,适应性调整归档举措,确保归档文件材料来源可靠、要素合规、程序规范,为AI大模型的合规监管、风险溯源、责任审计、技术复现和高效应用等提供支撑保障。
我国档案领域对AI大模型归档的相关研究尚处于起步阶段,主要涉及3个方面。其一,AI大模型文档的构成与范围。贺谭涛[1]、连志英等[2]构建涵盖开发、运行与应用全生命周期的人工智能文档体系。其二,AI大模型相关特殊数据、文件材料的管理。张茜雅等[3]引入并行数据,强调系统性记录和管理AI运行的过程性数据;王阿陶[4]、连志英等[5]从档案学视角理解算法来源,探讨其构成要素。其三,AIGC归档。裴佳杰等[6]、王玉珏等[7]以人工智能生成内容为研究对象,探讨其归档管理问题。由此可见,现有研究主要讨论了AI大模型归档的概念范畴与风险挑战,并未从前端管理要求变化所带来的系列影响角度深入讨论AI大模型“如何归”“归什么”等问题。作为人工智能治理的先行者,欧盟通过颁布一系列政策文件与立法实践,逐步构建起人工智能治理框架,加强了对AI大模型的治理与风险监管。因此,本文借鉴欧盟《通用人工智能行为准则》(以下简称《准则》),从这一研究视角出发开展相关研究,以弥补现有研究不足,丰富档案管理研究。

1 研究对象与研究方法/Research object and research methods

1.1 《准则》制定背景与目的

为加强对AI大模型的监管,2024年8月1日,欧盟《人工智能法案》(以下简称《法案》)正式生效。2025年7月10日,欧盟发布《准则》的最终版本。《准则》由欧盟人工智能办公室(AI Office)联合13位独立专家共同起草,适用于OpenAI的ChatGPT、谷歌的Gemini以及xAI的Grok等AI大模型。《准则》作为《法案》第56条下的一套指导性文件,围绕透明度、版权保护及安全与风险治理三大维度提出合规要求,旨在对AI大模型开发与应用过程提出具体要求,为模型提供者提供更具操作性的合规路径。
《准则》从透明度、版权保护及安全与风险治理三大维度提出了合规要求,这些合规要求进一步指导模型提供者采取举措。从档案管理角度看,举措发生变化时,其原始记录的形成时间、形成内容也会发生变化,进而对归档工作产生影响。基于此,本文通过对《准则》的文本分析,旨在梳理AI大模型开发与应用过程中的要求与主要风险,以及风险治理过程中形成的文件材料,并在此基础上系统分析与解读《准则》,探讨原始记录的形成变化,进而为档案部门调整AI大模型归档提供指导与启示。

1.2 《准则》主题识别方法

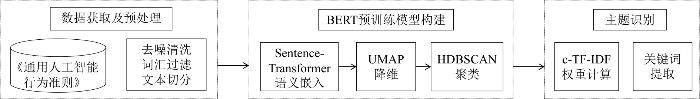
BERTopic模型是基于BERT(bidirectional encoder representations from transformers)模型的无监督深度学习主题聚类方法,该方法保证了主题的一致性和多样性,能够清晰地反映主题的核心内容[8]。鉴于此,本文选用BERTopic模型对《准则》进行主题识别,旨在为梳理AI大模型开发与应用的要求与主要风险奠定基础,从而指导完善归档要求。基于BERTopic模型的主题识别技术实现路径如图1所示,具体过程为:首先,以《准则》为数据来源,对原始语料进行去噪清洗,系统去除条款编号、特殊符号等非语义元素,并采用NLTK停用词表,同时补充政策文本中常见的噪声词进行词汇过滤;其次,使用预训练的句子嵌入模型all-MiniLM-L6-v2将文本段落转换为384维的语义向量;再次,采用统一流形近似与投影(uniform manifold approximation and projection,UMAP)算法对上述语义向量进行非线性降维;随后,采用层次密度方法(hierarchical density-based spatial clustering of applications with noise,HDBSCAN)进行聚类;最后,在聚类的基础上,采用c-TF-IDF进行主题词权重计算,提取具有主题区分度的代表性词汇。
图1 主题识别技术路径

Figure 1 Technical pathways for topic identification

1.3 《准则》内容抽取方法

模型提供者在进行风险治理过程中按要求应采取的举措及其所形成的文件材料,是档案部门调整归档要求、完善归档范围的重要参考依据。科学界定一项工作所形成文件材料的归档范围是档案工作的重要内容[9],对于确保档案的完整性具有重要作用。为此,本文利用AI大模型对《准则》进行内容抽取,旨在厘清风险治理过程中的具体举措及产生的文件材料,为档案部门完善归档范围提供参考。
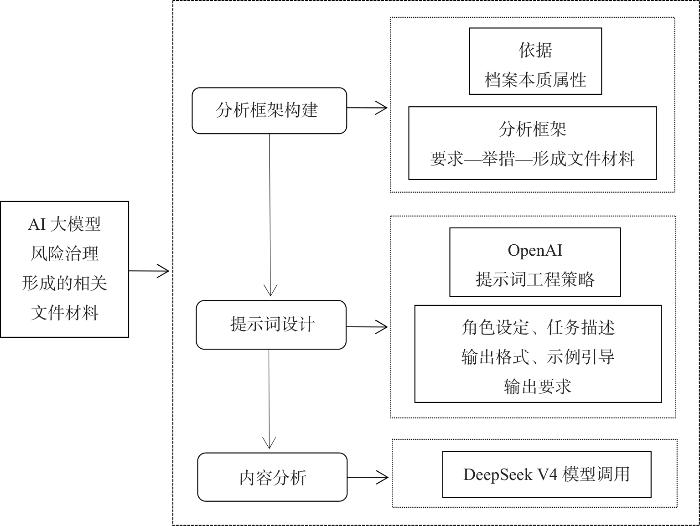
DeepSeek V4模型拥有百万字超长上下文,在Agent能力、世界知识和推理性能上均实现国内与开源领域的领先[10]。鉴于此,本文选用DeepSeek V4模型作为分析工具,分析步骤见图2。首先,以档案本质属性即人类社会活动的原始记录[11]为基础构建分析框架。在这一属性下,档案是社会活动的必然产物。模型提供者在风险治理过程中按要求所采取的举措属于社会活动,在这个过程中形成的文件材料是这一活动的必然记录。基于此,本文构建了“要求—举措—形成文件材料”的三维分析框架。其中,“要求”维度以《准则》提出的透明度、版权保护及安全与风险治理3个层面为划分依据。其次,参考OpenAI官方手册所阐释的提示词工程策略,设计提示词并经过多轮测试,确定本文提示词指令。最后,调用DeepSeek V4模型进行内容抽取,建立“要求—举措—形成文件材料”之间的对应关系。
图2 基于DeepSeek V4模型的内容抽取步骤

Figure 2 Content extraction procedure diagram based on the DeepSeek V4 model

2 《准则》主题识别与内容抽取结果/Results of topic identification and content extraction from the Code of Practice

2.1 基于BERTopic模型的主题识别

在多次调整参数并剔除离散文档主题后,本文基于BERTopic模型共识别出9个热点主题,并输出每个主题中排名前5位的特征词,具体结果见表1。
表1 BERTopic模型识别的主题

Table 1 Topics recognized by BERTopic model

序号 主题号 关键词
1 Topic0 copyright related、related rights、law copyright、union law、subject matter
2 Topic1 applicable national、office applicable、involvement model、signatories aware、relevant information
3 Topic2 model parameters、reduction risk、security mitigations、mitigation objectives、insider threats
4 Topic3 ai act、model documentation、obligations ai、downstream providers、providers ai
5 Topic4 model report、model intended、updated model、provide ai、signatories provide
6 Topic5 management body、body supervisory、working group、managing systemic、mitigation processes
7 Topic6 signatories recognise、model evaluation、model evaluations、external evaluators、model version
8 Topic7 risk identification、risks measure、types risks、understanding systemic、identification process
9 Topic8 risk acceptance、specified measure、risk tiers、specified commitment、measure signatories
基于BERTopic模型的主题识别结果,并结合人工鉴定与判读,本文认为《准则》主要从以下9个方面对AI大模型开发与应用提出要求:知识产权与法律合规(Topic0)、签署方义务与合规程序(Topic1)、模型技术安全(Topic2)、AI监管与提供商责任(Topic3)、模型报告与持续更新(Topic4)、系统性风险管理(Topic5)、模型评估与外部审计(Topic6)、风险识别(Topic7)和风险分级与接受标准(Topic8)。

2.2 基于DeepSeek V4模型的内容抽取

为确保DeepSeek V4模型在内容抽取上的准确性,本文在模型生成回答的基础上,追溯原文进行人工校验、修正、补充与整合,归纳出风险治理过程中模型提供者需要采取的举措(如提供并更新模型文档表、实施版权政策、持续跟踪和报告严重事件等),以及形成的文件材料(如模型文档表、版权政策文档、模型安全报告、系统性风险清单等),具体内容见表2。
表2 《准则》内容抽取

Table 2 Content extraction from the Code of Practice

序号 要求 举措 形成文件材料
1 透明度 提供并定期更新模型文档表 模型文档表、模型文档表更新日志
2 公开联系方式 模型提供者联系信息
3 确保文档信息进行质量与完整性控制 信息质量与完整性控制记录
4 版权合规 实施并持续更新版权政策 版本政策文档
5 识别和排除大规模侵权网站 网站超链接列表
6 网络爬虫需要遵守权利保留声明 机器可读权利保留协议清单
7 公开爬虫信息和遵守权利声明的技术规则,并通知权利人相关变化 网络爬虫信息及权利人通知记录
8 实施技术保护,防止模型侵权性复制训练内容 侵权防护技术保障举措文档
9 指定版权持有人电子联系点并公开信息 版权联系点信息
10 建立版权投诉机制,公开渠道,及时处理 版权投诉机制文档及处理记录
11 安全与风险治理 创建、实施并更新安全与风险治理框架 安全与风险治理框架、框架更新日志
12 在模型投放市场前,编制安全报告并提交至AI办公室 模型安全报告
13 模型上市前进行外部安全审查、红队测试 安全审查报告、红队测试记录
14 实施沙箱隔离、代码执行隔离、训练数据完整性检查 沙箱配置文档、隔离策略、数据完整性验证记录
15 模型上市后持续监测收集风险评估信息 上市后监测数据
16 对已识别的系统性风险进行风险识别、建模和估算 系统性风险清单、风险建模结果、风险估算结果、风险情景清单
17 判定系统性风险是否可接受 风险接受度判定文档及决策记录
18 过滤和清理训练数据、监控输入/输出等风险缓解举措 风险缓解举措实施记录文档
19 持续跟踪和报告严重事件 严重事件跟踪、记录和报告相关信息
20 明确组织各层级的系统性风险管理职责 系统性风险责任分配文档
21 允许挑战风险、设置激励举措、举报人保护 员工调查、举报人保护政策
22 配备充足人力、财力等资源 资源分配记录

3 《准则》内容解读/Interpretation of the Code of Practice

为更精准、细致地解读《准则》,本文基于BERTopic模型识别出的9个主题,经阅读、分析与聚类,将其归纳为强调分级监管AI大模型风险(Topic5、Topic7、Topic8)、实施全生命周期动态治理(Topic2、Topic4、Topic6)以及注重完善治理架构(Topic0、Topic1、Topic3)3个维度,并同时结合DeepSeek V4模型内容抽取所得的风险治理举措及形成文件材料,对《准则》进行深度解读。

3.1 强调分级监管AI大模型风险

不同AI大模型的能力及其潜在影响存在巨大差异。为了更好地规范AI大模型发展并延续《法案》中AI系统风险分级管理的思路,《准则》依据风险等级将AI大模型划分为“普通AI大模型”和“具有系统性风险的AI大模型”,并据此对AI大模型提出了不同的风险监管要求。
对于普通AI大模型,《准则》要求其提供者履行透明度和版权保护相关要求,具体包括提供并定期更新模型文档表,确保文档信息进行质量与完整性控制,实施并持续更新版权政策等。
对于具有系统性风险的AI大模型,除履行上述普通义务外,还需要满足以下额外要求:一是以模型能力为核心指标,并将模型倾向、风险估计或其他适当的指标等纳入模型风险等级的定义,判定系统性风险是否可接受;二是实施包括过滤和清理训练数据、监控输入/输出等适当的风险缓解举措;三是持续评估并缓解系统性风险,迭代更新管理策略以应对模型能力的持续演进,确保其系统性风险管理可与AI大模型风险等级的动态变化同步。

3.2 实施全生命周期动态治理

考虑到AI大模型风险的持续性与动态性,《准则》强调构建AI大模型开发、上市、应用以及重大变更等全生命周期的动态治理体系。在模型开发阶段,《准则》要求模型提供者记录并持续更新AI大模型的相关信息,同时提交模型文档表。为确保记录信息的完整性和透明性,《准则》细化了模型文档表的要求,涵盖通用信息、模型属性、分发方式和许可证、训练过程、用于训练、测试和验证的数据信息、计算资源(训练期间)及能耗(训练和推理期间)八大维度。在模型上市前,《准则》要求提供者落实版权合规政策,评估AI大模型风险发生的可能性和严重程度,制定风险预防举措,经审核通过后方可投放市场。在模型上市后,《准则》要求模型提供者建立监测机制,持续跟踪并报告严重事件。

3.3 注重完善治理架构

为确保AI大模型提供者履行合规要求,欧盟从顶层设计入手,通过发布指导性文件确立行为标准,并依托组织架构保障《准则》得以落实。《准则》中明确了3层治理架构:第一层为董事会、委员会等独立机构,用来履行监督职能;第二层为执行机构,负责具体落实;第三层为相关运营团队。
同时,《准则》设定了风险监督者、风险责任者、风险支持和监测者以及风险保证者四类角色,形成权责分明的责任体系。此外,为保障各责任主体有效履行职责,《准则》要求为其配备充足的人力资源、财力资源、信息和计算资源,并允许挑战风险、设置激励举措、实施举报人保护政策等。

4 《准则》对AI大模型归档的启示/Enlightenments of the Code of Practice on the archiving of AI models

4.1 实施与风险治理相适应的分级归档

《准则》要求对AI大模型实施分级监管,即依据模型风险等级设定差异化合规要求,且风险等级越高,其保障举措越严格。档案部门作为AI大模型后端管理的重要主体,需要关注并响应前端治理要求逻辑的转变,改变“一刀切”的归档思路,针对不同风险等级的AI大模型制定差异化的归档策略。
具体而言,应在归档范围、保管期限和“四性检测”方案等方面实现与风险等级的适配,模型风险等级越高,归档要求越严格,以期适应前端的管理要求。对于具有系统性风险的AI大模型,一是应细化归档范围,重点将AI大模型全生命周期风险管理涉及的文件材料纳入归档范围,如模型开发记录、模型报告、模型风险清单、严重事件报告等,实现“应收尽收,应归尽归”;二是应从长界定保管期限,以期应对AI大模型风险追溯与审查需求;三是应在归档环节的“四性检测”中强化安全性审查,关注AI大模型是否已开展投毒攻击检测与防御、对齐算法风险检测、成员推理检测、模型水印检测以及指令注入与提示攻击检测等[12],以确保归档文件材料的安全可信。对于普通风险的AI大模型,其归档范围可适当缩小,并重点将具有保存价值的AI大模型文档,如模型开发记录、模型报告等基础材料进行归档,保管期限也可酌情设定。
考虑到AI大模型在全生命周期中的风险等级具有动态变化性,归档工作也需要与之相适应。具体而言,档案部门需要建立风险跟踪与动态调整机制,实施AI大模型风险备案,对纳入归档范围的AI大模型,按年度或者定期主动跟踪模型风险等级的变化,并据此及时调整归档范围、保管期限等要求,确保文件材料归档与前端风险治理的动态衔接。

4.2 明确AI大模型全生命周期归档要求

传统信息管理系统或平台更强调系统建设、开发相关文件材料收集归档,较少关注系统上线后的归档。AI大模型强调实施全生命周期动态治理,尤其是上市后的监管。因此,对于AI大模型归档而言,不应仅仅局限于传统的“事后归档”模式,也不能沿用传统的一成不变的静态管理方式,而是需要树立AI大模型全生命周期归档理念,从后端保管者转为前端参与者,主动动态跟踪各阶段管理要求的变化,提前介入业务流程,明确AI大模型的阶段性归档要求。
具体而言,在模型开发与上市阶段,AI大模型归档要点与普通的信息管理系统或平台类似,但需要根据AI大模型开发的特点,重点归档关于通用信息、模型属性、分发方式和许可证、训练过程、用于训练、测试和验证的数据信息、计算资源(训练期间)和能耗(训练和推理期间)八大维度的具体信息要素。同时,由于AI大模型迭代频繁,为了更好地确保AI大模型版本可追溯,可以考虑按版本进行阶段性归档,当模型信息发生重大变更时,应及时归档相应版本。
在模型上市后,档案部门应建立AI大模型运行跟踪机制,持续做好相关文件材料归档工作。一是落实常规性文件材料的年度归档,如按照年度做好运行报告、审计报告、用户报告、训练数据等归档;二是对于上市后重大事件,如重大风险事件、重要奖励奖项等,可以建立同步归档机制,确保相关文件材料及时收集归档;三是根据监管要求或实际应用情况,不断优化完善归档范围,确保归档文件材料始终能够支撑审计、监管、系统更新迭代等多方面的需求。

4.3 完善面向风险治理的文件材料归档范围

《准则》为不同风险等级的AI大模型提出了不同的合规要求,普通风险的AI大模型需要履行透明度和版权保护要求,具有系统性风险的AI大模型需要额外履行关于风险识别、风险分析、风险可接受性判定等风险治理的要求。在履行上述要求的过程中,其形成的文件材料对于支撑AI大模型的透明性、可解释性及风险追溯具有重要作用。鉴于AI大模型实行分级监管,不同风险等级模型在履行合规义务过程中产生的文件材料存在差异,档案部门应据此完善面向风险治理的文件材料归档范围,确保后端能够验证各风险等级模型的合规状态及风险水平。
本文在基于DeepSeek V4模型的内容抽取的基础上,依据《准则》的风险等级划分,按风险等级梳理出各等级AI大模型文件材料的归档重点,以期为档案部门完善归档范围提供参考,具体内容见表3。
表3 面向风险治理的AI大模型文件材料归档内容

Table 3 Archiving scope of AI models documents and materials for risk

序号 风险等级 相关文件材料内容
1 普通风险 模型文档表、模型文档表更新日志、模型提供者联系信息、信息质量与完整性控制记录、版本政策文档、网站超链接列表、机器可读权利保留协议清单、网络爬虫信息及权利人通知记录、侵权防护技术保障举措文档、版权联系点信息、版权投诉机制文档及处理记录等
2 系统性风险 安全与风险治理框架、框架更新日志、模型安全报告、安全审查报告、红队测试记录、沙箱配置文档、隔离策略、数据完整性验证记录、上市后监测数据、系统性风险清单、风险建模结果、风险估算结果、风险情景清单、风险接受度判定文档及决策记录、风险缓解举措实施记录文档、严重事件跟踪、记录和报告相关信息、系统性风险责任分配文档、员工调查、举报人保护政策、资源分配记录等
由表3易知,档案部门需要针对不同风险等级的AI大模型完善相应的文件材料内容。对于普通风险的AI大模型,档案部门需要重点关注模型文档表、版权政策文档、网站超链接列表等关于透明度和版权保护的文件材料;对于具有系统性风险的AI大模型,则需要重点围绕模型安全报告、安全审查报告、系统性风险清单、上市后监测数据等关于安全与风险治理的文件材料,完善归档范围。

5 结语/Conclusion

AI大模型开发与应用过程中需求的持续变化,正对后端归档工作产生深远影响。当前学界已围绕AI大模型文档的构成与范围、AI大模型相关特殊数据及文件材料管理、AIGC归档等议题展开初步探讨。在此基础上,本文通过对《准则》内容的解读,提出实施与风险治理相适应的分级归档、明确AI大模型全生命周期归档要求以及完善面向风险治理的文件材料归档范围3个方面的启示,在一定程度上回答了前端管理要求变化下AI大模型“如何归”“归什么”等问题。需要指出的是,本文尚存在一定局限性,研究主要围绕政策文本展开分析,尚未结合实践场景进行验证,也未充分考量不同领域AI大模型在开发与应用过程中存在的差异。未来,研究可细化不同领域AI大模型开发与应用过程中的要求,结合实地调研开展实证分析,进一步完善AI大模型归档方法,提升其适用性和有效性。
[1]
贺谭涛.档案学视角下的人工智能文档: 范畴界定、管理挑战与探索方向[J]. 档案学通讯, 2026(4): 39-47.

He Tantao. Artificial intelligence documentation from the perspective of archival[J]. Archives science bulletin, 2026(4): 39-47.

[2]
连志英, 蒋玲.面向人工智能治理的人工智能文档的作用及其构成研究[J]. 图书情报工作, 2026, 70(9): 148-156.

Lian Zhiying, Jiang Ling. Research on the role and composition of AI documentation for AI governance[J]. Library and information service, 2026, 70(9): 148-156.

[3]
张茜雅, 刘越男.并行数据: 人工智能应用背景下档案管理的新议题[J]. 浙江档案, 2025(7): 14-19.

Zhang Qianya, Liu Yuenan. Paradata: a new issue in archival management in the context of artificial intelligence applications[J]. Zhejiang archives, 2025(7): 14-19.

[4]
王阿陶.“算法档案”的概念内涵、治理理念与实现机制[J]. 档案学研究, 2026(2): 30-39.

Wang Atao. Concept, governance philosophy and practical mechanism of “algorithmic archive”[J]. Archives science study, 2026(2): 30-39.

[5]
连志英, 苏立.档案学视角下算法来源的内涵及其要素构成[J]. 档案学通讯, 2025(3): 29-37.

Lian Zhiying, Su Li. Archival science perspectives on algorithm provenance: concepts and components[J]. Archives science bulletin, 2025(3): 29-37.

[6]
裴佳杰, 张斌.AIGC归档的逻辑理路与冲突解构[J]. 情报科学, 2025, 43(8): 100-108.

Pei Jiajie, Zhang Bin. The theoretical logic and conflict deconstruction of AIGC archiving[J]. Information science, 2025, 43(8): 100-108.

[7]
王玉珏, 樊静雅, 温翰英.人工智能生成合成内容的可信存档策略研究——基于对电子档案“四性”的思考[J]. 北京档案, 2025(4): 22-29.

Wang Yujue, Fan Jingya, Wen Hanying. Research on trusted archiving strategies for artificial intelligence generated content: based on reflections on the four characteristics testing of electronic archives[J]. Beijing archives, 2025(4): 22-29.

[8]
Grootendorst M. BERTopic: neural topic modeling with a class-based TF-IDF procedure[PP/OL]. arXiv(2023-03-11)[2026-07-24].

[9]
蔡盈芳.科学界定科研文件材料的归档范围并准确划分科研档案保管期限[J]. 中国档案, 2021(5): 44-45.

Cai Yingfang. To scientifically define the archival scope of research documentation and accurately establish the retention periods for research archives[J]. China archives, 2021(5): 44-45.

[10]
深度求索.DeepSeek-V4预览版: 迈入百万上下文普惠时代[EB/OL]. [2026-05-30].

DeepSeek. DeepSeek-V4 preview: entering the era of accessible million-token context[EB/OL]. [2026-05-30].

[11]
徐拥军, 闫静.中国特色档案学的基本范畴与核心命题[J]. 中国图书馆学报, 2024, 50(3): 30-46.

Xu Yongjun, Yan Jing. The basic categories and core propositions of archival science with Chinese characteristics[J]. Journal of library science in China, 2024, 50(3): 30-46.

[12]
田泽懿, 张靖琦.基于生命周期的大模型安全审视: 风险梳理与防范机制[J]. 工业信息安全, 2025(4): 20-28.

Tian Zeyi, Zhang Jingqi. Security review of large language models based on the lifecycle: risk identification and prevention mechanisms[J]. Industry information security, 2025(4): 20-28.

文章导航

/

〈 〉