研究论文

基于BERTopic主题模型的数据要素价值化热点主题及演化分析

  • 陈婉铭 ,
  • 刘媛华
展开
  • 上海理工大学管理学院 上海 200093
刘媛华,副教授,博士,硕士生导师,E-mail: 。

陈婉铭,硕士研究生。

收稿日期: 2025-07-17

  网络出版日期: 2025-12-15

Hot Topics and Evolution Analysis of Data Element Valorization Based on the BERTopic Model

  • Chen Wanming ,
  • Liu Yuanhua
Expand
  • Business School, University of Shanghai for Science and Technology, Shanghai 200093
Liu Yuanhua, Associate Professor, PhD, Master's Supervisor, E-mail: .

Chen Wanming, Master's Candidate.

Received date: 2025-07-17

  Online published: 2025-12-15

摘要

【目的/意义】运用BERTopic主题模型分析我国数据要素价值化领域的核心主题、演化路径与前沿动态,为深化理论探索和指导实践应用提供宏观视角与客观依据。【方法/过程】以中国知网(CNKI)2019年至今收录的1 735篇文献为样本,采用BERTopic主题建模方法展开研究。首先通过预训练语言模型构建语义嵌入空间,并结合UMAP降维与HDBSCAN密度聚类算法,初步生成语义相近的主题簇。在此基础上,采用c-TF-IDF进行关键词加权,继而引入时序分析方法,追踪研究主题的动态演变规律。【结果/结论】研究发现:①当前研究主题聚焦于“企业创新与数据要素市场培育”“数据基础制度与产业数字化转型”“要素市场化配置与体制改革”“数据交易制度与市场竞争机制”和“数据赋能生产率提升与监管平衡”五大主题;②数据要素价值化呈现多维度协同特征,并形成动态演进机制。

本文引用格式

陈婉铭 , 刘媛华 . 基于BERTopic主题模型的数据要素价值化热点主题及演化分析[J]. 知识管理论坛, 2025 , 10(6) : 553 -564 . DOI: 10.13266/j.issn.2095-5472.2025.037

Abstract

[Purpose/Significance] This study employs the BERTopic model to analyze the core themes, evolutionary pathways, and frontier dynamics of data element valorization in China, providing a macro perspective and objective foundation for advancing theoretical exploration and guiding practical applications. [Method/Process] Having used 1735 articles published in CNKI from 2019 to the present as the dataset, this research had applied the BERTopic topic modeling approach. First, a semantic embedding space had been constructed using a pre-trained language model, and UMAP had been applied for dimensionality reduction, combined with HDBSCAN for density-based clustering, to have initially generated the incorporation of a temporal analysis method to trace the dynamic evolution of research topics. [Result/Conclusion] The findings reveal that: ① Current research themes focus on five key areas: "Enterprise Innovation and Data Element Market Cultivation", "Data Infrastructure Systems and Industrial Digital Transformation", "Element Marketization Allocation and Institutional Reform", "Data Transaction Systems and Market Competition Mechanisms", and "Data Empowerment for Productivity Improvement and Regulatory Balance". ② Data element valorization exhibits multidimensional collaborative characteristics and forms a dynamic evolutionary mechanism.

2019年10月,党的十九届四中全会通过的《中共中央关于坚持和完善中国特色社会主义制度、推进国家治理体系和治理能力现代化若干重大问题的决定》,将数据作为与劳动、资本、土地、知识、技术、管理并列的生产要素。《“数据要素×”三年行动计划(2024—2026年)》于2024年1月正式发布。该文件从征求意见稿到正式发布仅历时半个多月,充分体现了国家对激发数据要素潜力的迫切期望,同时也反映了社会各界对加速数据要素赋能的急切需求[1]。数字经济时代,人工智能、大数据、区块链等新一代数字技术的发展为海量数据的产生提供技术支持,几乎所有事物都以“0—1”编码的二进制字符串的形式存在,数据是核心生产要素[2]。在数字时代,数据要素作为经济社会发展的核心生产要素,成为推动企业转型、加速技术经济与发展模式变革以及全面提高国民经济运行效率的重要动力[3-6]。
数据作为关键生产要素,其价值化是驱动数字经济发展的核心议题。学界虽已围绕数据要素的内涵、战略意义及所面临的挑战展开了广泛探讨[7-9],但对于其价值实现的核心机制与演化路径,仍缺乏系统性的理论归纳与深度的学理分析。清晰勾勒出该领域的知识结构、识别前沿热点是推动理论深化的重要前提。然而,目前尚缺少对“数据要素价值化”研究领域进行系统性知识图谱绘制的尝试,特别是运用深度学习模型对海量文献进行主题挖掘与演化分析的研究更为鲜见,因而难以全面把握该领域的研究脉络和未来趋势。为弥补这一空白,本研究引入BERTopic主题模型,旨在对数据要素价值化领域的学术文献进行深度挖掘。BERTopic模型融合了深度语言表示与密度聚类,能更精准地捕捉文本中的潜在语义主题[10]。
通过应用BERTopic模型,本研究将系统分析和挖掘关于数据要素价值化的相关主题,建立一个更加全面的理论框架,了解专家学者们的科研热点,以及所深入理解数据要素价值化的研究的状况, 研究发展热点以及发展脉络,丰富数据要素价值化的学术研究。

1 研究综述/Research Review

2019年,我国首次提出将数据纳入新型生产要素的范畴。唐要家等指出,数据要素通常指的是经过清洗、整合和挖掘,从而影响企业决策和竞争优势的原始数据[11]。C. L. P. Chen 等研究了数据在各个领域的重要性,特别关注其应用潜力和面临的挑战,为数据要素的价值和实现其最大化提供了重要的理论基础和实践指导[12]。在这一背景下,数据驱动的价值创造过程日益展现出灵活性、动态性和非线性特征,具有多维和跨界的背景,并在与其他生态系统交换信息的环境中不断演变[13-14]。
数据要素价值演进路径,大致可分为三阶段论和四阶段论两种模式。黄科满等认为这3个阶段包含数据资源化、数据资产化和数据资本化[15]。徐蔼婷等则以数据要素的生产过程为基础,认为数据要素价值释放应包含数据生成、数据获取、数据分析和数据应用4个环节[16]。伴随理论不断发展,金骋路等对数据要素价值化的实践发展与理论研究进行了融合梳理[17]。在具体实践与应用方面,刘桂锋等运用质性分析法对文本资料进行编码,形成数据应用场景的创新研究[18]。随着对数据要素认识的深化,未来的研究将更加关注数据的多维价值创造及其对社会经济发展的长远影响。

2 研究设计/Research Design

2.1 数据来源与清洗

本文以数据要素价值化领域为研究范畴,以中国知网(CNKI)数据库为数据源,设定文献筛选标准如下:①采用精确检索,主题检索式为“TI=数据要素AND(数据价值化OR数据资产化OR数据经济OR数据价值评估OR数据应用价值OR数据增值OR数据市场化”;②发表时间限定为2019—2025年,检索时间为2025年2月25日;③文献类型限定为学术期刊论文,排除会议论文、报纸及学位论文;④语言类型选择中文。通过CNKI高级检索功能共获得原始文献1 785篇,经二次筛查剔除摘要文本缺失、时间信息不完整等文献,最终形成1 735篇文献样本集。

2.2 研究方法与框架

2.2.1 BERTopic主题聚类方法

本文采用BERTopic模型对数据要素价值化领域期刊论文摘要进行隐含主题识别。BERTopic是一种话题提取模型,可以对大量的短文本数据进行高效的建模[19-20]。2018年,J. Devlin等提出了基于深层Transformer的预训练语言模型BERT(Bidirectional Encoder Representations from Transformers),而BERTopic是基于BERT模型提出的文档主题聚类方法,从而实现自然语言处理,有效提升了研究的准确性[21-24]。与传统的潜在狄利克雷分配(Latent Dirichlet Allocation, LDA)、元胞传输模型(Cell Transmission Model, CTM)等主题模型相比,该模型克服了传统方法中基于密度聚类与基于中心采样之间不兼容的缺点,而且无须人为设置主题数量等超参数,免去了复杂的参数调试过程[25]。与经验归纳的机器学习模型不同,BERTopic模型对短文本有良好的处理效果,且能够加入时间变量分析主题变化趋势[26]。
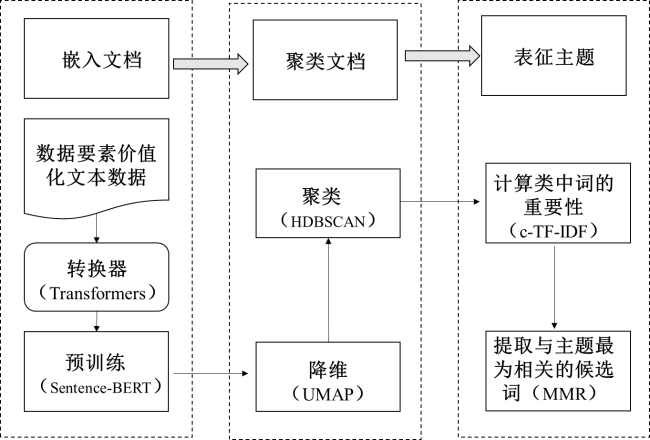
该模型融合深度学习与统计建模的优势,其核心架构见图1。首先,基于预训练语言模型生成文本语义嵌入向量,利用Sentence-BERT框架将摘要文本映射至语义空间,以捕获专业术语的深层语义关联。然后,通过均匀流形近似和投影(Uniform Manifold Approximation And Projection, UMAP)降维保留局部语义结构,进而运用HDBSCAN密度聚类识别语义相近的文档簇,自动优化主题数量并过滤离群点。最后,结合c-TF-IDF计算主题词权重,以增强主题表征的区分度和可解释性,并通过最大边际相关性(Maximum Marginal Relevance, MMR)算法筛选代表性主题关键词。
图1 BERTopic主题模型流程

Figure 1 Flowchart of the BERTopic topic model

2.2.2 研究框架

(1)数据获取及文本预处理。本研究选取中国知网中与“数据要素价值化”主题密切关联的期刊论文作为原始语料,通过系统筛选流程,将符合要求的文献摘要及时间进行结构化整合,形成初始文本数据集。在数据清洗处理阶段,主要进行停用词剔除和分词等操作。这一步骤旨在去除冗余信息和噪声,构建符合自然语言处理要求的语料,从而为整体的文本聚类效果奠定坚实基础。
(2)文本向量化。文本向量化是将预处理后的文本数据转换为数值化表示的关键步骤,也是主题建模的基础。本研究选用BERT-base-Chinese架构实施文档编码。通过多层Transformer结构的自注意力机制,生成固定长度的密集向量,这些向量能够有效捕获文本中丰富的上下文语义信息。为进一步提升文本表示的精度,文本向量化过程中还结合了词汇加权与向量微调技术,使得生成的嵌入不仅保留了深层语义特征,还能更好地适应后续的降维与聚类任务。
(3)降维处理。针对文本嵌入向量的高维特性,本研究引入UMAP算法对高维文本嵌入向量进行降维处理。该算法通过构建高维空间中的邻域图,在低维投影中同步保持局部流形结构和全局拓扑特征,在实现高效降维的同时最大化保留语义关联。具体计算如公式(1)所示:
∑ e ∈ E w h ( e ) l o g ( w h ( e ) w l ( e ) ) + ( 1 - w h ( e ) ) l o g ( 1 - w h ( e ) 1 - w l ( e ) )
w h ( e )是原始数据高维度情况下E的权值, w l ( e )是降维后低维情况下E的权值。
这种降维方法不仅显著降低了计算和存储的复杂性,而且为后续的聚类操作提供了具有优化流形结构的特征表示,从而提升了主题聚类的效果。
(4)聚类。在降维后的低维向量空间中,本研究采用HDBSCAN算法对文本数据进行聚类。HDBSCAN通过在数据中识别密度较高的区域,将相似内容的文档自动归为同一聚类,并能自适应地确定最佳聚类数目。相比DBSCAN算法HDBSCAN主要做了如下几个优化。
定义了一种衡量两个点之间距离的方式,如公式(2)所示:
d m r e a c h - k ( a , b ) = m a x { c o r e k ( a ) , c o r e k ( b ) , d i s t a n c e ( 1 , b ) }
该方法使用了最小生成树来建立点与点之间的层次结构模型,并引入了层次聚类的思想。同时,对最小生成树进行了剪枝,限制了生成的最小子树的大小,以控制生成的类簇不要过小。
定义了一种用于度量聚类分裂质量的度量方式“Stability”:定义每个点的密度度量为 λ = 1 ε,其中 ε为该点与其他聚类中点的最短距离;定义了一个簇的生成密度 λ b i r t h, λ b i r t h是这个簇生成时分裂边的导数;一个簇的密度定义为 δ = ∑ p ∈ c l u s t e r ( λ b i r t h - λ b i r t h ),则HDBSCAN需要找到最大 ∑ δ的分裂簇方法,同时需要满足最小簇类大小。
此外,该方法在聚类过程中有效识别并剔除噪声数据,避免将无关文档分配至任何主题,从而确保聚类结果具有较高的稳定性和语义一致性,为后续主题表征提供了坚实的基础。
(5)主题表示。聚类完成后,为每个主题构建词袋模型表征,并采用基于类的TF-IDF方法(c-TF-IDF)对每个主题内的词汇进行加权。通过简单地连接文档,将聚类中的所有文档视为单个文档。然后,通过将文档转换为聚类来调整TF-IDF以考虑该表示,其计算形式如公式(3)所示:
W t , c = t f t , c l o g ( 1 + A t f t )
关键词t在文档d中的频率,c用于表示类,类是针对每个聚类连接成单个文档的文档集合。A表示每一个类中的平均词频量。该方法将同一聚类中的所有文档视为一个整体,基于词频与逆文档频率的组合得分,提取出能够充分反映主题特征的关键词。为了进一步提升关键词的多样性并减少冗余,本研究运用最大边际相关性算法对候选关键词进行筛选和排序。该算法在动态平衡词项—主题关联度与词项间互信息相似度的基础上,确保主题表征的精准性又具有较高的区分度。
(6)热点主题和演化分析。最后,基于主题的词汇构成和语义特征,解析各主题的核心内容,明确其在数据要素价值化领域中的研究重点。针对每个主题和时间片计算c-TF-IDF,生成时序主题表征矩阵,从而有效追踪主题在时间维度上的变化趋势,对提取出的动态主题进行演化趋势分析,研究各主题在不同时间段内的情况。本文通过主题挖掘与演化分析,旨在揭示数据要素价值化领域内的研究热点、技术变迁及未来发展趋势,探讨其背后的驱动因素和发展逻辑。

3 主题识别及趋势分析/Topic Identification and Trend Analysis

3.1 热点主题分析

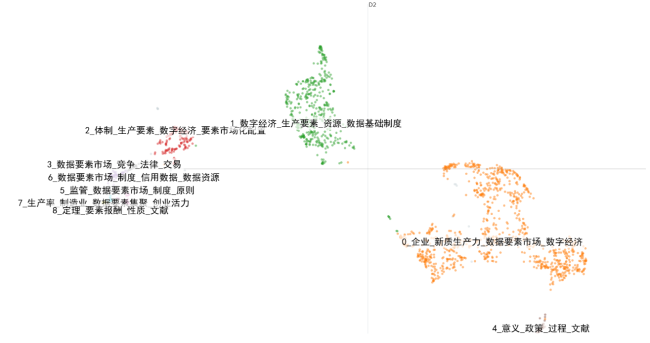
使用BERTopic生成了9个主题,对应的文本聚类图先通过降维技术将高维文本嵌入映射到二维平面,形成一个直观的文档—主题分布图。该聚类图展示了模型自动聚类的结果,每个聚类代表一个初步识别的主题。聚类图中,各主题簇之间的距离和重叠区域直观反映了文档间的语义相似性与差异性(见图2),为后续的动态主题分析和深层文本挖掘提供了重要的可视化依据。由于初始聚类可能产生过多颗粒度较细的主题,导致语义重叠问题,因此需要对聚类结果进行优化。为此,采用主题合并策略,将相似的主题整合成更大、更具代表性的主题集合,从而减少主题数量并提高整体可解释性。此外,系统会自动选取每个主题中得分最高的前4个词汇,并基于这些代表性词汇生成主题名称,例如主题1的自动命名为“0_企业_新质生产力_数据要素市场_数字经济”,为后续的分析提供直观依据。
图2 “数据要素价值化”数据集文档—主题分布

Figure 2 "Valorisation of Data Elements" dataset documentation - thematic mapping

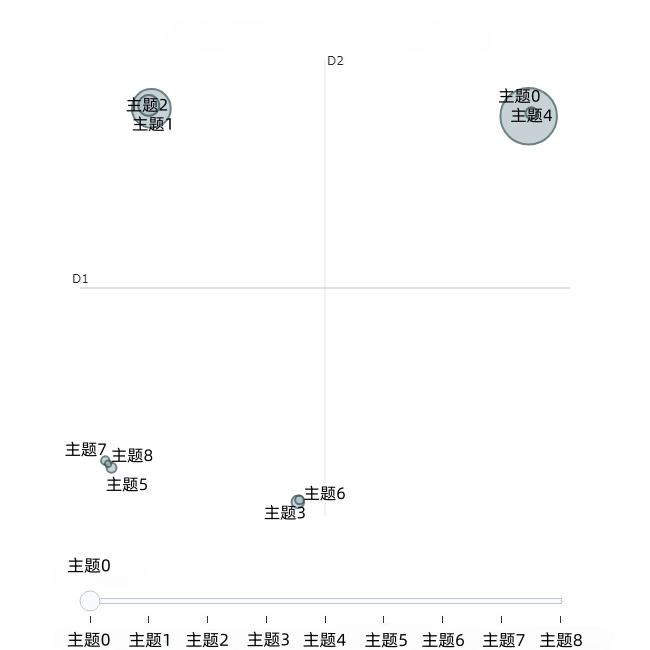
调用函数可视化所有主题,生成的交互式图谱如图3所示,每个圆圈代表一个主题,其大小是该主题在所有文档中出现的频率,距离的远近代表主题间的相似度,距离越近主题相似度越高。从中可得,主题1(0_企业_新质生产力_数据要素市场_数字经济)、主题2(1_数字经济_生产要素_资源_数据基础制度)是出现频率最高的主题。
图3 “数据要素价值化”数据集主题聚类

Figure3 Thematic clustering map for the "Valorisation of Data Elements" dataset

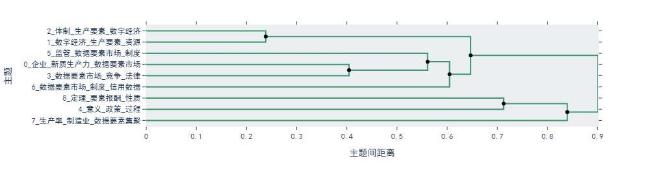
分层聚类是一种将文本数据或主题按照相似性逐步合并形成层次结构的技术,在这一过程中,每一层的聚类都代表了不同的抽象层次或语义细节。在分层聚类中,初始的低层次聚类可被视为更高层次聚类的细分部分,这些聚类按照它们之间的相似度和抽象程度组织成树状结构,有助于更好地揭示文档或主题间的内在关系。该方法不仅适用于大规模语料库的高效管理,还可以用于整合相似主题,从而减少主题数量,提高整体的可解释性。分层聚类的实现依赖于主题—词项权重分布矩阵(c-TF-IDF矩阵),该矩阵为每个主题中的词汇提供了重要性评分,通过计算不同主题之间的距离(距离越小表明相似性越高),可以近似推导出潜在的层次结构。图4可视化呈现层次化聚类框架的主题融合过程,从中可以直观地观察到各聚类之间的层次关系及其语义联系。
图4 “数据要素价值化”数据集主题分层聚类

Figure 4 "Data Element Valorization" dataset topic hierarchical clustering map

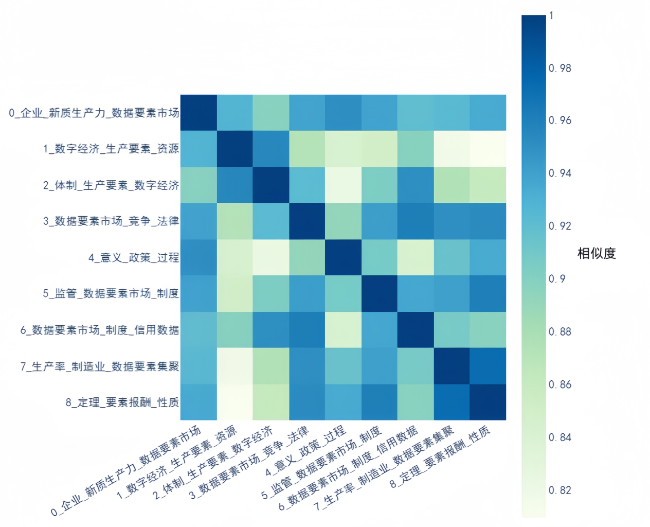
图5以热力图形式可视化展现了潜在语义主题间的相似性矩阵。该矩阵通过颜色梯度表征不同主题间的相似性,相似度越高的主题在后续的合并过程中越有可能被归为同一类别。该相似度图不仅为自动化主题合并提供了量化依据,也为人工审查和解读提供了有力参考,有助于进一步精简和优化主题结构。
图5 “数据要素价值化”数据集主题相似度

Figure 5 "Data Element Valorization" dataset topic similarity map

本次模型共生成了9个主题,通过分析以上主题间的关系图发现,部分主题在语义上高度相似且关联紧密。为了提升主题的区分度和解释力,需要对这些相似主题进行合并处理。首先,利用层次聚类图对初始主题间的亲疏关系进行宏观判别。该图基于主题向量的余弦相似度构建,图中较低的合并分支点直观地揭示了主题间的高度相似性,由此可初步识别出具有合并潜力的主题簇。为确保该识别的可靠性,研究进一步引入了量化与空间维度的验证,矩阵中高亮色块对应的高相似度值为主题合并提供了数值支持。同时对主题间距离图与文档—主题二维投影图进行考察,语义相关的候选主题在降维空间上表现为相互邻近、边界模糊的散点簇。最终,只有同时满足“层次聚类距离近、相似度得分高、空间分布邻近”这三重标准的主题,才被确定为合并对象,再结合人工解读,汇总得出该领域的主题及对应词表,并将9个二级主题整合归纳为5个一级主题,见表1。针对每个主题下的词汇,选取排名前20的特征词作为代表性关键词(见表2),用于表示各主题的具体含义。
表1 “数据要素价值化”数据集主题合并

Table 1 "Data Element Valorization" dataset topic merging

一级主题 二级主题
0_企业_新质生产力_数据要素市场_数字经济 0_企业_新质生产力_数据要素市场_数字经济
1_数字经济_生产要素_资源_数据基础制度 1_数字经济_生产要素_资源_数据基础制度
2_体制_生产要素_数字经济_要素市场化配置 2_体制_生产要素_数字经济_要素市场化配置
3_数据要素市场_交易_制度_数字经济 3_数据要素市场_竞争_法律_交易
5_监管_数据要素市场_制度_原则
6_数据要素市场_制度_信用数据_数据资源
4_生产率_数字经济发展_技术_监管 4_意义_政策_过程_文献
7_生产率_制造业_数据要素集聚_创业活力
8_定理_要素报酬_性质_文献
表2 “数据要素价值化”数据集主题词

Table 2 "Data Element Valorization" dataset topic keywords

主题 主题名字 关键词(前20个)
主题1 企业创新与数据要素市场培育 企业、数据要素市场、新质生产力、数字经济、创新、生产要素、技术、政策、制度、过程、数据要素市场化、路径、实践、数据要素价值、政府、城市、特征、交易、产业、安全
主题2 数据基础制度与产业数字化转型 数字经济、生产要素、资源、创新、技术、产业、数据基础制度、数据资源、数字化、数字经济发展、战略、数据要素市场、数字中国、新型、改革、管理、高质量发展、科技、数据要素价值、引擎
主题3 要素市场化配置与体制改革 生产要素、体制、数字经济、要素市场化配置、数据资源、数据要素市场、大数据、技术、资源、新型、数字化、战略、中共中央国务院、安全、制度、大数据产业、保护、创新、数字化转型、劳动力
主题4 数据交易制度与市场竞争机制 数据要素市场、交易、制度、数字经济、法律、生产要素、数据交易、竞争、技术、治理、安全、政府、分配、垄断、保护、定价、过程、有序、规则、范围
主题5 数据赋能生产率提升与监管平衡 生产率、数字经济发展、技术、监管、数据要素市场、数字经济、制造业、数据交易平台、生产要素、企业、路径、数据要素集聚、政策、收入分配、制度、交易、数据要素市场建设、环境、创业活力、原则
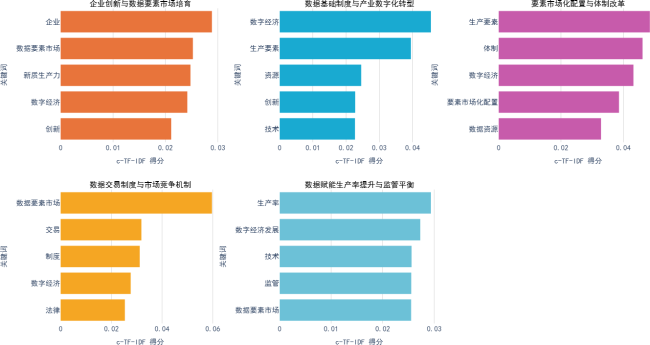
图6展示了聚类后各主题词的得分情况,词得分越高表明该词汇在表征相应主题时越具有代表性。在主题解读过程中,通过参考词得分,可以准确确定每个主题的核心词汇。主题1、4、5均高频出现“数据要素市场”关键词,表明其在数据要素流通和价值实现中具有核心地位。其中主题4进一步聚焦“交易”“市场制度”等机制设计问题,凸显出完善交易规则与产权制度是当前市场化进程中的关键挑战,印证了制度性研究的重要性正在提升。
图6 “数据要素价值化”数据集主题词得分情况

Figure 6 "Data Element Valorization" dataset topic keyword scores

主题2(创新、技术)与主题3(体制、要素配置)的差异化特征揭示了数据要素价值化的双重逻辑,一方面需要数字技术突破(如区块链确权、隐私计算)支撑要素流通;另一方面需要通过体制改革破除数据孤岛,其关键词“要素市场化配置”与“数据资源”的共现,反映出构建全国统一大市场政策导向下的研究热点。主题1的“新质生产力”与主题5的“生产率”“数字经济发展”形成呼应,证实数据要素通过优化资源配置效率正在重构生产力体系。主题1中“企业”作为唯一市场主体关键词的出现,揭示了企业数据治理能力、数据资产化实践已成为影响价值化进程的重要变量。
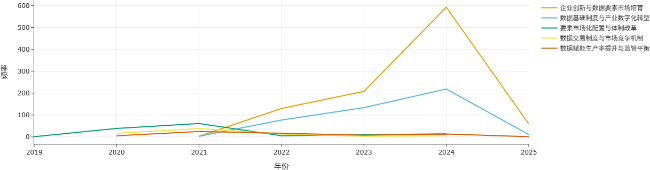
图7展示了基于BERTopic的动态主题在不同时间窗口下的文档数量。主题整体上呈现出技术主题强度逐步增强的趋势,表明该领域的技术创新活动在持续增长。趋势预测显示,"企业创新与数据要素市场培育"与"数据基础制度与产业数字化转型"依然是近5年的研究热点,该阶段对企业创新及数据要素市场构建的高度关注,可能与政策推动、数据要素市场建设的深化以及企业实践的增加有关。这可能与政策推动、数据要素市场建设的深化以及企业实践的增加有关。“数据基础制度与产业数字化转型”在2022—2024年逐步上升,数据基础设施建设、产业数字化的进程持续推进,相关研究逐步增多。“要素市场化配置与体制改革”主题的关注度一直较为平稳,说明该议题在政策和学术层面具有稳定的讨论度,而且因为制度改革往往是渐进的,需要长期探索。“数据交易制度与市场竞争机制”主题波动不大,数据流通、市场竞争和体制约束的讨论可能仍处于探索阶段。“数据赋能生产率提升与监管平衡”主题在2024年出现显著增长,这可能是由于数据要素在推动生产率提升方面的重要性被广泛认可,同时监管平衡的议题也在数字经济发展中逐步凸显。
图7 “数据要素价值化”数据集主题时间演化

Figure 7 "Data Element Valorization" dataset topic temporal evolution map

3.2 结果解读

主题1“企业创新与数据要素市场培育”。该主题聚焦于数字经济范式下企业参与数据要素市场构建,聚焦数据要素驱动技术创新与生产力的动态过程。关键词“新质生产力”“数据要素价值”表明,研究不仅关注数据作为生产要素的经济属性,更强调其通过企业创新活动转化为新型生产力形态的过程,具有显著的实践导向特征。高频词“政策”“制度”说明政府政策和相关制度在数据要素市场培育中扮演着关键角色,如“数据二十条”中“三权分置”产权制度的落地实践。地方政府通过建设数据交易所、试点数据资产入表等举措,降低企业数据要素获取与交易成本。在数字经济和新质生产力背景下,数据作为一种新型生产要素的市场培育过程,既包含技术创新,也离不开政策支持,且需要在产业和城市层面上推动其发展。这一主题反映了数据要素市场化的复杂性与多层面性,涉及技术、政策、市场等多个维度。
主题2“数据基础制度与产业数字化转型”。该主题聚焦数据基础制度对数据资源向生产要素转化的制度性支撑及其对产业数字化转型的赋能机制。关键词“数据基础制度”“产业”“数字中国”表明,研究将数据基础制度视为驱动数字经济发展的核心动力系统,数字经济对产业发展的影响,特别是在推动产业数字化转型方面的作用。关键词“技术”“创新”“科技”强调了技术在推动数字化转型过程中的主导作用,推动数据资源转化为生产要素,进而促进各产业的数字化转型,支持数字经济发展和数字中国战略。该主题强调了数据作为核心资源的价值,同时探讨了数字化管理、制度改革与技术创新在推动产业转型中的作用。
主题3“要素市场化配置与体制改革”。该主题聚焦于数字经济时代下传统生产要素(劳动力、资本、土地)与新型生产要素(数据)市场化配置的协同改革。关键词 “体制”“制度”表明体制和制度的改革是实现要素市场化配置的关键。通过政府的政策和制度框架调整,推动数据要素的市场化、流动性和有效利用。“大数据产业”和“数字化转型”“新型”这些词汇可以看出,数字化不仅是技术应用的层面,也涉及产业结构的深度调整和经济发展模式的转型。数据要素的市场化和技术进步密切相关,通过数字化转型,传统产业可实现从生产到管理模式的全面升级。“安全”与“保护”表明数据资源的市场化配置和流动必然伴随一定的安全风险,这也是市场化配置中的关键问题。
主题4“数据交易制度与市场竞争机制”。该主题聚焦于数据要素市场化进程中交易规则的设计与市场竞争秩序的优化,其核心体现为数据流通效率与市场公平安全的动态平衡。关键词如“数据要素市场”“交易”“数据交易”,表明这个主题着重探讨数据要素在市场中的流通和交易过程。数据作为生产要素,其交易机制的有效性直接影响市场的健康发展。“法律”“制度”“规则”“政府”等关键词表明数据交易的合法性与合规性是保障数据市场健康发展的基础。词汇“定价”“分配”显示了数据作为生产要素的市场化交易中,如何合理定价和公平分配也是一个需要关注的问题。该主题涉及如何通过制度、法律、技术保障数据交易的有序进行,如何通过竞争政策避免市场垄断,以及如何在确保数据安全和隐私保护的基础上进行定价、分配和治理。
主题5“数据赋能生产率提升与监管平衡”。该主题聚焦于数据要素通过技术创新与市场化配置对全要素生产率的驱动效应,同时探讨如何在激发数据经济活力的前提下构建适配的监管框架。关键词如“生产率”“数据赋能”“数字经济发展”“技术”,表明该主题关注数据如何作为生产要素推动企业和产业的生产率提升。特别是在数字经济背景下,数据赋能的作用更加突出。关键词“监管”“制度”“原则”表明,数据资源的市场化交易过程中涉及诸多监管挑战,如数据隐私保护、市场公平性等。关键词“收入分配”“环境”“创业活力”表明,数据赋能不仅影响生产率,还可能带来收入分配的变化,激发创业和创新的活力。
总体来看,主题经历了一个从“宏观制度探讨”向“中观市场构建”再到“微观创新应用”的演进过程。第一阶段为奠基期(2019—2021年),“要素市场化配置与体制改革”是关注度最高的主题。在数据要素价值化的早期探索中,学术界的讨论焦点集中于如何将数据纳入传统生产要素的统一市场化配置框架中,并推动相关的体制机制改革。在此阶段,其他与数据直接相关的主题尚未形成规模,处于萌芽状态。第二阶段为发展期(2022—2023年),聚焦中观市场与制度建设。从2022年开始,“要素市场化配置与体制改革”的热度逐渐下降,“企业创新与数据要素市场培育”和“数据基础制度与产业数字化转型”开始崛起。这标志着研究重点从宏观的要素改革,下沉至数据要素这一特定领域。对“数据基础制度”的关注,反映了构建数据产权、流通交易、收益分配等核心制度体系的迫切需求,而“数据要素市场培育”热度的攀升,意味着如何激活市场、赋能企业创新成为新的核心议题。第三阶段为高峰期(2024年),“企业创新与数据要素市场培育”主题的讨论频次达到峰值,同时“数据基础制度与产业数字化转型”也达到其热度高点。这一现象表明,随着各项数据基础制度日渐完善,研究重心已转向如何运用市场化机制驱动企业创新、深化产业数字化转型。

4 结果与讨论/Results and Discussion

本文通过BERTopic模型对数据要素价值化领域文献进行主题挖掘,经多阶段优化后形成主题体系。模型初始聚类生成9个主题簇,识别出23篇文献(占总样本的1.33%)作为噪声点(标记为-1)。通过人工干预策略,最终保留5个核心主题,分别为“企业创新与数据要素市场培育”“数据基础制度与产业数字化转型”“要素市场化配置与体制改革”“数据交易制度与市场竞争机制”和“数据赋能生产率提升与监管平衡”。
5个主题共同构成了数据要素价值化研究的多维度协同体系,每个主题聚焦了数据要素价值化过程中不同的关键维度,涵盖了从宏观制度改革到微观创新应用的广泛议题。这些主题不仅揭示了数据要素价值化的复杂性,还展示了技术、制度、市场三者交织的动态演进过程。从理论上看,数据要素价值化代表了生产要素理论的范式转变,从传统的“资本—劳动—土地”三要素转向数据这一新型生产要素的崛起。这一过程是技术创新、制度变革与市场适配的多维度协同,也是数字经济时代下经济发展模式的根本转型。从实践角度看,数据要素价值化的实施不仅需要政府提供强有力的制度保障,还需要市场在交易、定价、分配等方面进行有效调节。同时,企业的创新活力也需要在市场机制的激励下得到充分释放,推动数据要素的实际应用与价值实现。数据要素价值化呈现多维度协同特征,其本质是技术创新驱动、制度体系重构与产业生态优化的系统性耦合过程,通过政策引导、市场适配与治理迭代的交互作用,形成动态演进的价值创造机制。
未来,数据要素研究重点将转向如何在推动创新和市场化的同时,保持监管的平衡。随着全球数据治理问题的日益突出,跨境数据流动和数据隐私保护将成为未来研究和政策制定的关键议题。如何构建更加完善的全球数据交易规则,如何在保障数据安全与隐私的前提下推动数据要素的流通与应用,是未来数字经济发展的核心挑战。

陈婉铭:数据收集与分析,论文撰写;

刘媛华:论文结构设计,论文修改与定稿。

[1]
吴江, 陶成煦. 激活数据要素赋能千行万业——《“数据要素×”三年行动计划(2024—2026年)》政策解读[J]. 情报理论与实践, 2024, 47(3): 16-19.

WU J, TAO C X. Activating data elements empowers thousands of businesses: policy interpretation of "the 'Data Elements x' Three-year Action Plan(2024-2026)" [J]. Information studies: theory & application, 2024, 47(3): 16-19.

[2]
李海舰, 赵丽. 数据成为生产要素: 特征、机制与价值形态演进[J]. 上海经济研究, 2021(8): 48-59.

LI H J, ZHAO L. Data becomes a factor of production: characteristics, mechanisms, and the evolution of value form [J]. Shanghai journal of economics, 2021(8): 48-59.

[3]
张继栋. 地方国有企业数字化转型路径探讨[J]. 现代管理科学, 2021(3): 96-102.

ZHANG J D. Practical suggestions and approaches for digital transformation of local stateowned enterprises[J]. Modern management science, 2021(3): 96-102.

[4]
刘尚希, 邢丽, 樊轶侠, 等. 以数字化引领数实融合的内在机理与现实思考[J]. 财政研究, 2023, (12): 3-15.

LIU S X, XING L, FAN Y X, et al. The inner mechanism and realistic thinking of digitalization leading the integration of digital economy and real economy[J]. Public finance research, 2023(12): 3-15.

[5]
俞伯阳, 丛屹. 数字经济、人力资本红利与产业结构高级化[J]. 财经理论与实践, 2021, 42(3): 124-131.

YU B Y, CONG Y. Digital economy, human capital dividends, and advanced industrial structure[J]. The theory and practice of finance and economics, 2021, 42(3): 124-131.

[6]
尹西明, 林镇阳, 陈劲, 等. 数据要素价值化动态过程机制研究[J]. 科学学研究, 2022, 40(2): 220-229.

YIN X M, LIN Z Y, CHEN J, et al. Research on the dynamic value creation process of data element [J]. Studies in science of science, 2022, 40(2): 220-229.

[7]
柳卸林, 董彩婷, 丁雪辰. 数字创新时代:中国的机遇与挑战[J]. 科学学与科学技术管理, 2020, 41(6): 3-15.

LIU X L, DONG C T, DING X C. Innovation in the digital world: the opportunities and challenges of China [J]. Science of science and management of S.& T., 2020, 41(6): 3-15.

[8]
刘业政, 孙见山, 姜元春, 等. 大数据的价值发现:4C模型[J]. 管理世界, 2020, 36(2): 129-138.

LIU Y Z, SUN J S, JIANG Y C, et al. 4C model: value discovery in big data [J]. Journal of management world, 2020, 36(2): 129-138.

[9]
何伟. 激发数据要素价值的机制、问题和对策[J]. 信息通信技术与政策, 2020(6): 4-7.

HE W. Mechanism, problems and countermeasures to stimulate the value of data [J]. Information and communications technology and policy, 2020(6): 4-7.

[10]
杨思洛, 吴丽娟. 基于BERTopic模型的国外信息资源管理研究进展分析[J]. 情报理论与实践, 2024, 47(2): 189-197.

YANG S L, WU L J. Research progress of foreign information resource management: an analysis based on the BERTopic model[J]. Information studies: theory & application, 2024, 47(2): 189-197.

[11]
苏会灵. 档案数据要素流通的关键问题与对策研究[J]. 山西档案, 2024(2): 62-64.

SU H L. Research on key issues and countermeasures of archival data element circulation [J]. Shanxi archives, 2024(2): 62-64.

[12]
CHEN C L P, ZHANG C Y. Data-intensive applications, challenges, techniques and technologies: a survey on big data [J]. Information sciences, 2014(275):314-347.

[13]
CHEN M, MAO S, LIU Y. Big data: a survey[J].Mobile networks & applications, 2014, 19(2):171-209.

[14]
CHEN P. Visualization of real-time monitoring datagraphic of urban environmental quality [J]. EURASIP journal on image and video processing, 2019, 42: 1-9.

[15]
黄科满, 杜小勇. 数据治理价值链模型与数据基础制度分析[J]. 大数据, 2022, 8(4): 3-16.

HUANG K M, DU X Y. Value chain model of data governance and its application on data governance regulation analysis [J]. Big data research, 2022, 8(4): 3-16.

[16]
徐蔼婷, 宋妙缘. 基于“价值创造—实现”路径的数据要素核算问题研究[J]. 现代经济探讨, 2024(4): 13-21.

XU A T, SONG M Y. Research on data factor accounting based on the path of "value formation and release" [J]. Modern economic research, 2024(4): 13-21.

[17]
金骋路, 陈荣达. 数据要素价值化及其衍生的金融属性:形成逻辑与未来挑战[J]. 数量经济技术经济研究, 2022, 39(7): 69-89.

JIN C L, CHEN R D. Data valuations and its derived financial attributes: formation logic and future challenges [J]. Journal of quantitative & technological economics, 2022, 39(7): 69-89.

[18]
刘桂锋, 吴雅琪, 韩牧哲, 等. 面向数据要素价值化的数据资源应用场景创新研究[J]. 情报理论与实践, 2025, 48(1): 53-62.

LIU G F, WU Y Q, HAN M Z, et al. Research on the innovation of data resource application scenarios oriented to the valorization of data elements [J]. Information studies: theory & application, 2025, 48(1): 53-62.

[19]
GROOTENDORST M. BERTopic: neural topic modeling with a class-based TF-IDF procedure[J]. arXiv preprint, 2022, arXiv:2203.05794.

[20]
张敏, 沈嘉裕. 突发公共卫生事件中政务短视频主题与用户行为的关联演化研究[J]. 情报杂志, 2023, 42(3): 181-189.

ZHANG M, SHEN J Y. Research on the evolution of the association between governmental short video themes and user behavior in public health emergency[J]. Journal of intelligence, 2023, 42(3): 181-189.

[21]
DEVLIN J, CHANG M W, LEE K, et al. BERT: pre-training of deep bidirectional transformers for language understanding[J]. arXiv preprint, 2018, arXiv:1810.04805.

[22]
EGGER R, YU J. A topic modeling comparison between LDA, NMF, Top2Vec, and BERTopic to demystify Twitter posts[J]. Frontiers in sociology, 2022, 7: 886498.

[23]
HENDRY D, DARARI F, NURFADILLAH R, et al. Topic modeling for customer service chats[C]//2021 International conference on advanced computer science and information systems(ICACSIS). Depok: IEEE, 2021: 1-6.

[24]
KIM R, KIM D. Research trends of COVID-19 in public administration and policy research studies using BERTopic topic modeling [J]. Institute of governmental studies, 2022, 28(3): 105-137.

[25]
张清慧, 陈谊, 武彩霞. 基于词表示模型的领域文献数据可视分析方法[J]. 图学学报, 2022, 43(4): 685-694.

ZHANG Q H, CHEN Y, WU C X. A visual analysis approach for domain literature data based on word representation model [J]. Journal of graphics, 2022, 43(4): 685-694.

[26]
刘洋, 柳卓心, 金昊, 等. 基于BERTopic模型的用户层次化需求及动机分析——以抖音平台为例[J]. 情报杂志, 2023, 42(12): 159-167.

LIU Y, LIU Z X, JIN H, et al. User hierarchical need and motivation analysis ased on BERTopic model: taking Douyin platform as an example [J]. Journal of intelligence, 2023, 42(12): 159-167.

文章导航

/

〈 〉