研究论文

基于引文网络和RAG的新兴主题识别和扩散研究

  • 唐昕宇 1, 2 ,
  • 陈伟 , 1, 2, 3
展开
  • 1. 中国科学院武汉文献情报中心 武汉 430071
  • 2. 中国科学院大学经济与管理学院信息资源管理系 北京 100190
  • 3. 科技大数据湖北省重点实验室 武汉 430071

作者贡献声明 /Author contributions:

唐昕宇:提出研究思路,进行数据采集和处理分析,撰写和修改论文;

陈 伟:确定论文选题,修改论文并审定。

陈伟,研究馆员,硕士生导师,E-mail:。

唐昕宇,硕士研究生

收稿日期: 2025-11-04

  网络出版日期: 2026-02-28

基金资助

中国科学院战略研究与决策支持系统建设专项课题“能源领域科技制高点研究”(GHJ-ZLZX-2025-46)

Research on Identification and Diffusion of Emerging Topics Based on Citation Network and RAG

  • Tang Xinyu 1, 2 ,
  • Chen Wei , 1, 2, 3
Expand
  • 1. National Science Library (Wuhan), Wuhan 430071
  • 2. Department of Information Resources Management, School of Economics and Management, University of Chinese Academy of Sciences, Beijing 100190
  • 3. Hubei Key Laboratory of Big Data in Science and Technology, Wuhan 430071
Chen Wei, Research Librarian, Master's Supervisor, E-mail: .

Tang Xinyu, Master's Candidate

Received date: 2025-11-04

  Online published: 2026-02-28

Supported by

Special Project on Strategic Research and Decision Support System Construction of the Chinese Academy of Sciences titled “Research on the Technological High Ground in the Energy Field”(GHJ-ZLZX-2025-46)

摘要

【目的/意义】 基于传统主题模型与大语言模型结合以及基于RAG的大语言模型设计主题建模方法,分析新兴主题和非新兴主题的扩散情况,为后续新兴主题的识别和扩散提供参考。 【方法/过程】 首先,通过传统主题模型和大语言模型结合的方法对专利进行主题挖掘,根据新颖性、连续性、增长度和影响力识别新兴主题;其次,利用RAG微调的大语言模型评分,确定最佳主题建模方法;最后,构建引文网络计算扩散速度、广度、强度、深度和地域,对新兴主题和非新兴主题扩散指标的时序变化情况进行分析。 【结果/结论】 以核聚变为实证领域,研究发现基于BERTopic+Doubao的主题建模方法效果最佳;同时新兴主题扩散呈现波动上升的趋势,非新兴主题则呈现先稳步上升后小幅下降的趋势。本文提出的传统主题模型和大语言模型结合的方法能够有效识别新兴主题,RAG微调的大语言模型优化了结果的评估效果,且丰富了主题扩散测度视角。
本文引用格式

唐昕宇 , 陈伟 . 基于引文网络和RAG的新兴主题识别和扩散研究[J]. 知识管理论坛, 2026 , 11(1) : 76 -88 . DOI: 10.13266/j.issn.2095-5472.2026.008

Abstract

[Purpose/Significance] Based on the combination of traditional topic models and large language models, as well as RAG-based large language model, this study designs the topic modeling method, analyzes the diffusion of emerging topics and non-emerging topics, so as to provide a reference for the subsequent identification and diffusion of emerging topics. [Methods/Process] First of all, the topic mining of patents was carried out through the combination of traditional topic models and large language models, and the emerging topics were identified based on novelty, continuity, growth and influence. Secondly, the best topic modeling method was determined by using the large language model score fine-tuned by RAG. Finally, a citation network was constructed to calculate the diffusion speed, breadth, intensity, depth, and region, and analyze the temporal changes of the diffusion indicators of emerging topics and non-emerging topics. [Result/Conclusion] Taking nuclear fusion as the empirical field, the research finds that the topic modeling method based on BERTopic+Doubao has the best effect. At the same time, the diffusion of emerging themes mostly shows a fluctuating upward trend, while non-emerging themes show a steady upward trend first and then a slight downward trend. The method of combining the traditional topic model and the large language model proposed in this paper can effectively identify emerging topics. The RAG fine-tuning large language model optimizes the evaluation effect of the results, and enriches the perspective of topic diffusion measurement.

准确识别具有发展潜力的新兴主题并分析其扩散情况,对把握技术变革方向、推动产业升级具有重要意义,也是当前科技创新领域的重点。但是现有新兴主题识别方法仍存在传统主题模型在处理海量多源文本时,往往受限于语义理解深度,难以准确捕捉主题的核心概念、进行自动命名等问题。随着大语言模型的崛起,其强大的语义理解能力使突破上述瓶颈成为可能,但如何将其有效、可控地融入新兴主题识别过程,仍是亟待探索的课题。
鉴于此,本文提出一种基于引文网络和检索增强生成(retrieval-augmented generation,RAG)的新兴主题识别和扩散分析框架,实现新兴主题识别从“模型拼接”到“深度融合”、评估从“主观定性”到“客观定量”、扩散分析从“维度单一”到“多维度系统刻画”的三重突破,提升新兴主题识别结果的可解释性和可复现性。以专利为数据源,将传统主题模型的结构化概率和大语言模型(large language models,LLMs)的深度语义理解能力结合,形成协同建模框架,从新兴技术核心特征出发识别新兴主题;引入RAG微调大语言模型进行主题建模效果的量化评估;最后构建更全面的扩散指标体系,采用技术生命周期法对效果最佳主题模型识别的新兴主题和非新兴主题的扩散情况进行时序分析,动态揭示主题扩散的机理和规律,为后续追踪最新发展动向、预测技术发展趋势提供参考。

1 相关研究/Relevant research

1.1 主题建模研究

主题建模是一种从文档集合中提取主题信息的无监督学习方法,现已成为信息检索和自然语言处理领域的关键技术。常用的主题建模方法分为三类:基于概率、基于嵌入模型和基于提示工程的方法[1]。①以LDA(Latent Dirichlet Allocation)、DTM(Dynamic Topic Models)为代表的基于概率的方法,如邱均平等[2]采用DTM动态主题建模对文本进行主题挖掘,从热点主题识别、主题强度演化和关键词演化路径三方面对比分析国内外话语权研究的差异。该方法能够实现文本数据降维,但存在忽略词语间的语义和序列关系以及一词多义问题,导致主题识别的准确性较低。②以BERTopic、Word2vec为代表的基于嵌入模型的方法,如阮光册等[3]采用Sentence-BERT算法对专利摘要文本进行向量化表示,识别文本集合中的主题特征。该方法考虑了词语的上下文信息,很大程度上缓解了文本稀疏性问题;但其中包含的聚类算法可能将低密度数据错分为噪声,造成关键语义信息的丢失,影响主题识别的准确性。③以PromptTopic为代表的基于提示工程的方法,主要通过设计有效的提示工程指导大语言模型对文本进行主题识别,如H. Wang等[4]利用LLMs通过主题生成、合并和表示生成三阶段从输入文档中组织和提炼主题。LLMs强大的语义理解和生成能力在一定程度上能够解决文本稀疏性问题;但生成效果的好坏严重依赖于模型性能,同时受上下文和内部知识的限制。目前主题建模方法已经从简单的概率方法逐渐向智能化的提示工程方法拓展,同时研究视角也从扁平主题挖掘深度拓展至层次主题结构[5];但现有研究多倾向于单一模型建模,往往难以同时兼顾主题识别的精度、语义连贯性和自动命名等问题,即使部分研究尝试结合多种方法,多为简单串联,未能实现建模过程的融合交互。针对上述问题,本文的核心创新之一在于构建传统主题模型和大语言模型的深度融合框架,兼顾结构化概率推理与深度语义理解,实现主题自动命名以及识别精度和语义连贯性的提升。
目前对识别的新兴主题进行有效性检验主要是定性分析,包括资料验证法和专家经验法,但现有方法存在资料滞后性、内容局限性、主观性强、效率低和缺乏量化评估等问题,难以高效、批量处理大规模数据。因此,本文尝试采用大语言模型进行结果的有效性评估。考虑到LLMs的“幻觉”问题,目前主要通过参数微调和RAG两种方法来优化LLMs,提高生成结果的准确性。其中,唐嘉等[6]通过一系列严格实验和评估,发现RAG的综合表现略优于微调模型;吴文旷等[7]通过RAG和微调技术对LLMs进行微调和性能评估,发现经过RAG微调的结果提升更大。基于上述研究,本文的另一关键创新是将RAG技术融入新兴主题识别的评估环节,实现评估方法从主观定性到客观定量的根本性转变。

1.2 主题扩散研究

S. M. Rogers将技术扩散定义为一个新构想从创新或创造的来源散播到最终采用者或使用者的过程[8]。技术扩散能够促进创新在更大范围内创造经济效益和社会效益,推动产业技术进步和结构优化。
当前多从复杂网络视角和时空维度对技术扩散的特征、模式和机制进行探索。何郁冰等[9]结合复杂网络与演化博弈理论,运用计算机仿真方法对颠覆性技术扩散特点进行研究。段尧清等[10]采用社会网络分析法对政策文本进行分析,基于政策间关系网络分析扩散的时空特征。除了上述视角的研究外,部分学者通过构建扩散测度指标进行技术扩散研究。王曰芬等[11]从扩散强度、广度、扩散爆发和分布4个维度研究成果转化的科技新闻的时空扩散过程和特征。张涛等[12]从政策扩散强度、广度、速度和方向4个方面对政策扩散特征进行分析。王丽等[14]指出知识扩散的效果可以从速度、强度和广度等维度衡量。目前研究常用扩散强度、广度和速度指标进行量化分析,对渗透深度和地域空间分布的关注不足,尚未形成完整统一的扩散指标体系,指标的测度范围较为局限。鉴于此,本文在扩散分析方面的创新则体现为在扩散速度、广度和强度指标的基础上,增加扩散深度和扩散地域指标来丰富技术主题的扩散分析视角。
综上所述,本文旨在构建一个系统性的新兴主题识别和扩散分析框架。①对主题建模方法进行融合创新,构建传统主题模型与大语言模型结合的协同建模方法;②在评估环节进行范式创新,基于RAG的大语言模型进行效果评估实现从主观定性到客观定量的转变,避免人工评判的主观影响;③在分析视角上进行维度拓展,从扩散的速度、广度、强度、深度和地域维度对最佳主题模型识别主题的扩散情况进行分析。三者形成“识别—评估—分析”的研究闭环,模型融合是基础,RAG评估是保障,扩散视角拓展是深化,旨在系统性解决现有研究存在的问题。

2 研究框架/Research framework

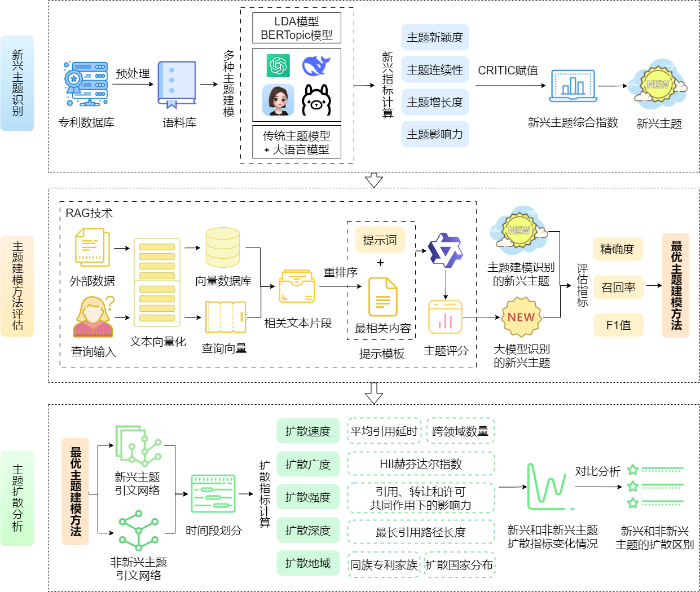
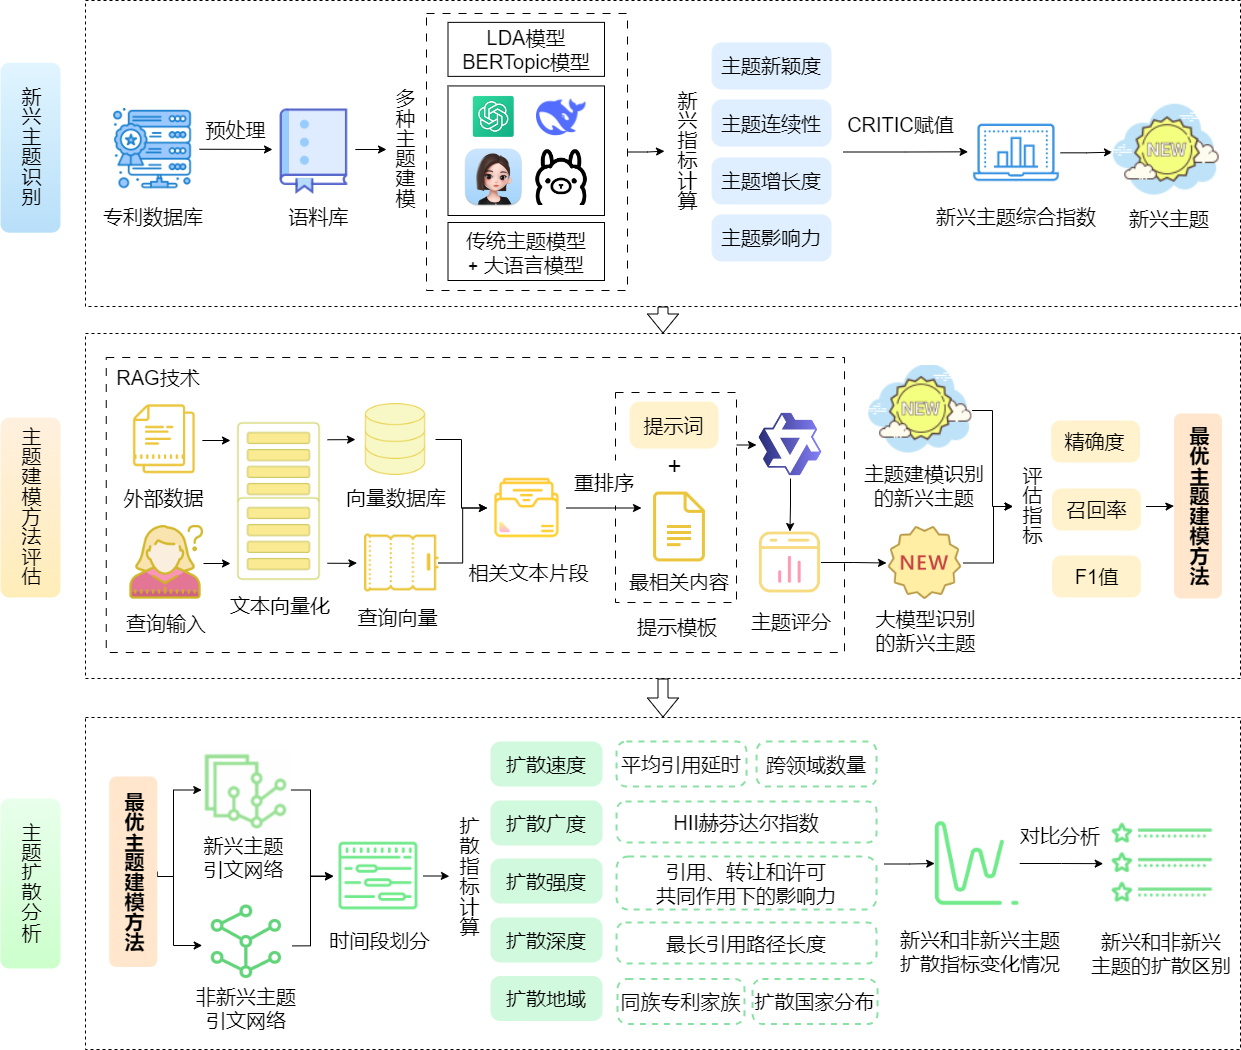
本文提出的新兴主题识别和扩散分析的研究框架见图1。首先,从专利数据库中获取和预处理题录数据,运用传统主题模型和LLMs结合的多种方法进行主题挖掘,计算新兴主题测度指标,判断各主题建模的新兴主题;其次,利用RAG微调LLMs,对各主题建模的结果进行评估,确定最优主题建模方法;最后,选取最优主题建模中识别的新兴主题和非新兴主题,构建引文网络计算其扩散速度、广度、强度、深度和地域,分析主题扩散情况。
图1 新兴主题识别和扩散框架

Figure 1 Framework diagram for emerging topic identification and diffusion

2.1 主题识别模型

LDA模型是一种非监督的文档主题生成模型,通过生成文档—主题矩阵和主题—词汇矩阵,从大规模文档集中识别潜在的主题信息。BERTopic是基于深度学习框架的主题建模技术,包括嵌入、降维、聚类和主题表示4个步骤。上述两种主题建模方法是目前研究中最常用的方法,本文将其视为传统主题模型。
随着海量文本的产生和人工智能技术的高速发展,大语言模型凭借强大的性能逐渐在主题建模方面崭露头角。LLMs能够直接对原始文本进行信息抽取,同时根据上下文内容准确理解词汇的语义信息,对少量文本仍能发挥较好性能,显著提升文本处理的效率和准确性。基于此优势,本文采用LLMs进行主题挖掘,参考司南OpenCompass网站2025年3月的LLMs学术评测榜单,综合考察国内外开闭源模型在主题识别场景下的性能表现,选定DeepSeek-R1、Doubao-1.5-pro-32k-250115、Llama3.1-405B-Instruct-FP8和o3-mini-2025-01-31这4个模型为代表进行研究。
根据选定的传统主题模型和LLMs,拟采用下述三种主题建模方式:①采用传统主题模型进行标准的无监督主题建模;②基于LLMs的语义理解和信息抽取能力,通过精心设计的提示工程实现主题挖掘,即从文本中抽取核心和代表性关键词,依据语义特征和技术关联对抽取的关键词进行聚类和标签生成、确定专利所属主题以获得主题—文本分布;③创新性地结合传统主题模型和LLMs,构建一种协同的主题建模框架。LLMs承担预处理阶段的分词和后处理阶段的标签生成,传统主题模型则专注于主题概率分布计算和识别过程。最终形成LDA、BERTopic、DeepSeek、Doubao、GPT、Llama、LDA+DeepSeek/ Doubao/GPT/Llama、BERTopic+ DeepSeek/Doubao/GPT/Llama等14种主题建模方法。
同时,构建主题与专利之间的映射关系,将主题建模结果中属于同一主题的专利文档进行聚合,形成“主题—专利集合”的对应关系。其中,对于LDA模型,选取主题—文档分布矩阵中概率值大于平均概率值的专利;对于BERTopic模型,直接使用聚类算法输出对应的主题—专利映射关系;对于LLMs模型,通过提示词模板将专利分配给最相关的主题,最终形成主题—专利矩阵。

2.2 新兴主题识别

2.2.1 新兴主题测度指标构建

基于新兴技术的特征和相关研究[14]构建的指标体系,本文从新颖性、连续性、增长度和影响力4个方面进行新兴主题测度指标的构建。
(1)新颖性。新颖性是新兴技术的根本性指标。本文采用主题下专利的平均申请年来表示主题的新颖性,具体计算[16]见公式(1)。
N j = ∑ i = 1 N T i N                               公式 1
其中, N j表示主题 j的新颖度, T i为第 i篇专利的申请年时间, N为主题 j下专利数量。
(2)连续性。连续性反映主题在时间上持续受到关注的程度。本文采用主题下专利的平均被引频次变动情况来表示主题的连续性,具体计算见公式(2)。
C j = 1 n - 1 ∑ i = 2 n C i - C i - 1 C i - 1 + 1                  公式 2
其中, C j表示主题 j的连续性, i表示主题 j中专利出现年份, C i表示第 i年主题下专利的被引频次, n为分析数据集的年份跨度。
(3)增长度。增长度反映主题的发展速度。本文采用主题下专利的年均增长率来表示主题的增长性,具体计算[17]见公式(3)。
G j = ∑ i = 2 n P i - P i - 1 / P i - 1 + 1 n - 1           公式 3
其中, G j表示主题 j的增长度, i表示主题 j中专利出现年份, P i表示第 i年主题下专利的申请数量, n为分析数据集的年份跨度。
(4)影响力。影响力反映主题的受关注程度。本文采用主题下专利的平均被引频次来表示主题的影响力,具体计算[18]见公式(4)。
I j = ∑ m = 1 N C m N                           公式 4
其中, I j表示主题 j的影响力, C m表示该主题第 m件专利的被引频次。

3.2.2 新兴主题综合指标计算

首先,为消除测度指标数量级间的差距,提高识别结果的准确性,对计算的指标采用极差标准化法进行标准化处理。其次,根据CRITIC法计算指标权重,对各主题的标准化指标进行加权求和,得到新兴主题综合指标,具体计算见公式(5),其中 W N 、 W C 、 W G 、 W I分别为新颖性、连续性、增长度和影响力的权重值。
S c o r e = W N * N j + W C * C j + W G * G j + W I * I j           公式 5
最后,对主题的新兴主题综合指数进行降序排列,采用统计学中常见的四分法确定阈值,确定Top25%的主题为新兴主题。

2.3 主题建模效果评估

在识别结果的有效性评估上,尝试采用基于简单RAG的LLMs方法。相比于传统定性分析,LLMs可以更深入地理解主题内容,评估传统指标难以量化的方面。但通用LLMs在特定领域中,可能存在生成内容与原领域的知识不符等问题,而基于RAG的LLMs能够实时抓取不同领域的多源异构数据,学习领域内特定的语言模式和知识,突破传统方法的局限性,实现评估方法从主观定性到客观定量的转变。
本文基于RAG的LLMs,设计领域自适应的提示词模板对各主题建模的结果进行评估,对评分值进行降序排列同样选取Top25%的主题作为新兴主题。以LLMs识别的新兴主题为基准,综合使用精确率、召回率和F1值作为评估指标,对主题建模方法的新兴主题识别能力进行评估。同时,此评估框架具有领域可迁移性,通过替换RAG外部知识库的领域文献和政策报告,调整提示词中的领域关键词,即可快速适配不同技术领域。

2.4 主题扩散分析

2.4.1 扩散指标构建

考虑主题扩散研究[13-14]中构建的扩散指标,本文根据专利间引用关系构建引文网络,从扩散速度、广度、强度、深度和地域5个方面构建扩散指标体系进行量化分析。
(1)扩散速度。扩散速度关注主题的传播快慢。本文借鉴贵淑婷[19]提出的扩散指标,融合被引频次、平均引用延时和跨领域数量表示主题的扩散速度,具体计算见公式(6)。
S p e e d = N * n t ¯ = N * n 1 N Σ i = 1 N ∑ j ∈ N i o u t W i j            公式 6
其中, N是网络中边的数量, n是为网络中篇均跨领域数量; W i j是节点 i与 j之间的引用延时,即专利 i与 j之间的申请时间差。
(2)扩散广度。扩散广度反映主题的影响力边界。Herfindahl-Hirschman指数(HHI)是经济学中用来测度产业集中度的综合指标,本文引入HHI来表示主题的扩散广度。IPC表示专利的技术领域,通过被引和施引专利的技术交互矩阵呈现[20],计算技术领域参与度平方和的总和,具体计算见公式(7)。
W i d t h = 1 - H H I = ∑ i = 1 n x i X 2                   公式 7
其中, X表示主题的总引用次数, x i表示主题中第 i个IPC的引用次数, n是主题包含的IPC数量。
(3)扩散强度。扩散强度体现主题的影响力集中程度。目前研究常用专利的引证和法律状态等指标描述专利知识的扩散轨迹[21],本文采用在网络中引用和转让/许可综合作用下的影响力表示主题的扩散强度,具体计算见公式(8)。
I n t e n s i t y = W c i * C i + W t r * T r                     公式 8
其中, C i和 T r分别表示技术主题 i的被引频次和转让/许可频次, W c i和 W t r分别为对应指标的权重值。本文侧重技术传播的学术影响[21],因此将 W c i和 W t r设置为0.6和0.4。
(4)扩散深度。扩散深度反映主题的深层次影响力。本文采用网络中以主题 i为起点的最长路径数表示主题的扩散深度[22],利用深度优先搜索DFS计算专利引文网络中的最长路径数,具体计算见公式(9)。
D e p t h =   m a x i ϵ Γ i l i - 1                    公式 9
其中, Γ ( i )为引用主题 i中所含专利的施引专利集合, l i以该主题为起点的最长路径所含节点数。
(5)扩散地域。扩散地域指标反映主题在不同地域空间的分布特征,揭示其地域差异性。本文从主题下专利的同族专利家族数和扩散国家的分布情况两方面进行分析,了解主题在扩散地域上的区别和联系。

3.4.2 生命周期视角下主题扩散分析

专利文献是技术信息的主要载体,专利引文网络可以展现技术信息之间错综复杂的知识转移和流动,因此本文基于专利直接引用关系构建引文网络描述主题知识的扩散过程。节点代表专利,边代表引用关系,箭头从被引专利指向施引专利,箭头方向即为扩散方向。
在时间维度分析上,运用技术生命周期理论进行时间划分;针对划分的每个时间段,分别计算上述主题扩散指标,以此量化分析主题在不同技术发展时期的扩散情况和影响范围。通过纵向时序对比和横向主题对比,动态揭示主题扩散的机理和规律特点。

3 实证分析/Empirical analysis

核聚变技术因其颠覆性潜力、商业化进程加速和多国竞争布局,未来有希望彻底解决世界面临的能源困境。因此,本文选取核聚变技术领域作为实证对象,进行新兴主题的识别和扩散研究。

3.1 数据收集和预处理

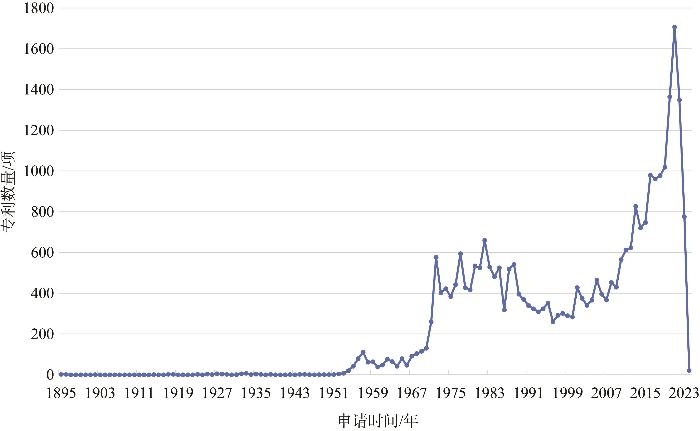
从Incopat数据库中以(TIAB=("nuclear fusion" OR "magnetic confinement fusion" OR "inertial confinement fusion" OR "magnetic inertial fusion" OR "fusion plasma" OR "tokamak" OR "Stellarator" OR "magnetic mirrors" OR "θ-pinch" OR "fusion reaction" OR "thermonuclear fusion" OR "cold fusion" OR 核聚变 OR 磁约束聚变 OR 聚变等离子体 OR 惯性约束聚变 OR 磁惯性聚变 OR 托卡马克 OR 仿星器 OR 磁镜 OR 箍缩) NOT ("nuclear fission" OR "uranium")) OR IPC=(G21B) OR CPC=(Y02E30/10)为检索式对核聚变技术专利数据及其施引数据进行检索,依据图2专利数据库全时间段总体申请分布情况和专利的时滞性,将检索时间限制在1955—2024年,采集时间为2025年4月2日;同时,为避免不同类型专利引用的复杂性,将专利类型限定为申请和授权,检索得到30 129条专利。经过简单同族合并,剔除重复无关数据和属性缺失数据后,最终得到有效专利12 781项[25]。
图2 核聚变技术专利申请分布

Figure 2 Distribution map of patent applications for nuclear fusion technology

为满足传统主题模型和LLMs对语料库的需求,本文对专利数据进行针对性预处理。在传统主题模型部分,构建领域术语词典和停用词表,对专利的标题和摘要字段进行去停用词、去除标点符号、词形还原等操作,得到传统主题模型语料库。在LLMs部分,选取专利的标题和摘要字段进行统一标准化处理,得到LLMs语料库。

3.2 主题建模结果

为深入比较不同主题识别方法在语料中的效果,使用传统主题模型对传统主题语料库进行主题挖掘,结果见表1、表2;使用LLMs对大语言模型语料库进行主题挖掘,结果见表3;综合使用传统主题模型和LLMs进行主题挖掘,结果见表4;各模型识别的主题数见表5。同时,为确保不同主题建模方法识别的可解释性和一致性,对主题命名采用统一规范,各主题名称均基于该主题下专利文本中的Top10高频关键词进行生成,命名结构主要为核心技术对象+技术特征/应用场景/功能目标。其中,传统主题模型采用人工归纳方式参照领域学术规范完成主题命名,其他涉及LLMs的方法则通过构建统一的提示词模板,引导模型基于Top10关键词自动生成主题名称。
表1 LDA模型识别的主题(部分)

Table 1 Topics recognized by the LDA model (part)

主题号 主题名称 关键词
Topic 0 核聚变材料 material, metal, hydrogen, process, film, reaction, temperature, powder, isotope, fusion
Topic 1 磁约束聚变磁场系统 magnetic, field, coil, plasma, toroidal, system, magnet, region, chamber, confinement
…… …… ……
Topic 16 偏滤器电极结构 plate, electrode, surface, metal, structure, hole, cavity, body, upper, lower
表2 BERTopic模型识别的主题(部分)

Table 2 Topics recognized by BERTopic model (part)

主题号 主题名称 关键词
Topic 0 核聚变反应堆技术 plasma, beam, fusion, coil, source, neutron, chamber, reactor, cooling, generator
Topic 1 托卡马克核聚变装置 filing, fusion, reactor, plasma, tokamak, coil, blanket, unit, ferromagnetic, toroidal
…… …… ……
Topic 18 氢同位素催化电解技术 grid, housing, nonconductive, electrolyte, inlet, catalytic, hydride, hydrogen, microspheres, plated
表3 DeepSeek模型识别的主题(部分)

Table 3 Topics recognized by DeepSeek model (part)

主题号 主题名称 关键词
Topic 0 磁约束聚变装置 tokamak, magnetic confinement, stellarator, tokamak device, magnetic mirror, poloidal magnetic field, toroidal magnetic field, magnetic confinement fusion device, magnetic field configuration, field reversed configuration
Topic 1 惯性约束聚变技术 inertial confinement fusion, laser inertial confinement fusion, laser fusion, inertial confinement fusion (icf), fuel pellet, laser beams, target material, implosion, icf targets, laser-driven implosion
…… …… ……
Topic 15 磁流体动力学与约束 magnetohydrodynamics, plasma equilibrium, magnetic reconnection, plasma compression, mhd generator, plasma acceleration, magnetic flux compression, plasma pressure, azimuthal magnetic field, magnetic pinch
表4 BERTopic+Doubao识别的主题(部分)

Table 4 Topics recognized by BERTopic+Doubao model (part)

主题号 主题名称 关键词
Topic 0 核聚变等离子体反应 nuclear fusion, plasma reaction, hydrogen, ion, magnetic reactor, energy, power
Topic 1 激光光学系统装置 mirror, optical, laser, galvano, light, lens, beam, device, image, system
…… …… ……
Topic 24 等离子体位形控制 controller, position, plasma, current, drive, control, vertical, instability, method, shape
表5 各主题模型识别的主题数

Table 5 The number of topics recognized by each topic model

主题识别模型 主题数/个 主题识别模型 主题数/个
LDA 17 LDA+Doubao 23
BERTopic 19 LDA+GPT 24
DeepSeek 16 LDA+ Llama 25
Doubao 16 BERTopic+DeepSeek 23
GPT 14 BERTopic+Doubao 25
Llama 14 BERTopic+GPT 16
LDA+DeepSeek 21 BERTopic+ Llama 16
通过分析上述方法在主题识别任务的表现,观察发现使用传统主题模型具有较强的结构化文本处理能力,但主题表示因依赖人工方式具有主观性,效果相对较弱。使用LLMs依托其强大的语言理解和生成能力,能够抽取出更连贯和具代表性的词语,能够捕捉词语间的复杂关系,使词间关联更紧密、语义更清晰,但也存在处理数据量受限的问题,当数据量过大时,无法一次生成全部结果。传统主题模型和LLMs结合在一定程度上能够改善上述两者存在的问题,既能抽取较具代表性且语义清晰的词语,又能结构化处理文本,提高主题识别效率。
不同主题建模方法下的主题数差异是方法异质性的必然结果,即算法原理和模型结构假设的直接体现,而非随机波动。LDA依赖于词袋模型和多项分布假设,无法刻画长距离语义关联,易出现主题交叉、边界模糊等问题;BERTopic往往忽视主题内部的概率结构约束,易出现主题合并和粒度不稳定问题;GPT因安全对齐机制,对技术术语生成保守;Llama指令遵循能力较弱,导致单主题模型生成的主题数相对较少。模型结合的方法通过平衡传统主题模型的结构约束和LLMs的语义细分能力,使其主题数普遍得到提升。

3.3 新兴主题识别

首先,根据主题—文档矩阵以及公式(1)—(4)计算主题的新颖性、连续性、增长度和影响力指标的原始得分;其次,对计算得到的指标值进行标准化处理和CRITIC法计算指标权重,得到各主题的新兴主题综合指数;最后,选取综合指数Top25%的主题作为新兴主题,部分模型确定的新兴主题见表6。
表6 部分主题模型识别的核聚变技术新兴主题

Table 6 Some emerging themes of nuclear fusion technology identified by the theme model

模型 主题号 主题名称 综合得分
LDA 10 脉冲激光聚变系统 0.657 9
11 核聚变粒子束反应 0.621 8
0 核聚变材料 0.486 0
14 磁场探针测量技术 0.471 0
BERTopic 5 核聚变装置机械结构 0.804 9
6 超声空化冷却技术 0.676 1
4 惯性约束靶材微球 0.601 5
8 聚变复合材料改性技术 0.595 9
DeepSeek 16 磁流体动力学与约束 0.595 2
13 聚变反应堆设计 0.496 5
11 低温核聚变技术 0.479 3
9 中子产生与屏蔽技术 0.457 5

BERTopic

+DB

14 核聚变真空容器 0.779 0
12 冷原子磁光阱技术 0.706 4
8 场反位形约束系统 0.639 5
4 超导磁体线圈技术 0.596 5
11 惯性约束成像检测系统 0.594 5
6 微波核聚变系统 0.580 1

3.4 主题建模效果评估

3.4.1 模型选择和领域知识库构建

在大语言模型的选择上,Qwen3系列是通义千问最新推出的大语言模型,在推理能力、指令遵循和多语言支持方面实现突破性进展。其中,Qwen3-235B-A22B作为旗舰级大语言模型,通过MoE架构显著提高了计算效率,对复杂语义和长距离依赖关系的捕捉能力突出,成为目前市场上最具性价比的超大规模模型之一。因此,本文选取Qwen3-235B-A22B为RAG的基座模型。
在外部知识库的构建上,使用“核聚变+发展趋势/研究现状”等关键词,检索策略兼顾中英文关键词,从Web of Science的SCI、SSCI和CNKI等数据库获取核聚变领域近3—5年的研究综述,从国际原子能机构、聚变行业协会、国际热核聚变实验堆计划、美国能源部、德国卡尔斯鲁厄理工学院等政府和权威机构网站获取核聚变领域近3—5年的公开政策和技术报告,对检索结果进行初步筛选,去除重复、无关以及低质量的内容,最终得到用于构建外部知识库的语料约计100余篇,覆盖核聚变领域的主流研究方向和最新研究进展。

3.4.2 检索增强生成实验

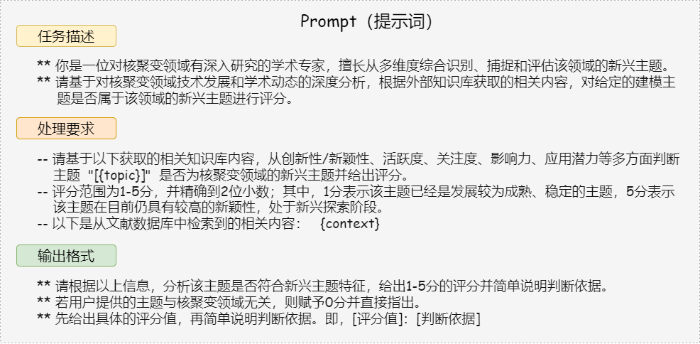
首先,对语料进行分割。根据文本语言和字符的区别,对中英文文本分别设置合适的分割片段长度和重叠字符数,使中英文分割后文本包含信息量相近,确保关键信息不会因分割而丢失。其次,选择paraphrase-multilingual-minilm-l12-v2为嵌入模型,将文本转换为向量并存储在Faiss向量数据库中;同时,使用IndexFlatL2进行精确检索,获取相似度值Top10的文本。再次,使用ms-marco-MiniLM-L12-v2交叉编码器对检索结果进行重排序,返回Top5最相关的文本,作为上下文信息进行最终的提示词生成。然后,构建提示词对主题建模方法识别的主题效果进行评分,具体提示词如图3所示。最后,对评估结果进行专家人工复核,检查是否存在明显偏离核聚变技术发展脉络或领域共识的极端评分,修正明显不合理评分,确保评估结果的准确性。
图3 提示词框架

Figure 3 Prompt word framework

3.4.3 效果评估对比分析

根据上述最终生成的评分值,降序排列后同样选取Top25%的主题作为新兴主题,以LLMs识别的新兴主题为基准,综合使用精确率、召回率和F1值作为评估指标,对各主题建模方法识别主题的效果进行评估,对比分析确定最优的主题建模方法,具体结果见表7。
表7 各主题模型识别主题的效果分析

Table 7 Analysis of the effect of each theme model in identifying themes

建模方法 精确率 召回率 F1
LDA 0.250 0 0.250 0 0.250 0
BERTopic 0.250 0 0.250 0 0.250 0
DeepSeek-R1 0.250 0 0.250 0 0.250 0
Doubao-1.5-pro-32k 0.500 0 0.500 0 0.500 0
GPT-o3-mini 0.250 0 0.250 0 0.250 0
Llama3.1-405B-Instruct-FP8 0.333 3 0.333 3 0.333 3
LDA+DeepSeek 0.250 0 0.250 0 0.250 0
LDA+Doubao 0.400 0 0.400 0 0.400 0
LDA+GPT 0.500 0 0.500 0 0.500 0
LDA+Llama 0.333 3 0.333 3 0.333 3
BERTopic+DeepSeek 0.600 0 0.600 0 0.600 0
BERTopic+Doubao 0.833 3 0.833 3 0.833 3
BERTopic+GPT 0.250 0 0.250 0 0.250 0
BERTopic+Llama 0.500 0 0.500 0 0.500 0
根据计算结果得知,在新兴主题识别任务中,BERTopic+Doubao的主题建模方法效果最佳,但是新兴主题的小样本量使得评估结果天然具有较高的波动性,导致最终整体评分普遍偏低。传统主题模型和LLMs之间的表现存在差异,单一LLMs和两者结合模型的性能也存在差异,这些差异与模型的训练策略和模型架构存在密切的关系,下面对结果进行具体分析。
对比传统主题模型和LLMs,发现LLMs在F1均值上显著高于传统主题模型。传统主题模型的F1均值为0.25、单一LLMs的F1均值为0.333 3,较传统主题模型提升33.3%、LDA+LLMs的F1均值为0.370 8、BERTopic+LLMs的F1均值为0.545 8,LLMs相比传统主题模型性能取得显著提升;在两者结合模型中,F1均值为0.440 9,较单一LLMs提升32.3%,说明LDA或BERTopic均能让LLMs的性能得到提升,BERTopic的提升效果更明显。对比单一LLMs和两者结合模型,在单一LLMs和BERTopic+LLMs中,Doubao的效果最佳,可能与其支持长程依赖建模、使用自研数据训练和背靠字节跳动的海量数据有关。而LDA+Doubao的性能下降,可能因LDA的主题概率分布与Doubao的神经网络输出存在冲突,导致集成负优化;BERTopic+GPT相对LDA+GPT不升反降,可能因GPT与BERTopic的语义表示体系存在差异而出现“语义偏移”,导致GPT无法准确理解BERTopic提取的主题核心。
综上所述,在新兴主题识别任务中,基于BERTopic+Doubao的主题建模效果最佳。模型结合在一定程度上能互补优势,即传统主题模型提供结构约束,LLMs增强语义灵活性,但是模型结合的效果依赖于LLMs和传统主题模型的兼容性,若兼容性较差可能不如单独使用LLMs性能更优。

3.5 新兴主题和非新兴主题的扩散分析

本文从最优主题建模结果中分别选取“超导磁体线圈技术”新兴主题和“氢等离子体聚变技术”非新兴主题为例进行主题扩散分析。

3.5.1 构建专利引文网络

首先,获取主题下的专利及其施引专利,专利的申请和公开之间存在时滞,因此2024年数据仅作参考,不参与扩散指标计算。其次,剔除部分施引专利申请时间早于被引专利的引用对、施引专利的申请日和IPC为空的数据。最后,将专利的引用延时赋值为边权,生成一个有向加权的专利引文网络。

3.5.2 技术生命周期法划分时段

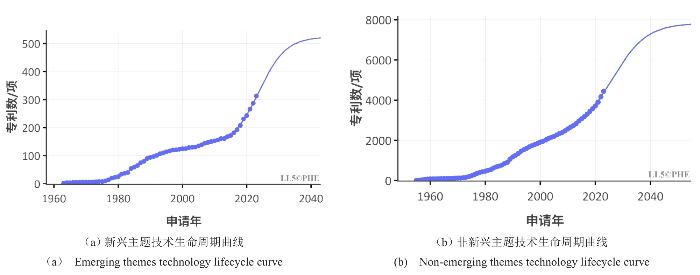
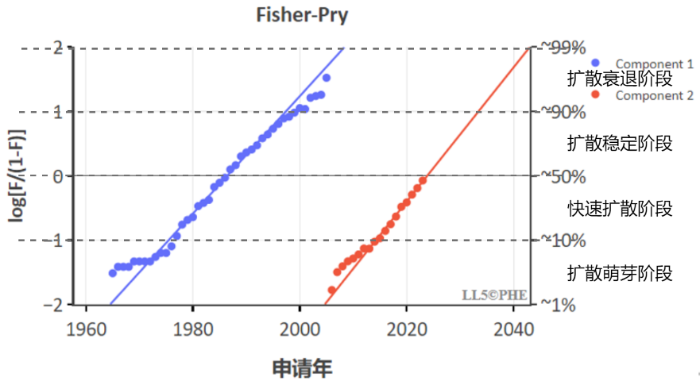
运用Loglet Lab 5.0软件自动确定参数以拟合技术生命周期各阶段的分界点,进行时间段的划分。通过Logistic模型对主题专利申请数量时间序列进行拟合,新兴主题和非新兴主题的技术生命周期拟合曲线如图4所示。依据Fisher-Pry模型的饱和率阈值理论对主题的时间段进行划分,具体情况如图5所示。新兴主题的时间段划分为:1963—1976、1977—1986、1987—1999、2000—2006、2007—2014、2015—2023,非新兴主题的时间段划分为:1955—1974、1975—1990、1991—2007、2008—2023。
图4 新兴主题和非新兴主题技术生命周期曲线

Figure 4 The technology life cycle curves of emerging and non-emerging themes

图5 主题时间段划分标准

Figure 5 Standard for dividing theme time periods

3.5.3 主题扩散情况对比分析

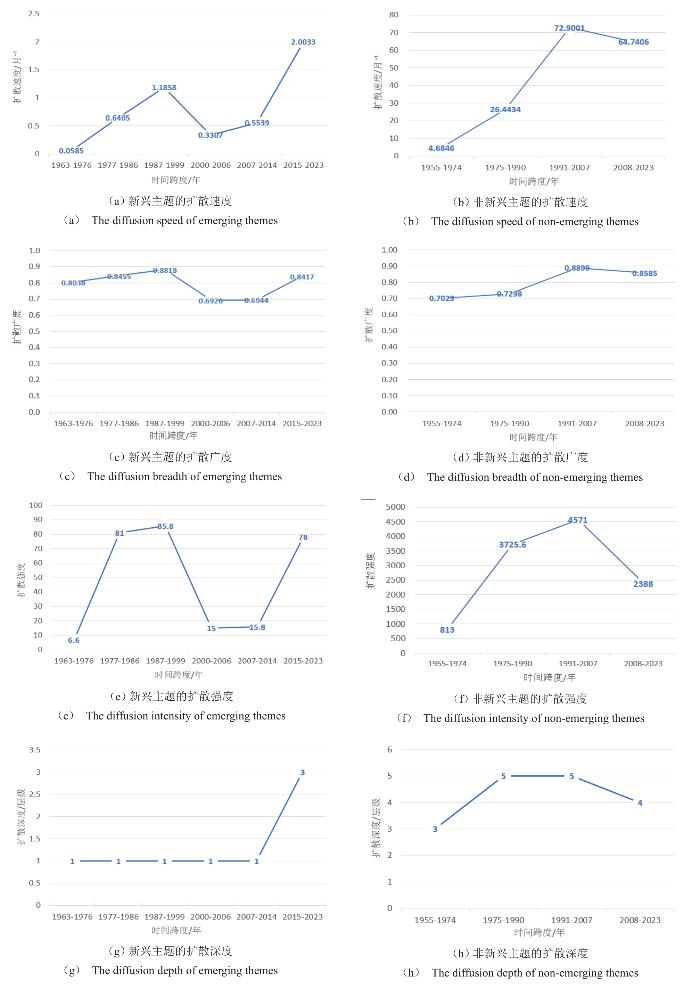
根据上述时间段划分,分析新兴主题和非新兴主题在各维度上扩散的变化情况,具体见图6和图7。综合分析发现在扩散速度、广度和强度上,新兴主题均呈现波动上升的趋势,而非新兴主题则呈现先稳步上升后小幅下降的趋势,下面对各主题的具体扩散情况进行分析。
图6 新兴主题和非新兴主题的扩散情况

Figure 6 The diffusion of emerging and non-emerging themes

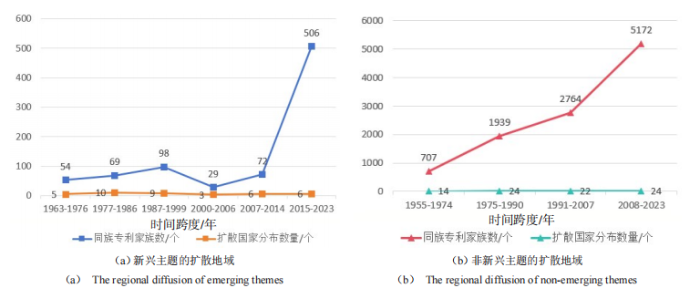
图7 新兴主题和非新兴主题的扩散地域情况

Figure 7 The regional diffusion of emerging and non-emerging themes

在扩散速度、广度和强度上,超导磁体线圈技术在早期扩散程度较低,因为该技术尚处于理论探索和实验研究的萌芽阶段,涉及复杂的材料科学和低温物理等领域,研发难度大,关注和认知程度低;随着相关理念和技术逐渐成熟,超导材料的性能逐步提升,扩散程度得到提升,但整体仍处于较低水平;随后受全球经济形势、关注度下降等外部因素和自身研发瓶颈等内部因素的影响,研发进度受阻,进而影响扩散情况;后期扩散呈爆发式增长趋势,得益于第二代高温超导带材产业化[23]、全超导磁体制造[24]等进展的突破。氢等离子体聚变技术在初期就处于相对较高的水平,但目前仅在少数机构间流动,扩散广度相对较低;后续持续快速增长,国际上一些大型装置逐渐建成,推动全球合作和技术传播共享;近期扩散水平有所下降,在技术上面临工业化瓶颈,在经济上2008年金融危机使得各国政府缩减基础科研预算,同时光伏风电等可再生能源成本下降,最终使得扩散呈现下降趋势。在扩散深度上,新兴主题在前期的扩散深度为1,说明其专利集中在基础研究和核心原理层面,技术体系尚未成熟,没有催生出新的、影响深远的技术,近期得到提升可能是与某些领域学科实现了交叉融合。而非新兴主题在早期的扩散深度就高于新兴主题,说明非新兴主题在发展过程中一直是学术界和企业界关注的重点,扩散深度产生波动可能是受到技术发展、国际合作等方面的影响。在扩散地域上,超导磁体线圈技术的同族专利家族数和扩散国家分布同样呈现波动上升的趋势,在2015—2023年同族专利家族数已经增加到506个,说明超导磁体线圈技术的重要性逐渐提高,其扩散国家主要分布在亚洲地区,但在2000—2006年间扩散国家分布急剧减少,与扩散广度等的变化趋势一致,本质上仍是受技术发展、社会经济等因素的影响。而氢等离子体聚变技术的同族专利家族数在初期就已达到较高水平,且后续时间内稳步增长,持续受到各国关注。分析发现,其扩散国家集中分布在欧洲、亚洲和大洋洲,非洲国家主要是以非洲区域知识产权组织的形式存在,该技术的扩散范围已经覆盖全球绝大部分地区,取得较为成熟的发展。
综上所述,新兴主题相较于非新兴主题,呈现波动上升的扩散趋势,主要原因是新兴主题早期未得到研究人员的广泛关注,需要时间来打破认知壁垒、建立市场信任,后期随着认知程度的提升,扩散指标得到大幅提升。而非新兴主题从初期就呈现稳步上升的扩散趋势,很大程度上是因为非新兴主题是社会本身就关注的基础学科领域,已经有相对广泛的受众群体和相对完整的理论体系,随着时间的演进,技术稳步进行发展和扩散。

4 结语/Conclusion

本文的创新在于对主题建模和结果评估方法进行改进,传统主题模型和LLMs优势互补实现主题建模,将RAG系统地引入新兴主题识别的评估环节;同时设计扩散深度和地域指标拓展主题扩散分析范围。以核聚变领域为实证对象,验证了研究框架的可行性与有效性,结果发现基于BERTopic+Doubao的主题建模方法效果最佳;同时分析得出新兴主题需要经历从“冷启动”到“热传播”的爬坡过程,扩散多呈现波动上升的趋势,非新兴主题则是在长期积累基础上的持续扩散,反映了新兴主题和非新兴主题扩散的本质差别,为后续新兴主题的识别和扩散分析提供参考。
但本文仍存在一些不足:①在进行主题建模效果评估时,采用基于RAG微调的大语言模型,虽然通过外部知识一致性和人工复核降低了主观偏差,但仍属于一种“弱监督”评估方式,未来可进一步引入多位领域专家的双盲标注结果,以提升方法的权威性;②采用简单RAG方法虽然能迅速响应结果,但当查询涉及复杂语境或需要多轮推理时,直接拼接的信息可能不够充分,容易遗漏细节,未来可尝试改进RAG方法;③仅采用专利的标题和摘要文本数据,数据源较为单一,未来可尝试多源数据或全文本数据进行分析;④仅以核聚变技术领域作为实证对象对本文方法进行验证,尚未在多个技术领域开展实证复现,未来可在其他技术领域进行跨领域对比实验,以进一步系统验证方法的泛化能力。
[1]
何多魁, 唐中君, 陈倩倩, 等. 微调大语言模型驱动的短文本动态主题建模方法[J]. 数据分析与知识发现, 2025, 9(10): 99-119.

HE D K, TANG Z J, CHEN Q Q, et al. Dynamic topic modelling approach of short text driven by fine-tuned large language model[J]. Data analysis and knowledge discovery, 2025, 9(10): 99-119.

[2]
邱均平, 胡博, 徐中阳, 等. 基于DTM模型的国内外话语权研究主题挖掘及比较分析[J]. 情报理论与实践, 2023, 46(2): 24-34.

QIU J P, HU B, XU Z Y, et al. Topic mining and comparative analysis of discourse power research in China and overseas based on DTM model[J]. Information studies: theory & application, 2023, 46(2): 24-34.

[3]
阮光册, 周萌葳. 基于Sentence-BERT的专利技术主题聚类研究——以人工智能领域为例[J]. 情报杂志, 2024, 43(02): 110-117.

RUAN G C, ZHOU M W. Research on patent technology subject clustering based on Sentence-BERT: taking the field of artificial intelligence as an example[J]. Journal of intelligence, 2024, 43(02): 110-117.

[4]
WANG H, PRAKASH N, HOANG N K, et al. Prompting large language models for topic modeling[C]// 2023 IEEE international conference on big data (BigData). Sorrento: IEEE, 2023: 1236-1241.

[5]
陈亮, 张静, 张海超, 等. 层次主题模型在技术演化分析上的应用研究[J]. 图书情报工作, 2017, 61(5): 103-108.

CHEN L, ZHANG J, ZHANG H C, et al. Application of hierarchical topic model on technological evolution analysis [J]. Library and information service, 2017, 61(5): 103-108.

[6]
唐嘉, 庞大崴, 刘书铭, 等. 大语言模型微调训练与检索增强生成技术在油气企业制度问答应用中的效果对比研究[J]. 数字通信世界, 2024(11): 104-106.

TANG J, PANG D W, LIU S M, et al. A Comparative study on the effects of fine-tuning training and retrieval enhancement generation technology for large language models in the application of institutional question answering in oil and gas enterprises[J]. Digital communication world, 2024(11): 104-106.

[7]
吴文旷, 周相广, 高国忠, 等. 基于检索增强生成和微调技术的大语言模型在勘探开发行业的应用初探[C]//西安石油大学, 陕西省石油学会. 2024油气田勘探与开发国际会议论文集Ⅰ. 中国石油勘探开发研究院信息中心, 长江大学地球物理与石油资源学院, 2024: 726-733.

WU W K, ZHOU X G, GAO G Z, et al. A preliminary study on the application of large language models based on retrieval enhancement generation and fine-tuning technology in the exploration and development industry [C]// Xi'an Shiyou University, Shaanxi Petroleum Society. Proceedings of the 2024 international conference on oil and gas field exploration and development I. Xi'an: Information Center of Research Institute of Petroleum Exploration and Development, China National Petroleum Corporation School of Geophysics and Petroleum Resources, Yangtze University, 2024: 726-733.

[8]
ROGERS E M. Diffusion of innovations[M]. 3rd ed. New York: The Free Press, 1983.

[9]
何郁冰, 林欣慧. 基于复杂网络演化博弈的颠覆性技术扩散研究[J]. 软科学, 2024, 38(6): 28-36.

HE Y B, LIN X H. Research on disruptive technology diffusion based on complex network evolutionary game[J]. Soft science, 2024, 38(6): 28-36.

[10]
段尧清, 尚婷, 周密. 我国政务大数据政策扩散特征与主题分析[J]. 图书情报工作, 2020, 64(13): 133-139.

DUAN Y Q, SHANG T, ZHOU M. Analysis on the characteristics and subjects of China's government big data policy diffusion[J]. Library and information service, 2020, 64(13): 133-139.

[11]
王曰芬, 王柳虹, 巴志超, 等. 政府科技新闻中科技成果转化的主题识别与时空扩散分析[J]. 情报学报, 2023, 42(8): 939-951.

WANG Y F, WANG L H, BA Z C, et al. Spatiotemporal diffusion analysis of achievement transformation topics in government science and technology news[J]. Journal of the China Society for Scientific and Technical Information, 2023, 42(8): 939-951.

[12]
张涛, 张博雅, 马海群. 我国央地政府数据安全政策扩散特征及主题转移研究[J]. 情报理论与实践, 2025, 48(5): 118-127, 137.

ZHANG T, ZHANG B Y, MA H Q. Research on the diffusion characteristics and topic transfer of data security policies of China's central and local governments [J]. Information studies: theory & application, 2025, 48(5): 118-127, 137.

[13]
李冰, 丁堃, 孙晓玲, 等. 科学论文向技术领域扩散的扩散速度与扩散效果研究[J]. 情报理论与实践, 2024, 47(7): 35-47.

LI B, DING K, SUN X L, et al. Research on the diffusion speed and diffusion effects of scientific papers into the technological domain[J]. Information studies: theory & application, 2024, 47(7): 35-47.

[14]
王丽, 刘细文. 基于专利数据的技术主题扩散量化研究与实现[J]. 数据分析与知识发现, 2022, 6(6): 1-10.

WANG L, LIU X W. Measuring diffusion of technology topics with patent data[J]. Data analysis and knowledge discovery, 2022, 6(6): 1-10.

[15]
汪大锟, 化柏林. 基于BERTopic的新兴技术主题识别研究[J]. 科技情报研究, 2025, 7(1): 131-140.

WANG D K, HUA B L. Research on emerging technology topic identification based on BERTopic[J]. Scientific information research, 2025, 7(1): 131-140.

[16]
张凯, 吕璐成, 韩涛, 等. “论文—专利”关联视角下的新兴技术识别研究[J]. 情报理论与实践, 2024, 47(09): 183-191.

ZHANG K, LV L C, HAN T, et al. Research on emerging technology identification from the perspective of “paper-patent” correlation [J]. Information studies: theory & application, 2024, 47(09): 183-191.

[17]
曹琨, 吴新年, 靳军宝, 等. 基于共词和Node2Vec表示学习的新兴技术识别方法[J]. 数据分析与知识发现, 2023, 7(9): 89-99.

CAO K, WU X N, JIN J B, et al. Identification of emerging technology based on co-words and Node2Vec representation learning [J]. Data analysis and knowledge discovery, 2023, 7(9): 89-99.

[18]
陈稳, 陈伟. 科学与技术对比视角下的前沿主题识别与演化分析[J]. 情报杂志, 2022, 41(1): 67-73, 163.

CHEN W, CHEN W. The identification and evolution of research frontiers from comparison of science and technology [J]. Journal of intelligence, 2022, 41(1): 67-73, 163.

[19]
贵淑婷, 彭爱东. 基于专利引文网络的技术扩散速度研究[J]. 情报理论与实践, 2016, 39(5): 40-45.

GUI S T, PENG A D. Research on the speed of technology diffusion based on patent citation network[J]. Information studies: theory & application, 2016, 39(5): 40-45.

[20]
ALBUQUERQUE E D M E, BRITTO J N D P, RIBEIRO L C, et al. Patent citations, knowledge flows, and catching-up: evidences of different national experiences for the period 1982-2006[J]. Science and public policy, 2020(7): 1-14.

[21]
侯剑华, 杨秀财, 姚海玥. 伯乐型专利的识别及其特征研究[J]. 图书情报工作, 2024, 68(6): 104-118.

HOU J H, YANG X C, YAO H Y. Identification and characterization of bó lè patents [J]. Library and information service, 2024, 68(6): 104-118.

[22]
陈祥, 冯佳, 穆晓敏, 等. 技术知识扩散视角下核心专利识别方法研究[J]. 情报理论与实践, 2022, 45(10): 132-138.

CHEN X, FENG J, MU X M, et al. Study of identification of core patent in the perspective of diffusion of technology knowledge [J]. Information studies: theory & application, 2022, 45(10): 132-138.

[23]
阎伟华, 蔡传兵, 周迪帆. 基于第二代高温超导带材的磁体研究进展与挑战[J]. 物理, 2019, 48(11): 733-748.

YAN W H, CAI C B, ZHOU D F. Progress and challenges in the development of magnets based on second-generation high-temperature superconducting tapes[J]. Physics, 2019, 48(11): 733-748.

[24]
李洁, 刘宜平, 史越, 等. 标准化助力第二代高温超导带材产业化[J]. 中国标准化, 2021(S1): 87-93.

LI J, LIU Y P, SHI Y, et al. Standardization supports the industrialization of the second-generation high temperature superconducting taps[J]. China standardization, 2021(S1): 87-93.

[25]
唐昕宇. 核聚变技术领域1955-2024年专利数据集[DS/OL]. Science Data Bank. 知识管理论坛. [2025-12-16].

DOI:10.57760/sciencedb.j00074.00155. TANG X Y. Patent dataset in the field of nuclear fusion technology from 1955 to 2024[DS/OL]. Science Data Bank. Knowledge management forum [2025-12-16]. DOI:10.57760/sciencedb.j00074.00155 .

文章导航

/

〈 〉