AI赋能知识管理与服务的拓荒探索专题

AI赋能重大科技基础设施科学知识图谱构建与个性化推荐研究进展与展望

  • 张玲玲 1, 2, 3 ,
  • 张悦羚 1 ,
  • 许尚冲 1 ,
  • 韩佳沂 1 ,
  • 杨振 , 4, 5
展开
  • 1. 中国科学院大学经济与管理学院 北京 100190
  • 2. 中国科学院大数据挖掘与知识管理重点实验室 北京 100190
  • 3. 中国科学院大学数字经济监测预测预警与政策仿真教育部哲学社会科学实验室(培育) 北京 100190
  • 4. 散裂中子源科学中心 东莞 523803
  • 5. 中国科学院高能物理研究所 北京 100049

作者贡献声明 /Author contributions:

张玲玲:选题确立,核心观点把握,撰文指导;

张悦羚:文章撰写,主体内容撰写修改;

许尚冲:文献调研;

韩佳沂:文献调研;

杨 振:选题确立,核心观点把握,撰文指导。

杨振,高级工程师,E-mail: 。

张玲玲,教授,博士生导师

张悦羚,博士研究生

许尚冲,硕士研究生

韩佳沂,博士研究生

收稿日期: 2025-12-22

  网络出版日期: 2026-02-28

基金资助

国家自然科学基金“基于知识图谱和链路预测的推荐系统及在设备健康管理中的应用研究”(72071194)

AI-Enabled Scientific Data and Knowledge Management for Large-Scale Research Infrastructures

  • Zhang Lingling 1, 2, 3 ,
  • Zhang Yueling 1 ,
  • Xu Shangchong 1 ,
  • Han Jiayi 1 ,
  • Yang Zhen , 4, 5
Expand
  • 1. School of Economics and Management, University of Chinese Academy of Sciences, Beijing 100190
  • 2. Key Laboratory of Big Data Mining and Knowledge Management, Chinese Academy of Sciences, Beijing 100190
  • 3. Ministry of Education Philosophy and Social Sciences Laboratory of Digital Economy Monitoring, Forecasting, Early Warning, and Policy Simulation (under cultivation), University of Chinese Academy of Sciences, Beijing 100190
  • 4. Spallation Neutron Source Science Center, Dongguan 523803
  • 5. Institute of High Energy Physics, Chinese Academy of Sciences, Beijing 100049
Yang Zhen, Senior Engineer, E-mail: .

Zhang Lingling, Professor, Doctoral Supervisor

Zhang Yueling, Doctoral Candidate

Xu Shangchong, Master's Candidate

Han Jiayi, Doctoral Candidate

Received date: 2025-12-22

  Online published: 2026-02-28

Supported by

National Natural Science Foundation of China "Research on Recommendation Systems Based on Knowledge Graphs and Link Prediction and Their Application in Equipment Health Management"(72071194)

摘要

【目的/意义】 研究基于人工智能技术构建重大科技基础设施科学数据管理与推荐框架的方法,重点探讨融合知识图谱与大语言模型的个性化推荐系统架构,以提升科学数据的整合与智能推荐能力。 【方法/过程】 提出一种基于人工智能技术的重大科技基础设施科学数据管理与推荐框架,引入知识图谱、链路预测和大语言模型(Large Language Models,LLMs, LLMs)技术,提出面向科研全流程的个性化数据推荐系统架构。 【结果/结论】 系统架构包括数据采集、知识抽取、语义推理、个性化推荐等模块。数据层负责多源异构数据的整理和整合,分析层通过图神经网络与大语言模型进行深度分析,应用层则为科研人员提供精准的推荐服务。所提出的框架有助于提高数据的利用率,促进科技创新能力的提升,提高多源异构数据的整合与智能推荐能力。
本文引用格式

张玲玲 , 张悦羚 , 许尚冲 , 韩佳沂 , 杨振 . AI赋能重大科技基础设施科学知识图谱构建与个性化推荐研究进展与展望[J]. 知识管理论坛, 2026 , 11(1) : 40 -49 . DOI: 10.13266/j.issn.2095-5472.2026.004

Abstract

[Purpose/Significance] Large-scale research infrastructures represent a symbol of national scientific competitiveness, and the scientific data they generate play a crucial role in scientific research, technological advancement, and economic development. However, traditional data management methods face challenges such as data redundancy, difficulties in sharing, and repetitive experiments, urgently requiring empowerment through next-generation artificial intelligence technologies. This paper aims to study a method for constructing an AI-enabled scientific data management and recommendation framework for large-scale research infrastructures, focusing on exploring a personalized recommendation system architecture that integrates knowledge graphs and large language models to enhance the integration and intelligent recommendation capabilities of scientific data. [Method/Process] This paper proposed an artificial intelligence-based framework for scientific data management and recommendation for large-scale research infrastructures. It introduced technologies such as knowledge graphs, link prediction, and large language models (LLMs), proposing a personalized data recommendation system architecture oriented towards the entire research process. [Result/Conclusion] The system architecture includes modules for data collection, knowledge extraction, semantic reasoning, and personalized recommendation. The data layer is responsible for the organization and integration of multi-source heterogeneous data, the analysis layer performs in-depth analysis using graph neural networks and large language models, and the application layer provides accurate recommendation services to researchers. The framework proposed in this paper contributes to improving data utilization, promoting scientific and technological innovation capabilities, and enhancing the integration and intelligent recommendation of multi-source heterogeneous data.

1 引言/Introduction

重大科技基础设施(又称大科学工程、大科学装置)是国家综合科技实力的象征,是发展科技力量、培育源头创新的关键战略举措之一[1]。随着科技不断进步,重大科技基础设施在提供极限的研究手段、支撑技术创新、产业发展和提升国家科技竞争力方面的作用愈加凸显。自2011年以来,我国依托重大科技基础设施取得显著成果:9项获国家自然科学奖,3项获国家技术发明奖,10项获国家科学技术进步奖。“十四五”规划明确提出建设重大科技创新平台,适度超前布局国家重大科技基础设施,提高共享水平和使用效率。截至2023年底,我国已布局77个重大科技基础设施,其中在建和运行的达57个,进入全球“第一方阵”[2]。随着重大科技基础设施逐步投入运行,如何提高运行效率、高效产出科研成果,成为亟待解决的核心问题。
科学数据作为重大科技基础设施运行的重要产出和科技资源中最基本、最活跃的部分,既是科技创新活动的重要产出,也是新一轮创新活动和经济社会发展的重要基础,具有巨大的应用和开发价值,在全球诸多国家机构中受到高度重视[3]。目前,多个国家和地区已围绕重大科技基础设施的数据资源展开系统部署。例如,欧盟构建欧洲开放科学云(European Open Science Cloud,EOSC),美国国家航空航天局(National Aeronautics and Space Administration,NASA)和国家海洋和大气管理局(National Oceanic and Atmospheric Administration,NOAA)设立数据中心,着力推进科研数据平台建设;欧盟科研网络(Gigabit European Academic Network,GÉANT)、日本高速科研网络(Science Information NETwork 5,SINET5)等则强化科学数据的网络支撑;欧盟进一步投资建设高性能计算与数据基础设施,推动科研大数据的智能化分析,并通过推行“FAIR数据原则”(findable, accessible, interoperable, reusable)完善科学数据制度体系。
当前,科学研究已全面进入大数据时代。科学研究正从经验科学(第一范式)、理论科学(第二范式)、计算科学(第三范式)、数据密集型科学(第四范式)逐步发展到智能化科研(第五范式),呈现出“大科学、大需求、大数据、大计算、大发现”的特征[4-7]。在此背景下,科学数据正日益成为驱动重大科技突破与原始创新的核心力量。重大科技基础设施产生的科学数据不仅规模庞大、学科交叉性强,更具有显著的生命周期演进性与复杂的逻辑关联性,是贯穿科研全流程、支撑原始创新的核心战略资源。以中国高海拔宇宙线观测站(Large High Altitude Air Shower Observatory,LHAASO)为例,2022年共采集数据11PB,记录宇宙线事例达10万亿个;其数据与计算资源向全球开放,全年数据访问和处理量达448PB,在宇宙线前沿研究方面取得了“PeV超高能光子”“超高质量暗物质寿命”等多项重大科技成果。
然而,受制于传统数据管理机制与技术手段,重大科技基础设施产生的海量数据尚未能转化为高效的创新动力。从数据属性来看,由于缺乏全生命周期的系统性治理,大量数据处于散乱、孤立的状态,导致严重的数据沉积与数据冗余。从科研流程来看,依托设施的研究具有极高的专业门槛与协同难度,研究者常面临科学问题沟通难、实验操作门槛高、科研成果共享滞后等严峻挑战。深层次原因在于,在大科学装置这种高复杂度科研体系中,数据流与知识流之间存在断层:一方面,由于缺乏跨环节的语义关联,科研人员难以从海量异构数据中快速定位核心资源,导致实验重复与资源浪费;另一方面,科研意图在实验过程中具有高度的动态性与隐性特征,传统的被动式数据检索范式已无法适应“AI for Science”背景下的精准科研需求。这些问题限制了科研效率与重大原始创新成果的产出质量。
因此,如何打破数据孤岛,构建一种能够动态感知研究意图、覆盖科研全流程的智能推荐框架,已成为提升重大科技基础设施效能的关键突破口。因此,亟须利用新一代AI实现对传统科学设施的赋能,构建AI for Science的研究范式。建立高效的多源异构数据整合、智能检索和精准推荐机制,从而提高科学数据利用率,提升科技创新能力。
综上,本文从管理科学、系统科学与数据科学的交叉视角出发,提出一个融合知识图谱、链路预测与大语言模型的科学数据推荐框架。面向重大科技基础设施多源异构科学数据,基于人工智能方法建模科学家的研究行为序列,构建动态用户画像与语义驱动的推荐机制,动态感知科学家需求,优化科研资源匹配,提升重大科技基础设施数据的整合效率与推荐精度,构建贯穿科研全流程的个性化链式推荐系统理论框架,为重大科技及基础设施科学数据管理提供理论支持与方法参考。

2 国内外研究进展/ Domestic and international research advances

2.1 重大科技基础设施科学数据管理相关研究进展

学术界将科学数据分为广义科学数据与狭义科学数据。根据《关于印发科学数据管理办法的通知》中有关科学数据的界定,科学数据主要包括在自然科学、工程技术科学等领域,通过基础研究、应用研究、试验开发等产生的数据,以及通过观测监测、考察调查、检验检测等方式取得并用于科学研究活动的原始数据及其衍生数据[8]。
科学数据是科研活动的输入、输出和资产,是证实或者证伪科学发现或科学观点事实、证据或者论证推理的基础,它包括数字化观测、科学监测等来自仪器设备或传感器的数据,计算模拟与模型输出的数据,对情景或现象的描述,对行为的观测或定性描述,以及用于管理或者商业目的的统计数据等[9]。目前科学大数据普遍存在于各个领域的科学研究,尤其在天文学、高能物理、微生物学等大科学领域,科学大数据的应用场景尤为明显。
随着重大科技基础设施的建设推进、重大科学实验的深入开展,以及科学传感器和传感网络的广泛应用,多源、异构、海量的科学数据不断产出积累。这些数据是科研创新的基础,是进行高水平科学研究、推动技术进步和社会发展的重要资源。当前学术界对科学数据的定义与范围已有一定共识,但针对不同科研场景的数据类型和知识属性仍缺乏系统性的细分与管理框架。一般科研数据往往呈现为孤立的观测点或实验记录,而重大科技基础设施数据则是一个紧密耦合的集合体。由于设施具备从建设、运行到科研服务的完整生命周期,其产出的数据并非静态片段,而是贯穿于“科学问题驱动—实验方案设计—仪器运行监测—多维数据产出—成果转化应用”的全链条中。这种全流程的动态演进特性,使得不同环节、不同来源的数据之间存在极强的隐式语义关联。
然而,现有研究多从宏观层面探讨科学数据的共享与价值,对重大科技基础设施这样高复杂度科研体系中数据流的全生命周期管理关注不足。重大科技基础设施科学数据相较于一般意义上的科研数据,具有更显著的系统性与全生命周期关联性。重大科技基础设施所支撑的科研活动通常包括科学问题提出、实验设计与实施、结果分析验证以及科研成果传播共享等阶段。依托大设施的科研流程具有多阶段演进特征,因此其数据呈现出多模态、高维度且深层语义交织的极高复杂度。在实际研究过程中,科研人员的探索意图往往具有动态性与隐性化特征,传统的“拉取式”数据获取方式已难以应对海量异构数据的分析需求。因此,亟须构建个性化的智能推荐机制,通过精准捕捉研究者的实时需求与科研上下文,深度挖掘数据链条中的潜在价值,从而在AI for Science这一新科研范式下,实现科研资源的高效匹配与原始创新的加速产出。
为促进重大科技基础设施在各环节中的知识生成与传递,本文在现有工作的基础上,结合管理科学与知识管理的视角,对重大科技基础设施的科学数据进行了层次化的分类。根据重大科技基础设施所支撑的科研活动各阶段,相应地,可将科学数据按科研流向层次化地划分为4类:实验仪器数据、实验操作数据、实验结果数据和科研成果数据。这样的划分既有助于厘清数据在不同科研阶段中的功能定位,也为后续的知识流建模、智能推荐与数据治理提供理论基础。

2.2 依托重大科技基础设施的科学数据个性化推荐相关研究进展

依托重大科技基础设施开展的科学研究产出了规模庞大、维度复杂的科学资源,吸引了学者对其推荐机制展开初步探索。
首先,在用户意图捕捉与隐式反馈挖掘方面,现有研究主要依赖于学术产出等单一维度。M. Barros等提出的literature based recommendation of scientific items(LIBRETT)方法通过科研文献挖掘作者信息与项目关联[10],以文章撰写数量作为隐式反馈,虽在天文学领域验证了其可行性,但该逻辑本质上是将科研结果反推科研需求,忽略了实验进行中的动态变化。A. Ghannadrad等通过对现有科学推荐系统的多维分析,构建了一套涵盖用户类型、兴趣表示及资源形态的综合分类框架,实现了对科研用户显隐性偏好特征(如用户画像、图表示)的建模,提供更准确的推荐[11]。同时也指出,目前研究大多集中于成熟的论文资源推荐,对实验阶段的数据集、复杂工作流等关键资源的挖掘仍处于起步阶段。
其次,针对特定设备日志的推荐研究虽然提升了运维效率,但仍局限于技术保障层面。N. Mukund等利用自然语言处理技术(natural language processing,NLP)对激光干涉引力波天文台(Laser Interferometer Gravitational-Wave Observatory,LIGO)的非结构化日志进行语义分类,以诊断设备问题[12]。这种推荐模式侧重于保障“科学仪器的运行状态”,而非服务于“科学家的研究路径”,未能将仪器运行数据与最终的科学发现逻辑链条打通。
综上所述,现有的研究多聚焦于科研流程中的特定环节或单一资源类型,尚缺乏对重大科技基础设施数据“全生命周期”属性的系统性建模。实现对重大科技基础设施科学数据的个性化推荐仍存在构建逻辑与技术范式的局限。一方面,推荐系统的建构呈现“碎片化”的特征,多集中在文献、实验日志或单一数据集的离散推荐,未能识别大科学装置数据从“问题提出—实验操作—结果分析—成果产出”的系统关联。由于缺乏全生命周期的管理视角,现有系统难以捕捉科研人员在不同阶段动态变化的、隐性且复杂的科研意图。另一方面,技术存在局限。重大科技基础设施数据具有多源异构、高维度、强语义等特性,而现有算法对跨模态关联的建模能力不足,在面对“评分缺失”和“高准入门槛”导致的冷启动问题时表现欠佳。
相比于离散的科研资源推荐,依托大设施的研究亟须构建一种逻辑与技术上可以覆盖全流程的链式推荐系统。因此,本文提出“重大科技基础设施科学数据”这一概念,旨在强调该类数据系统性、链式价值及其个性化推荐的必要性。

2.3 知识图谱、大语言模型在多源异构科学数据动态挖掘的应用

重大科技基础设施贯穿建设、运行与科研服务等多个阶段,知识管理贯穿其全生命周期。近年来,知识图谱(knowledge graph,KG)、大语言模型(large language models,LLMs)等AI技术的引入为多源异构数据整合、经验知识挖掘与智能决策提供了新途径,相关技术的应用在工程建设期的项目知识协同、运行期的运维与安全管理,以及运行后期依托设施开展的科研活动3个层面体现优势。
知识图谱技术可解决因异构信息、非结构化经验的复杂性,实现工程项目知识的深度挖掘与复用。Y. Yang等通过机器学习、NLP与图神经网络(graph neural network,GNN)集成于建筑信息模型(building information modeling,BIM)平台,实现了工程在建设时期的施工进度、成本与风险等关键指标的智能预测与预警,显著提升了跨阶段协同效率与项目绩效[13]。Z. Z. Hu等则从施工经验传承出发,利用NLP与知识图谱技术,从海量非结构化文档中提取经验知识并与BIM模型语义融合,实现知识的可视化与可复用管理,缓解了经验流失与交接混乱等问题[14]。N. Mukund等针对天文台运维日志的碎片化与非结构化问题,结合 NLP、深度学习与案例推理,构建了跨站点知识检索与推荐系统,实现在运行时期维修知识的结构化复用[12]。此外,F. Antonello等通过特征选择、支持向量机与进化算法识别系统关键节点,提升了设施可靠性分析与维护优化能力[15]。将 BIM 与应急仿真结合,标准化应急响应流程,增强了突发事件模拟与安全决策的科学性。
知识图谱可有效融合多源信息,促进知识发现。M. Koehler等探讨了知识图谱等AI技术在科研协作与激励管理中的作用,表明智能数据融合能提升科研任务分配与知识共享效率[16]。L. Qin等提出的协同知识图谱(collaborative knowledge graph,CKG)与图注意力模型(collaborative knowledge-aware graph attention network,CKAT),通过融合用户行为与设施元数据,显著改善了大规模科学数据的发现与推荐能力[17]。W. Wang等则以元数据驱动的深度学习与强化学习架构,实现数据全流程自动管理与实验配置优化[18]。
知识图谱通过实体及其属性、关系构建语义网络,在多源异构数据融合与知识推理中发挥核心作用。其“三元组”结构使数据语义化表示成为可能,并通过链路预测、语义嵌入等方法提升数据完整性与推理能力。多模态知识图谱(multi-modal knowledge graph,MMKG)进一步整合文本、图像、语音等多种数据类型[19],在重大科技基础设施的科学数据管理中,可实现实验数据、设备参数、科研成果等多源数据的语义统一与互操作性提升。基于知识图谱的推荐算法(如嵌入式、路径式与传播式)能够揭示用户与数据间的潜在语义关联,缓解传统推荐算法的稀疏与冷启动问题,提高推荐系统的准确性与可解释性。在科学实验推荐中,GraphGPT Net 等融合图嵌入与大模型语义嵌入的混合算法进一步展示了个性化推荐的新方向[20]。
大语言模型凭借大规模参数与深度网络架构,在学习自然语言的过程中获得了逻辑推理、语义分析与文本生成等涌现能力。LLMs可在知识管理中承担语义解析、信息抽取与自动化问答等任务[21],当与知识图谱结合时,知识实体与关系可嵌入大模型向量空间,使模型具备显式知识推理与事实增强能力[22]。多模态知识图谱与大语言模型的结合,为重大科技基础设施的科学数据智能服务提供了可扩展、可解释且具备自主学习能力的新范式。综上,从建设期的跨主体协同、运行期的智能运维,到科研期的数据赋能,AI 技术推动重大科技基础设施的知识管理从经验依赖向智能驱动转变,在重大科技基础设施科学数据价值挖掘中具有巨大应用潜力与显著促进作用。
综上所述,知识图谱与大语言模型技术的融合正在成为 AI 赋能知识管理的重要方向。通过引入知识图谱与大语言模型的深度融合技术,探索多模态语义关联建模与智能推荐方法,以实现科学数据的语义贯通和知识增强。

2.4 评述

综合以上文献可见,当前学术界在科学数据定义与分类、AI 赋能的知识管理、以及科学数据个性化推荐3个方向均已形成一定研究积累,但仍存在构建逻辑局限与技术局限。一方面,当前研究科学数据挖掘的研究范围大多停留在单阶段或特定功能层面,多数工作集中于论文或科研日志推荐,对实验数据、工作流、专利技术等综合科研资源的推荐研究明显不足。针对这一问题,本文构建重大科技基础设施科学数据的层次化分类体系,将其划分为实验仪器数据、实验操作数据、实验结果数据和科研成果数据4类,提出重大科技基础设施的数据产生—数据应用—知识传播与应用全过程的系统性知识管理框架,以期为设施的知识流建模和数据智能推荐奠定基础。另一方面,数据特征复杂且用户反馈难获取,重大科技基础设施生成的科学数据具有多模态、高维度与强语义特征,当前AI技术更多用于结构化信息的处理,而对跨模态数据(如实验数据、图像、文献和报告)之间的语义关联研究仍显不足,现有推荐算法难以有效捕捉其隐式关联。科学领域普遍缺乏明确的用户评分或交互数据,导致推荐系统难以学习真实需求,冷启动问题尤为突出。重大科技基础设施的用户类型多样,包括科学家、实验操作人员、数据分析师和管理者,不同群体对数据推荐的需求差异进一步增加了推荐系统设计的复杂性。针对这一问题,本文引入知识图谱与大语言模型融合的思路,实现“AI for Science”范式下对复杂科研活动的全方位赋能。

3 重大科技基础设施科学数据的种类及管理挑战/ Categories and challenges of scientific data in large-scale research infrastructures

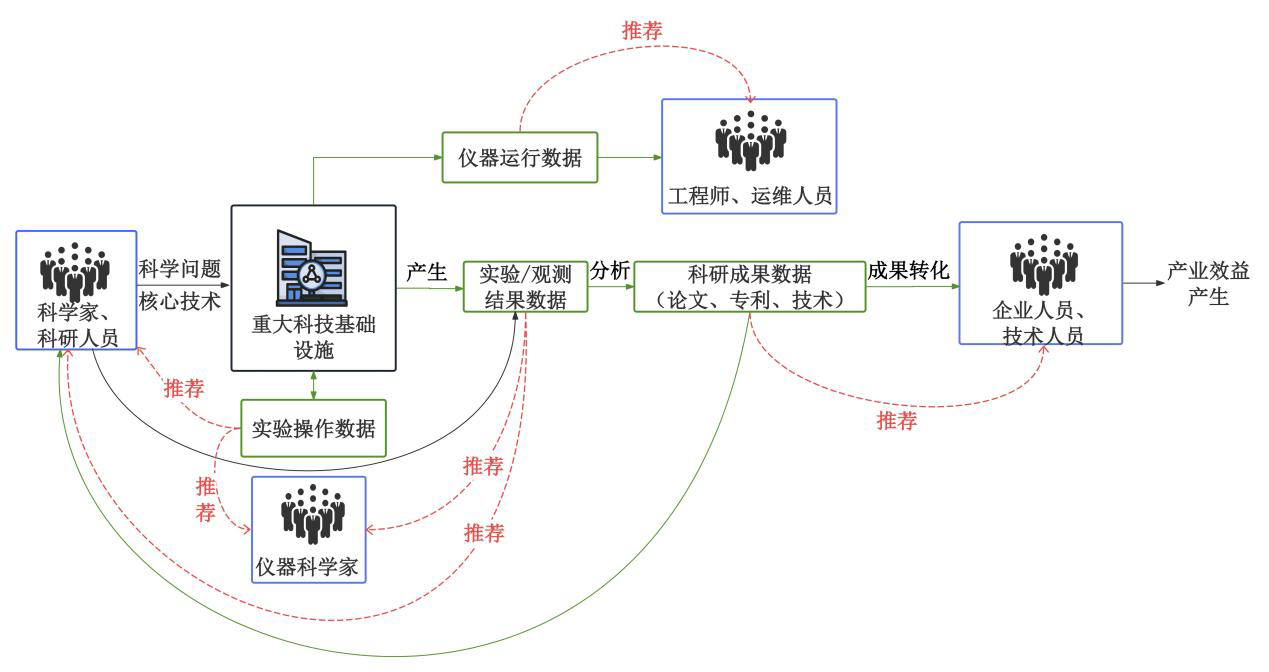
现代科学研究始终面临着如何处理海量科学数据的核心挑战,以应对复杂科学研究的顺利推进和科研成果产出的实际落地。从实践上讲,利用重大科技基础设施的科学研究活动主要包括由科学家提出问题和假设、由实验人员利用重大科技基础设施进行实验分析、通过科研机构与出版商进行科研成果和数据传播与共享、技术人员研发相关技术、企业人员落地成果转化等环节,形成“科学问题(科学家)—实验设备(实验员)—科学数据及文献(科研机构及中介)—技术研发(技术人员)—产业应用(企业人员)”高效闭环(图1)。这种全流程的闭环产出模式是新建科学设施的标配,体现出当前科学设施在升级改造过程中的新需求和新机遇。
图1 重大科技基础设施科学数据产出与传播流程

Figure 1 Scientific Data Production and Dissemination Process in Large-scale Research Infrastructures

3.1 重大科技基础设施科学数据的种类

从管理学视角看,重大科技基础设施的科学数据管理贯穿“数据产生—数据应用—知识传播与利用”的全过程。根据数据来源与功能,可将其分为4类:实验仪器数据、实验操作数据、实验结果数据和科研成果数据。①实验仪器数据包括设施仪器的技术规格、性能指标、校准信息、运行状态和维护记录等。这些数据反映设备的运行稳定性,是保障仪器长期可靠运行、优化资源配置和制定维护策略的重要依据。②实验操作数据涵盖实验流程、操作步骤、实验环境参数及安全规范等,保证实验过程的标准化与可追溯性。系统记录和分析操作数据有助于发现潜在误差、改进实验方案、提升研究执行效率。③实验结果数据包括实验过程中的原始观测数据、处理结果与分析结论,以及由大型设施(如“天眼”“子午工程”)获取的观测数据。这些数据是科研创新的核心资源,决定研究的可复现性与可信度。科学的数据采集、存储与管理能够提升科研效率,促进数据共享和再利用。④科研成果数据指依托重大科技基础设施形成的学术论文、专利和科研报告等高价值知识产出。它们是科学发现与技术创新的集中体现,推动理论发展与成果转化,为相关产业提供创新支撑。

3.2 重大科技基础设施科学数据的特点

自2011年麦肯锡年度总结报告提出“大数据”概念以来,学术界公认大数据具有“4V”特征——体量大(volume)、生成快(velocity)、多样性(variety)和高价值(value)。重大科技基础设施科学数据充分体现这些特性,并因其独特属性带来管理上的难点。
(1)数据生成快速、规模超大且生命周期长、保存期长。基于重大科技基础设施的科学实验在短时间内产生海量观测数据并需流程化处理,其生命周期涵盖采集、处理、发布、归档或废弃等阶段。
(2)数据多源异构与跨学科特性突出,存储方式多样且要求高,管理、获取与分析难度大。重大科技基础设施生成的数据涵盖文本、图像、光谱、分子模型、时序数据等多模态形式,科学现象的量化指标涉及图像、语音、时间序列多种数据类型,且分布于不同国家和机构。随着重大科技基础设施的建设和科学传感器的广泛应用,科学数据呈现出多源、异构和海量的特性。
(3)高价值与开放共享需求并存,与安全隐私保护形成确权矛盾。重大科技基础设施科学数据的巨大价值推动了数据的开放共享。美国、德国等采用FAIR原则(可查找、可获取、可交互、可重复使用)和CARE原则(集体收益、质量保证、责任与伦理),国内已初步形成由国家级数据中心、领域平台和区域平台构成的多层次科学数据共享体系。但是科学数据涉及国家利益和隐私,共享需要平衡收益与保护。

3.3 重大科技基础设施科学数据管理及个性化推荐的挑战

重大科技基础设施科学数据管理面临的挑战,一是多源异构数据融合与共享的挑战:由于重大科技基础设施数据跨学科、跨领域、多源异构、复杂性、多样性的特点,存在数据孤岛现象,亟须探索基于知识图谱和大语言模型的科学数据多模态融合方法,以及数据跨区域、跨领域的数据共享机制。二是重大科技基础设施科学数据个性化推荐的挑战,亟须针对目前重大科技基础设施科学数据的多源异构特点,结合各类用户对重大科技基础设施数据资源管理的需求,从管理科学、系统科学、知识科学、计算机科学等交叉学科的角度,在分析用户特点和数据特点的基础上,研究重大科技基础设施科学数据个性化推荐算法。
相比于个性化推荐商品数据等传统问题,重大科技基础设施科学数据个性化推荐的具有以下特征和难点。
(1)用户和数据种类多且复杂。如图1所示,涉及到的用户包括科研人员(科学家)、仪器科学家、仪器工程师、技术成果转化人员(或企业人员)4类,产生的数据涉及实验仪器数据、实验结果数据、实验操作数据、科研成果数据4种类型[18],且各环节的数据类型、结构、用途、处理方式不同。
(2)从科研人员提出科学研究问题到产生研究成果是一个涉及多阶段的过程,各阶段的需求动态变化,科研问题提出阶段关注文献与实验方法,实验执行阶段需设备状态与历史数据,研究总结阶段依赖数据分析工具与科研成果,最终科研产出的质量取决于整个过程获取数据的质量而非某个单一环节。
综上,重大科技基础设施科学数据推荐是一个多用户—多任务—多数据匹配的过程,因其具有阶段性和过程性,增加了用户需求的动态性、变化性和不确定性。

4 AI赋能重大科技基础设施科学数据推荐研究展望/ A research outlook on ai-enabled scientific data recommendation for large-scale research infrastructures

从管理学、数据科学、信息科学、知识科学、行为科学等交叉学科的角度,针对目前重大科技基础设施中科学数据的特点和数据管理中的瓶颈问题,AI赋能重大科技基础设施科学数据知识图谱构建和个性化推荐理论、模型、工具和方法上有如下研究展望。

4.1 重大科技基础设施科学数据个性化推荐机理与链式推荐系统

重大科技基础设施科学数据个性化推荐本质上是一个多用户—多任务—多数据匹配的过程,因其具有阶段性和过程性,增加了用户需求的动态性、变化性和不确定性。如何基于人工智能方法,构建面向重大科技基础设施科学数据的多源异构、动态可调、个性化的链式推荐系统是一个需要解决的问题,包括重大科技基础设施科学数据个性化推荐过程及推荐机理分析、重大科技基础设施科学数据推荐关键环节及影响因素分析以及个性化链式推荐系统框架设计。具体来讲,可拟采用链式推荐系统建模科学家的研究行为序列,实现贯穿科研全流程的智能链式推荐,动态感知科学家需求,优化科研资源匹配。相比传统静态建模方法,链式推荐能够更好地适应科学研究的时序依赖性和兴趣演变,确保推荐内容始终匹配当前研究需求,提升科学数据获取效率和研究创新能力。

4.2 重大科技技术设施科学数据用户需求建模

高质量的科学数据推荐依赖于对用户需求的准确识别。重大科技基础设施的科学数据应用场景具有多角色、多任务和多学科交叉的特征,用户在信息行为、知识经验和角色身份等方面差异较大。因此,如何在复杂科研活动中精准刻画用户需求,是提升科学数据推荐效果的关键问题。科研用户的需求通常呈现多维度和动态演化的特征,可区分为短期需求与长期需求两类。短期需求受科研任务驱动,反映用户在特定阶段的即时目标;长期需求则由用户自身属性主导,体现知识积累与能力水平的持续变化。本文从科研任务驱动与用户属性演化两个层面构建科学数据用户需求建模框架,以实现对用户动态需求的精确刻画与持续更新。
短期需求反映科研用户在特定阶段的即时意图,是任务主导的行为表现。可将科研任务驱动的短期需求建模分为3个关键环节。首先,结合大语言模型与知识图谱的语义增强能力,对用户输入进行结构化理解,从而识别即时需求所关联的科研领域。其次,依据科研任务的阶段性结构,设计多轮交互机制以实现用户意图的动态跟踪和阶段分类。最后,针对用户表达中的语义模糊问题,引入领域知识约束,在交互过程中逐步澄清并识别真实意图。该建模方法能够在复杂科研情境下实时捕捉科研用户的任务阶段与即时意图,为科学数据推荐提供语义层面的精确支持。
长期需求体现科研用户在科研过程中的知识积累与能力演化,是用户长期行为与个性化偏好的综合反映。与短期任务导向不同,长期需求主要由用户自身隐式属性(如领域知识储备、数字能力、仪器使用经验等)驱动。这些属性随科研活动进程不断变化,从而影响用户对数据的理解、使用与偏好。针对科研用户的任务阶段、能力水平与领域知识储备,提取并向量化表达相关特征。考虑到用户画像维度复杂、依赖关系密集,可采用图结构建模以捕捉特征间的关联与层次结构。在动态更新方面,应融合短期意图识别模块的输出,实现长期特征与即时行为的联合建模,从而刻画用户属性的动态关联与演化趋势。该策略可在科研活动推进过程中持续更新用户画像,使画像实时反映科研用户的能力水平与偏好变化,为个性化推荐提供长期支撑。

4.3 重大科技基础设施多源异构科学数据的知识图谱构建

重大科技基础设施的科学数据具有海量性、多源异构性和跨学科性,亟须构建能够支撑深度整合与智能管理的知识图谱体系。然而,现有方法在处理此类复杂科学数据时,普遍面临知识表征离散化与语义关联断裂的双重挑战。传统方法受限于语义解析粒度粗、跨模态对齐能力弱、知识推理与补全能力不足等问题,难以支撑科学数据的智能化管理。重大科技基础设施科学数据的知识图谱构建需跨越“数据—知识—图谱”三元空间的语义鸿沟,其关键难点体现在知识抽取复杂、多模态融合机制不完善、知识补全与推理能力有限3个方面。为此,如何结合大语言模型与知识图谱技术,突破传统知识抽取、语义融合与知识推理的瓶颈,构建适用于重大科技基础设施多源异构科学数据的智能知识管理体系是研究的重点问题。
(1)基于大语言模型的科学数据自动化知识抽取方法。针对传统方法自动化程度低、依赖人工规则的问题,需探索如何基于生成式命名实体识别(generative NER)与多粒度信息分层推理关系抽取(hierarchical inference network,HIN)的方法,实现科研日志、设备运行记录、实验报告等非结构化数据的自动化知识抽取。通过比较不同模型在多学科交叉数据上的表现,评估抽取结果的准确性与鲁棒性,提升科学数据的结构化表达能力。
(2)多源异构科学数据的语义融合与知识图谱构建。为解决数据孤岛与语义割裂问题,需研究设计基于大语言模型的跨模态特征学习与领域知识引导的数据融合机制,通过跨模态预训练模型(如BLIP、FLAN-T5)的语义对齐与生成对抗网络(generative adversarial network,GAN)辅助训练,实现文本、图像、音频、视频等模态的深度融合。同时,构建“实验设备—实验过程—科研成果”的知识网络,并引入时间序列知识图谱(temporal knowledge graph,TKG)以实现动态更新与持续学习,支撑科学数据的全局关联与精准管理。
(3)基于大语言模型与链路预测的科学知识图谱推理与补全。针对知识缺失与关系不完整的问题,本文将利用大语言模型的推理能力结合链路预测技术,优化科学知识的自动补全与推理过程。通过结构化知识嵌入与知识前缀适配(knowledge prefix adapter,KoPA)机制增强推理能力,提升科学知识图谱的完备性与可解释性,为后续的智能推荐与科学发现提供支撑。

4.4 基于知识图谱和大语言模型的科学数据个性化推荐算法

重大科技基础设施的科学研究活动通常经历“提出问题与假设—实验检验与验证—科研成果传播与共享”3个阶段。这一过程中,涉及科研人员、仪器科学家、设施运维人员和科技成果转化人员等多类用户,数据类型涵盖实验仪器数据、实验结果数据、实验操作数据及科研成果数据。推荐系统作为高效的信息过滤工具,能够帮助科研人员从海量数据中快速获取所需资源。然而,重大科技基础设施的科学数据推荐仍面临三大关键问题:访问效率低、数据稀疏性与冷启动严重、交互智能不足。首先,观测数据普遍采用拉取式访问模式,频繁轮询导致高访问成本和响应延迟,削弱了科研时效性。其次,科学数据具有多源异构和跨学科特性,数据分布稀疏且缺乏显式反馈,传统推荐算法难以刻画用户需求与语义关联。最后,科研人员的需求往往动态变化,传统静态推荐难以实现个性化、对话式的实时推荐与智能交互。
(1)基于数据预取与放置策略的观测数据推荐模型。科研人员在使用重大科技基础设施时,既可能直接进行实验,也可能调用观测数据。然而,跨地域与海量数据环境下的拉取式访问机制导致数据传输延迟明显。为此,需建立结合数据预取(prefetching)与数据放置策略(data placement)的混合预测模型,以提升数据访问效率。
(2)面向冷启动与数据稀疏问题的知识图谱增强推荐算法。重大科技基础设施的数据类型复杂、分布稀疏,传统推荐系统难以精准匹配科研人员的个性化需求,尤其在新用户或跨学科场景下更易受冷启动影响。知识图谱以结构化方式揭示数据间的深层语义关联,为应对稀疏性与冷启动问题提供了新路径。
(3)面向动态交互的大语言模型对话式推荐算法。传统推荐系统以静态偏好为依据,缺乏对用户动态意图的捕捉。而科研人员在数据探索过程中,其需求往往逐步形成并实时调整。要将大语言模型与知识图谱结合,实现语义理解与交互推荐的深度融合。基于此,需构建包含用户建模、对话管理与推荐推理引擎三部分的对话式推荐框架(conversational recommendation system,CRS)。用户建模模块动态追踪科研人员兴趣;对话管理系统通过实时交互调整推荐策略;推荐与推理引擎利用LLMs理解查询意图,结合知识图谱语义推理生成高质量推荐结果。

5 总结与展望/ Conclusion and prospect

本文面向重大科技基础设施多源异构科学数据管理与知识发现需求,构建了融合大语言模型与知识图谱的个性化推荐系统框架,为依托重大科技及基础设施研究的现实问题提供解决方案,体现了“AI for Science”时代的科研支持范式。
针对数据沉积与共享难问题,知识图谱技术可将原本孤立、静态的数据转化为语义关联的知识网络。利用知识图谱的结构化表示能力,实现跨实验、跨环节数据的语义贯通,使沉积的数据在统一的知识框架下得以显现与流转,打破“数据孤岛”。
针对实验重复与操作难问题,知识图谱技术与大语言模型的融合可对科研人员实验操作日志及历史意图进行深度挖掘。大语言模型能够识别科研人员当前的实验语境,预测其潜在的知识需求,实现“链式推荐”的范式,从而精准推送已有的相似实验设计与结果数据。既有效规避无意义的重复性实验,降低大型仪器的操作门槛,又为科研人员依托大设施的科研全流程赋能。
针对沟通难与产出质量差的问题,本框架设计的个性化推荐交互模块,实现了从传统的“关键词检索”向“知识意图感知”的跨越。通过AI赋能的精准资源匹配,不仅提高了研究者获取核心科学信息的效率,更通过挖掘数据间的隐性关联(如跨学科的实验关联),促进科研资源发现,助力高水平科研成果的产出。
综上所述,本文提出的架构在高能物理、散裂中子源等重大科技基础设施环境中具备良好的适应性。未来,将进一步围绕3个方向深化:①在技术层面,优化知识图谱的语义嵌入与链路预测方法,提升跨模态数据的语义对齐与多学科适配能力;②在系统层面,构建可信、高交互的科研智能助手,实现复杂科研任务的实时理解与动态推荐;③在应用层面,推动系统在更多重大科技基础设施场景中落地,扩展至材料科学、空间科学等多学科研究领域,并促进与科研平台的深度融合,形成产学研协同创新。
[1]
陈和生. 促进我国重大科技基础设施持续发展[J]. 科技导报, 2020, 38(10): 44-46.

CHEN H S. Promote the sustainable development of major scientific and technological infrastructure of China[J]. Science & technology review, 2020, 38(10): 44-46.

[2]
王贻芳. 中国重大科技基础设施的现状和未来发展[J]. 科技导报, 2023, 41(4): 5-13.

WANG Y F. Current status and future prospects of the national major infrastructure for science and technology [J]. Science & technology review, 2023, 41(4): 5-13.

[3]
郭华东, 陈和生, 闫冬梅, 等. 加强开放数据基础设施建设, 推动开放科学发展[J]. 中国科学院院刊, 2023, 38(6): 806-817.

GUO H D, CHEN H S, YAN D M, et al. Strengthening open data infrastructure and promoting open science [J]. Bulletin of Chinese Academy of Sciences, 2023, 38(6): 806-817.

[4]
杨小康, 许岩岩, 陈露, 等. AI for Science:智能化科学设施变革基础研究[J]. 中国科学院院刊, 2024, 39(1): 59-69.

YANG X K, XU Y Y, CHEN L, et al. AI for Science: AI-enabled scientific facility transforms fundamental research [J]. Bulletin of Chinese Academy of Sciences, 2024, 39(1): 59-69.

[5]
李国杰. 智能化科研(AI4R):第五科研范式[J]. 中国科学院院刊, 2024, 39(1): 1-9.

LI G J. AI4R: the fifth scientific research paradigm [J]. Bulletin of Chinese Academy of Sciences, 2024, 39(1): 1-9.

[6]
廖方宇, 李婧, 龙春, 等. 开放科学背景下科学数据开放共享安全挑战及我国对策思考[J]. 农业大数据学报, 2024, 6(2): 146-155.

LIAO F Y, LI J, LONG C, et al. Security challenges and countermeasures on open sharing of scientific data in the context of open science [J]. Journal of agricultural big data, 2024, 6(2): 146-155.

[7]
李树深. 数据与计算是科技创新的巨大驱动力[J]. 数据与计算发展前沿, 2019, 1(1): 1.

LI S S. Data and computation are powerful drivers for scientific and technological innovation [J]. Frontiers of data and computing, 2019, 1(1): 1.

[8]
中华人民共和国国务院办公厅. 科学数据管理办法[EB/OL]. [2026-02-12].

General Office of the State Council of the People's Republic of China. Measures for the management of scientific data[EB/OL]. [2026-02-12].

[9]
黎建辉, 李跃鹏, 王华进, 等. 科学大数据管理技术与系统[J]. 中国科学院院刊, 2018, 33(8): 796-803.

LI J H, LI Y P, WANG H J, et al. Scientific big data management technique and system [J]. Bulletin of Chinese Academy of Sciences, 2018, 33(8): 796-803.

[10]
BARROS M, MOITINHO A, COUTO F M. Using research literature to generate datasets of implicit feedback for recommending scientific items[J]. IEEE access, 2019, 7: 176668-176680.

[11]
GHANNADRAD A, AREZOUMANDAN M, CANDELA L, et al. Recommender systems for science: a basic taxonomy[C]//Proceedings of the 18th Italian research conference on digital libraries. Aachen: CEUR-WS.org, 2022.

[12]
MUKUND N, THAKUR S, ABRAHAM S, et al. An information retrieval and recommendation system for astronomical observatories[J]. The astrophysical journal supplement series, 2018, 235(1): 22.

[13]
YANG Y, ZHAO B. How building information modelling mitigates complexity and enhances performance in large-scale projects: evidence from China[J]. International journal of project management, 2025, 43(2): 102694.

[14]
HU Z Z, ZHANG J P, YU F Q, et al. Construction and facility management of large MEP projects using a multi-scale building information model[J]. Advances in engineering software, 2016, 100(10): 215-230.

[15]
ANTONELLO F, BARALDI P, ZIO E, et al. A novel metric to evaluate the association rules for identification of functional dependencies in complex technical infrastructures[J]. Environment systems and decisions, 2022, 42(3): 436-449.

[16]
KOEHLER M, SAUERMANN H. Algorithmic management in scientific research[J]. Research policy, 2024, 53(4): 104985.

[17]
QIN L, WU W S, LIU D, et al. Autonomous planning and processing framework for complex tasks based on large language models[J]. Acta automatica Sinica, 2024, 50(4): 862-872.

[18]
WANG W, FENG F, HE X, et al. Denoising implicit feedback for recommendation[C]//Proceedings of the 14th ACM international conference on Web search and data mining. New York: Association for Computing Machinery, 2021: 373-381.

[19]
潘晨辉.基于多模态知识图谱的电子商务智能推荐研究[D]. 沈阳:沈阳工业大学, 2024.

PAN C H. Research on intelligent recommendation of E-commerce based on multimodal knowledge graph[D]. Shenyang: Shenyang University of Technology, 2024.

[20]
张凯, 石栖. 基于知识图谱的实验方案推荐研究——以有机太阳能电池为例[J]. 知识管理论坛, 2024, 9(5): 448-459.

ZHANG K, SHI Q. Experimental scheme recommendation based on knowledge graph: a case study of organic solar cells [J]. Knowledge management forum, 2024, 9(5): 448-459.

[21]
ZHAO W X, ZHOU K, LI J, et al. A survey of large language models[J]. arXiv:2303.18223, 2023.

[22]
朱莹. 基于多模态知识图谱与大语言模型的视觉问答系统: CN202410480844.4[P]. 2024-07-26.

ZHU Y. Visual question answering system based on multimodal knowledge graph and large language model: CN202410480844.4[P]. 2024-07-26.

文章导航

/

〈 〉