AI赋能知识管理与服务的拓荒探索专题

领域大模型数据基座框架构建与应用探索

  • 谢文骏 , 1 ,
  • 董焕晴 1 ,
  • 曹高辉 1, 2
展开
  • 1. 华中师范大学信息管理学院 武汉 430079
  • 2. 华中师范大学数据治理与智能决策研究中心 武汉 430079

作者贡献声明 /Author contributions:

谢文骏:研究思路设计,论文撰写与修改;

董焕晴:研究思路设计,论文修改;

曹高辉:研究思路和方法指导,论文修改。

谢文骏,博士研究生,E-mail:

董焕晴,博士研究生

曹高辉,院长,教授,博士。

收稿日期: 2026-01-09

  网络出版日期: 2026-02-28

基金资助

华中师范大学中央高校基本科研业务费项目“大语言模型驱动的半导体产业科技预测及政策引导研究”(CCNU24JC034)

Construction and Application Exploration of Data Foundations for Domain Large Models

  • Xie Wenjun , 1 ,
  • Dong Huanqing 1 ,
  • Cao Gaohui 1, 2
Expand
  • 1. School of Information Management, Central China Normal University, Wuhan 430079
  • 2. Center for Data Governance and Intelligent Decision Making, Wuhan 430079

Xie Wenjun, Doctoral Candidate, E-mail:

Dong Huanqing, Doctoral Candidate

Cao Gaohui, Dean,Professor, PhD.

Received date: 2026-01-09

  Online published: 2026-02-28

Supported by

Fundamental Research Funds for the Central Universities project of Central China Normal University, titled “Large Language Model-Driven Technological Forecasting and Policy Guidance for the Semiconductor Industry”(CCNU24JC034)

摘要

【目的/意义】 面向领域大模型在专业化与高风险应用场景中对高质量数据支撑与可信运行的现实需求,系统探讨领域大模型数据基座的基本内涵、关键特征与系统化构建路径,旨在为推动可信人工智能的落地应用提供理论框架与方法支撑,为领域大模型数据基座的规范化建设与治理实践提供系统性参考。 【方法/过程】 在系统梳理相关文献的基础上,明确领域大模型数据基座的概念内涵、主要特征与构成要素,引入分层模块化架构理论,构建分层化的领域大模型数据基座模型框架,主要涵盖数据资源层、知识组织层、知识存储与语义索引层、模型层、算法层、应用层、治理与运行支撑层,以此刻画数据、知识与模型协同运行的整体机制。最后,采用基于公开证据的桌面研究与跨案例对照方法开展框架的情境化适用性论证。 【结果/结论】 跨领域对照显示,该框架能够解释不同领域参照系统在外部知识记忆接入、证据约束生成、合规审计输出链条上的共性机制,在此基础上,进一步凝练出数据契约、索引配置与评测基线等可复用方法要素,验证该框架在跨领域情境下的适用性与可迁移性。
本文引用格式

谢文骏 , 董焕晴 , 曹高辉 . 领域大模型数据基座框架构建与应用探索[J]. 知识管理论坛, 2026 , 11(1) : 24 -39 . DOI: 10.13266/j.issn.2095-5472.2026.003

Abstract

[Purpose/Significance] In response to the practical demand for high-quality data support and trustworthy operation of domain large models in specialized and high-risk application scenarios, this study systematically examines the basic connotation, key characteristics, and systematic construction path of the domain large model data foundation. It aims to provide a theoretical framework and methodological support for the practical deployment of trustworthy artificial intelligence, and to offer systematic references for the standardized construction and governance practice of the domain large model data foundation. [Method/Process] Based on a systematic review of the relevant literature, this study clarified the conceptual connotation, major characteristics, and constituent elements of the domain large model data foundation. It introduced the theory of layered modular architecture to construct a layered framework for the domain large model data foundation, mainly covering the data resource layer, knowledge organization layer, knowledge storage and semantic indexing layer, model layer, algorithm layer, application layer, and governance and operational support layer, so as to characterize the overall mechanism of the coordinated operation of data, knowledge, and models. Finally, a desk research method based on public evidence and a cross-case comparison approach were employed to demonstrate the contextual applicability of the framework. [Result/Conclusion] Cross-domain comparisons show that the proposed framework can explain the common mechanisms underlying external knowledge memory access, evidence-constrained generation, and compliance-audit output chains in reference systems across different domains. On this basis, the study further distills reusable methodological elements such as data contracts, index configuration, and evaluation baselines, thereby validating the applicability and transferability of the framework across domains.

1 引言/Introduction

近年来,人工智能进入以大模型为核心驱动力的新阶段,数据、算力与算法的协同演进持续重塑智能系统的知识生成方式与应用范式。随着模型规模与任务广度不断拓展,智能系统逐步由通用能力走向领域化与专业化,对系统的整体质量、可解释性与可持续运行提出了更高要求。在这一过程中,数据不再仅作为支撑性资源存在,而是日益成为界定智能系统能力边界与应用效能的关键生产要素。在国家层面,大模型与高质量数据体系的协同建设已被明确置于人工智能发展战略的重要位置。《国务院关于深入实施“人工智能+”行动的意见》明确提出,要加快科学大模型建设应用,推动基础科研平台和重大科技基础设施智能化升级,打造开放共享的高质量科学数据集,提升跨模态复杂科学数据处理水平[1]。相关政策为以领域大模型(domain large models, DLMs)为代表的专业化智能系统提供了明确的发展方向与应用场景,也凸显了数据基座在构建可信、可用与可持续智能生态中的基础性、枢纽性地位[2-5]。
在此背景下,如何围绕领域大模型构建稳定、高质量、可治理的数据基座,成为推动可信人工智能落地的重要前提。一方面,领域大模型在专业知识密集、高风险决策或强证据依赖的应用场景中,对数据的真实性、可核查性与结构一致性提出了更高要求[6-11];另一方面,数据资源、知识组织、模型能力与应用服务之间的耦合程度,直接影响智能系统在实际运行中的稳健性、响应效率与可持续演进能力[11-14]。因此,有必要从整体视角审视领域大模型与数据基座之间的协同关系,探索其一体化构建的基本逻辑与关键问题。基于此,本文聚焦领域大模型数据基座建设中的结构性与机制性问题,重点关注数据与模型协同演进背景下的数据组织方式、运行结构与质量保障逻辑,旨在从系统性与规范性的角度,梳理领域大模型数据基座的总体框架与运行逻辑,阐明数据要素在不同层级与不同主体之间的协同作用机制,以期为领域大模型数据基座的系统构建与规范化推进提供理论依据与实践参考。

2 领域大模型数据基座的概念界定与实践基础/Conceptual definition and practical foundations of the domain large model data foundation

2.1 概念界定与研究对象

数据基座一词可从数据治理与知识基础设施的两条谱系加以追溯。数据治理领域以系统化的数据管理框架为基础,强调通过明确职责分工、流程规范与质量控制,构建可持续的数据管理体系。国际数据管理协会发布的《数据管理知识手册》(DAMA-DMBOK),强调以治理、质量与元数据为核心建立可持续的数据管理体制,以数据为基础的数据治理实践提供了制度化支撑[15]。与此同时,知识基础设施研究强调数据在知识生产与共享中的基础性作用。FAIR(findable, accessible, interoperable, reusable)原则及关联数据、资源描述框架和网络本体语言等语义网规范,将数据的可发现、可访问、可互操作与可复用确立为公共准则,并通过可计算表示与溯源机制,支撑跨源对齐与证据核验[16]。随着人工智能系统在高风险与专业场景中的应用深化,数据与知识基础设施被进一步赋予合规与审计职能。欧盟《人工智能法案》与 NIST AI 风险管理框架,将可追溯性、透明性与风险控制纳入强制性要求,使数据基础设施不仅承担支撑模型训练的功能,也成为智能系统可信运行的重要保障[17]。在模型层面,知识密集型任务的相关研究表明,将外部、可更新的结构化知识作为“非参数化记忆”引入模型,可有效提升生成结果的事实一致性与可核查性[18]。其基本机理在于通过检索与筛选机制,将参数化模型能力与证据性语料相结合,使生成过程受到外部知识约束,从而在开放域问答与专业应用中获得更稳定的性能表现[10,19-20]。总体而言,数据既是知识的重要载体,也是大模型训练与推理的基础要素。已有研究普遍指出,预训练数据的规模、结构与质量在很大程度上决定了模型能力的上限[21]。因此,在领域大模型场景中,亟需一种能够持续汇聚权威数据、支撑知识更新并保障可信生成的数据基础设施,使模型获得稳定、可追溯的领域知识背景,从而具备专业化的问题理解与解决能力[22]。
基于此,本文将领域大模型数据基座界定为面向特定行业或学科,为领域大模型提供高质量、结构化、可追溯并可持续演进的数据与知识基础设施。不同于传统意义上的数字平台或静态知识库,领域大模型数据基座强调围绕数据全生命周期的系统化组织与治理,通过语义组织与证据溯源机制,将数据资源与模型能力形成稳定耦合,服务于可信生成与可审计运行的目标。数据基座并非单一形态,而是可依据不同行业的知识结构与应用需求,实例化形成具有差异化特征的领域化数据基础设施。

2.2 主流实践脉络与关键问题

在训练侧,已有研究较为明确地表明,模型架构与训练数据组织并非彼此独立,训练语料的规模、结构与分布设计会显著影响模型能力边界与泛化表现[21]。统一文本到文本范式的模型研究也说明,任务表达方式、语料组织与训练目标之间存在强耦合关系,数据并非单纯输入材料,而是能力塑形机制的一部分[23]。领域继续预训练研究显示,将模型在通用语料基础上持续适配至领域语料,能够有效提升领域任务表现,这强化了按层级组织、按场景迭代更新训练数据的必要性[24]。与此同时,领域基础模型综述研究反复指出,数据稀缺、异构性高、标注成本高与质量不稳定已成为领域模型落地的核心约束[7]。围绕知识注入路径的研究进一步表明,领域知识进入大模型的方式正在从单一路径扩展为多种机制并存,包括继续预训练、参数高效微调、知识图谱融合与检索增强等[22]。这意味着,若将领域大模型数据基座仅理解为训练语料仓库,将无法覆盖当前主流实践中的关键机制,也难以解释模型在部署阶段的可信运行问题。
在推理侧,检索增强生成(retrieval-augmented generation,RAG)路径进一步强化了数据基座的运行时(runtime)属性。RAG相关研究指出,通过将外部知识作为非参数化记忆引入生成过程,可以有效改善知识密集型任务中的事实一致性与可核查性[18]。后续综述研究则表明,RAG系统的效果不仅取决于生成模型本身,还高度依赖知识库组织、检索器选择、索引策略与生成阶段的约束机制[19]。系统综述与实证研究也显示,检索语料来源的权威性、检索配置与任务类型适配程度,会显著影响系统输出质量与可用性[10,19-20]。因此,推理阶段的输出质量在很大程度上依赖于数据与知识资源的组织质量,而不仅仅取决于模型参数能力。在高规范领域的工程实践中,模型训练与推理逐渐呈现出一条连续的数据—知识处理流程,即“知识提炼与组织—检索增强—证据约束生成”。在这一流程中,前端通过对领域数据进行结构化整理与知识化加工形成可检索语料,后端则通过RAG等机制将外部证据引入生成过程,以提升事实一致性与可核查性[18-19,25]。在检索评测层面,可采用BEIR等异构基准衡量跨域检索与排序效果[26];在运行维护层面,则需引入MLOps流程对版本、监测与回滚机制进行管理[27]。

2.3 领域大模型数据基座的主要特征

在领域大模型应用场景中,数据基座不仅承担数据汇聚与存储功能,更深度嵌入模型训练、知识调用与生成控制等关键环节,其关键特征直接影响领域大模型的专业能力、可信水平与持续演进能力。基于此,本文将领域大模型数据基座的主要特征概括为以下几个方面。
(1)领域权威性与任务适配性:以高质量专业知识支撑模型能力形成。领域大模型数据基座高度贴合特定行业或学科的知识体系,强调领域知识的系统整合与深度覆盖。相较于通用大模型依赖大规模异质语料获取广泛但浅层的知识表征,领域数据基座通过汇聚医学病例、法律文书、科研文献等高质量专业数据,为模型提供稳定、权威的领域知识来源。通过将精确的领域知识持续引入模型训练与推理过程,数据基座有效提升了模型在专业任务中的准确性与可靠性,这一过程通常被视为面向领域应用的知识注入机制[22]。
(2)语义结构化与证据可回链性:以知识组织质量支撑可检索、可验证生成。语义关联性是领域大模型数据基座的重要特征之一,体现为对数据与知识之间语义关系的系统刻画与结构化表达。实践中,数据基座通常依托知识图谱、本体等语义技术对领域知识进行组织与管理[28-29]。通过将领域中的核心概念、实体及其关系显式表示为结构化语义网络,数据基座使模型能够理解概念之间的层级关系与语义关联,从而突破对孤立文本片段的依赖。这种以语义网络为基础的组织方式,有助于提升模型在复杂领域问题中的检索效率与推理能力[30]。
(3)训练—推理一体化的连续支撑能力:以统一对象与接口打通能力形成链条。领域大模型的能力形成并不只发生在训练阶段,而是由训练数据组织、知识更新、检索增强与生成约束共同塑造。训练侧研究已表明,训练语料的规模、结构与分布设计显著影响模型能力边界[21],而推理侧RAG研究则进一步说明,生成质量高度依赖外部知识组织与检索配置[18-19]。这意味着,领域数据基座必须具备跨训练与推理环节的连续支撑能力。同一批领域知识资源既应能进入训练数据组织流程,也应能在运行时以检索证据形式参与生成控制。
(4)版本化与持续演进能力:以全生命周期管理保障知识时效性与系统稳定性。领域知识具有持续演进的特征,相应地,领域大模型数据基座需具备支持长期运行与动态更新的能力。不同于一次性构建的数据集,数据基座强调覆盖数据全生命周期的管理,从初始采集、整理建库到后续维护与更新,形成持续演进的知识支撑体系。随着新研究成果和新实践经验的不断产生,数据基座需要通过定期采集新数据、淘汰过时信息,并结合增量更新等方式,将最新知识及时纳入模型可调用范围,从而延长其对领域大模型的有效支撑周期。结合数据质量前置化方法与数据文档化实践来看,将版本管理与质量约束嵌入数据基座设计,是实现持续演进而不失可控性的必要条件[31-32]。
在专注本领域知识深度的同时,领域大模型数据基座还需具备一定的开放性,以支持多源数据融合与跨领域知识扩展。遵循开放科学与开放数据理念,数据基座可有选择地整合政府开放数据、行业公开数据等外部资源,以拓展领域知识的广度。在实践中,数字人文与科学研究领域已通过开放数据平台实现多源数据整合,为复杂研究问题提供支撑[33]。此外,数据基座通常预留跨领域接口,当相关领域知识对本领域任务具有补充价值时,可灵活引入,从而增强模型的能力边界。开放性还体现在对通用数据标准与格式的兼容,为不同系统间的互联互通奠定基础。
(5)治理内嵌与可审计运行能力:以文档化、规范化和运维机制保障可信应用。领域大模型数据基座面向的多为高规范、高风险场景,因而其合理性不仅取决于技术性能,也取决于治理与责任机制是否能够内嵌于系统运行过程。具体而言,数据基座需要在数据登记、处理、索引与调用等环节中保留结构化文档记录,明确来源、许可、使用边界与适用场景,以支持后续的复核与责任追踪。数据集说明书(datasheets for datasets)与模型卡(model cards)所倡导的文档化思路,为数据与模型层的透明性设计提供了可直接借鉴的规范基础[32]。同时,在系统运行层面,还需通过MLOps机制将版本管理、监测、告警与回滚能力纳入统一运维流程,以保障训练—推理一体化系统在持续迭代中的稳定性与可控性[27]。此外,在高风险场景中,合规约束已逐步前置为基础设施设计条件,数据基座因此也应具备与监管框架和行业规范对接的能力[17,35]。

3 领域大模型数据基座的构成要素/Theoretical foundations for constructing the domain large model data foundation

3.1 理论基础与推导思路

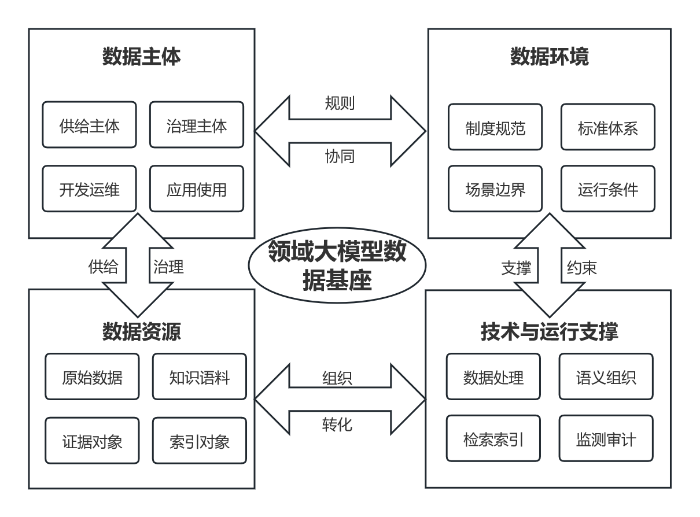
领域大模型数据基座并非单一技术对象,而是同时包含结构层级、生命周期过程、多主体协同与治理边界的复合系统。因此,本文采用四层理论分工的方式进行推导,针对训练侧与推理侧在实践中面临的训练语料组织与质量口径不一致、推理阶段证据对象不可稳定调用、来源与版本信息缺失导致责任难追溯等共性问题,先用分层模块化架构(layered modular architecture,LMA)识别数据基座的核心要素类别,再借助信息生命周期管理(information life cycle management,ILM)这一管理框架,将这些要素嵌入数据从采集、处理、存储、利用到更新的生命周期过程,随后用信息生态理论解释要素之间的协同与反馈关系,最后用质量、合规与审计约束对要素边界进行校准。基于上述理论分工与推导路径,本文依据信息生态理论的四要素框架[34]将领域大模型数据底座界定为由4类要素构成的复合系统,包括数据环境、数据主体、数据资源、技术与运行支撑,具体如图1所示。
图 1 领域大模型数据基座构成要素与关系

Figure 1 Components and relationships of the domain large model data foundation

3.2 领域大模型数据底座的构成要素

3.2.1 数据环境

在训练推理一体化场景中,数据环境是决定数据基座可运行边界的前置变量。它共同规定了哪些数据可以进入基座、以何种方式处理、在何种条件下被训练使用或推理调用,以及运行过程中需要满足哪些责任与留痕要求。
数据环境首先体现为制度与规范边界,包括法律法规、行业规则、组织制度、标准体系和安全要求等。对于领域大模型而言,这些条件直接影响训练阶段的数据采集合法性、授权边界和质量门设置,也影响推理阶段的知识调用权限、证据公开范围和输出责任划分。尤其在高风险场景中,可追溯性、风险控制和责任可识别性已经不再是后置要求,而是前置的基础设施约束[35]。这些制度性约束为数据基座的合规运行提供了前提条件,也对数据获取与利用方式产生持续影响。
数据环境同时体现为技术与运行条件。相关信息生态框架研究在环境维度中通常将政策保障、技术支持、创新环境和需求条件并置处理,并强调环境会实质性影响信息收集、存储、分析和利用效率[34]。本研究将这一思路迁移到领域大模型数据基座,检索增强、知识组织、向量数据库、联邦学习、接口治理等技术条件并非单纯工具集合,而是决定数据能否被组织为可计算、可调用知识对象的运行基础[30,36-37]。环境中的资金、人力、算力等资源的投入能力和跨机构协作机制,则进一步决定基座能否长期维护并持续更新。
此外,数据环境还包含场景化运行约束,即行业知识结构、业务流程特征和使用情境对基座设计的反向塑形。例如,医疗场景对证据等级、版本时效和责任链条的要求,法律场景对法域适用与规范层级的要求,都会转化为数据准入、元数据字段和检索策略上的差异化规则。这意味着数据基座是在共同框架下根据领域知识结构与应用需求进行实例化配置的领域化基础设施。

3.2.2 数据主体

数据主体由数据供给主体、数据治理主体、模型开发与运维主体、应用使用主体等多类角色构成,并在实际运行中呈现出角色流动与功能重叠的特征。数据供给主体主要包括医院、科研机构、行业平台、公共机构、专业组织等,负责原始数据或专业文献、规范文本、业务记录的提供与授权。数据治理主体负责准入审核、质量控制、标准维护、合规审查和文档化管理。模型开发与运维主体负责训练语料构建、知识组织、索引维护、检索与重排策略、运行评测与系统更新。应用使用主体则包括业务人员与终端用户,其行为既体现为推理调用和业务使用,也通过反馈、纠错与案例沉淀反向影响数据与模型更新。
从训练侧看,主体结构决定了数据来源的权威性、标注规范的稳定性、清洗规则的一致性以及训练边界的明确性。由于信息对象的全生命周期管理往往伴随角色、制度与场景的同步扩展,而不是仅靠单一技术系统完成[38],训练效果不仅依赖语料规模,更依赖主体间是否形成可持续的协作机制,如供给主体与治理主体对元数据规范的共识、开发主体与治理主体对质量门的共同维护等。从推理侧看,同一知识资源在不同主体配置和规则环境下,会形成不同的检索与使用模式[39],主体结构决定了知识源选择、检索证据策略、输出责任分配和反馈闭环机制。因此,领域大模型数据基座的主体结构应被界定为围绕训练与推理连续过程形成的多主体协同网络,而非单向数据供给链。

3.2.3 数据资源

数据资源是领域大模型数据基座的核心对象,但其关键在于能否在训练与推理两个阶段被分别组织为可计算、可调用、可追溯的对象。本文将数据资源区分为原始数据资源、组织后的知识语料、证据对象与索引对象3类。这一划分强调同一资源在不同阶段具有不同的对象化形式。
原始数据资源是数据基座的入口层对象,包括文档、记录、表格、图像、日志、规范文本等,可进一步区分为专业材料与通用资源两类。专业材料直接承载领域知识和业务约束,是领域模型能力形成的关键输入,如法律条文与判例、临床记录与指南、教育题库与测评数据等。通用资源则提供常识背景和跨情境语义支持,包括开放数据、统计资料和网络语料等。实践上,领域大模型通常采用专业材料为核心、通用资源为补充的配置方式,以在专业性与语言覆盖之间取得平衡[23]。在数据相对稀缺的场景中,合成数据也可作为补充来源,用于扩展指令样本和任务覆盖,但其使用边界需要通过质量与审计规则明确[40]。
组织后的知识语料是原始数据经过清洗、标准化、结构化和语义化之后形成的中间层对象,也是训练阶段与推理阶段共享的关键桥梁。这一层的重点是形成可复用的语义组织结构,如术语表、实体关系、主题分类、元数据体系、本体或知识图谱等,使跨源异构数据能够在统一语义框架下被管理和调用[41]。从训练侧看,这些语义组织结果有助于形成更稳定的语料分层、任务切分和数据配比;从推理侧看,它们则直接决定检索召回范围、重排依据和证据片段的可解释性。
证据对象与索引对象是推理运行阶段最关键的资源形态,也是数据基座区别于静态知识库的核心所在。证据对象可以理解为用于检索、回链和审计的最小可管理单元,其需要保持与原始来源的链接,并且记录处理过程和版本状态。索引对象则用于支持检索与重排,包括向量索引、倒排索引、混合检索索引及其相关元数据。这样处理后,推理阶段调用的不再是抽象知识库内容,而是具备来源、版本和处理记录的可核查对象。专家注释、纠错记录、人工评审、质量标签等辅助性资料则贯穿上述3层资源形态,为质量控制、错误修复和持续优化提供依据。由此,数据资源在基座中实现了从原始数据到知识语料、再到证据对象的连续转化。

3.2.4 技术与运行支撑要素

技术与运行支撑要素不是附属模块,而是把数据资源转化为训练能力与推理证据的中介机制。此要素不仅包含处理工具,也包含运行规则、监测机制和审计能力。
在处理与质量控制层面,技术与运行支撑要素负责完成清洗、去重、格式转换、标准化、标注、质量检测和准入控制等任务,并将质量门嵌入数据流转过程,而非在末端一次性检查。其目的在于把原始数据资源转化为可进入训练与推理流程的合格对象,并保留必要的处理记录和质量状态。
在知识组织与检索运行层面,技术与运行支撑要素承担语义建模、知识组织、索引构建、检索召回、重排与证据组装等功能。对于训练侧,这一层帮助形成面向任务和阶段的语料组织结构,为预训练、继续预训练或微调提供更清晰的数据接口。对于推理侧,这一层直接影响证据召回质量、响应稳定性和输出可解释性。特别是在领域场景中,术语一致性、概念层级、版本时效和来源标识往往比一般文本检索更关键,因此技术层必须与元数据规范、版本规则和证据对象定义协同设计。
在运行监测与审计支撑层面,技术与运行支撑要素还需要覆盖日志记录、性能监测、评测接口、版本管理、告警与回滚等机制。其作用不是增加系统复杂度,而是保证训练推理一体化系统可以在持续迭代中保持稳定和可控。对于数据基座而言,训练侧的语料版本变动、推理侧的知识源更新以及运行期产生的反馈与纠错信息,都应纳入统一的版本和日志体系,以支持问题定位、责任识别和策略调整。

4 领域大模型数据基座框架构建与分析/Overall logic of the domain large model data foundation framework

4.1 领域大模型数据基座框架构建的基础理论分析

本文将领域大模型数据基座视为一个同时包含结构层级、生命周期过程、多主体协同与治理边界的复合系统,以分层模块化架构负责结构拆分,以信息生命周期管理负责过程约束,以信息生态理论负责生态关系解释,并以质量、合规与审计要求负责边界设定。将训练阶段能力形成与推理阶段证据调用统一纳入同一数据与知识基础设施的分析框架中。
分层模块化架构是在数字平台与复杂数字系统研究中逐步发展形成的重要理论,其将数字系统理解为由层级模块性与分层模块性共同构成的混合型架构,强调稳定、可治理的核心结构与灵活、可扩展的数字层级之间的协同共存[42]。该理论关注复杂系统如何在保持整体稳定性的同时,实现功能扩展与持续创新,为理解数字系统的结构组织方式提供了重要视角。
信息生命周期管理提供了从对象进入系统到对象持续更新的过程解释框架。对象在采集与准入阶段形成来源与权限边界,在清洗与结构化阶段形成可计算状态,在组织与索引阶段形成可调用状态,在训练适配与推理调用阶段进入模型能力与证据链,在反馈与更新阶段完成版本演化与质量修正。把框架从静态分层图转化为可运行、可回流的生命周期闭环,进而解释数据基座为何能够持续支撑模型迭代与知识更新。
对领域大模型数据基座而言,数据供给主体、治理主体、模型开发与运维主体、应用使用主体并不构成线性链条,而是围绕训练与推理连续过程形成多主体协同网络。数据资源、技术设施、制度环境与使用场景之间存在持续耦合与反馈。将信息生态理论引入框架推导后,数据基座中的数据环境、数据主体、数据资源、技术与运行支撑4类构成要素能够获得更清晰的关系解释基础。
质量、合规与审计要求作为推导约束,决定了本文提出的框架必须具备可落地、可核查、可治理的属性。质量层面以FAIR原则所强调的可发现、可访问、可互操作、可复用为资源组织底线,并以数据质量模型与数据处理报告要求作为结构化质量控制依据。合规层面将风险识别、评估与治理要求嵌入数据接入、知识发布、模型调用和应用输出。审计层面则通过可追溯的来源记录、处理记录与证据回链机制,为生成结果的责任定位与复核提供基础。

4.2 领域大模型数据基座框架总体逻辑

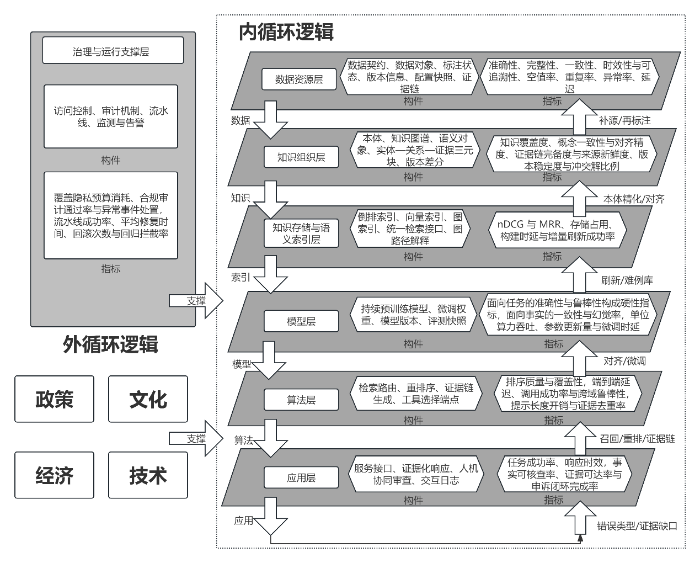
为支撑领域大模型的高质量训练与可信应用,本文在分层模块化架构[42]的基础上,构建了一个分层化、模块化、可演进的领域大模型数据基座框架(图2)。该框架以数据治理为底座,以知识组织为桥梁,以模型与算法为计算中枢,以应用服务为价值出口,并由治理与运行支撑层横向贯穿各功能层级,形成贯通数据、知识与智能服务的内外双循环演进体系。
图 2 领域大模型数据基座模型框架

Figure 2 Model framework of the domain large model data foundation

从整体结构上看,该框架遵循分层模块化架构所强调的稳定核心与灵活扩展层协同共存的混合模块化逻辑。各层设计统一遵循FAIR原则[43],以保障数据与知识资源的可发现性、可访问性、可互操作性与可复用性。同时,以ISO/IEC 25012数据质量标准[31]为依据,构建覆盖准确性、一致性、及时性与可追溯性等维度的质量控制体系,形成贯穿全生命周期的质量约束机制。
该框架针对大模型训练、推理协同设计了训练侧、推理侧与治理侧3条主线。训练侧主线以数据资源、知识组织与语义索引、模型适配为核心,强调训练语料的规范化组织、语义化处理与质量约束。推理侧主线以知识组织与语义索引、检索与重排、生成与输出为核心,强调运行阶段证据对象的稳定调用与可追溯输出。治理侧主线则通过质量控制、版本管理、日志记录与审计留痕横向贯穿上述过程,保障训练与推理在同一数据基座中的一致性与可核查性。
在分层功能上,数据资源层负责多源异构数据的采集、清洗、质量控制与合规管理,保障输入对象的稳定性与可验证性。知识组织与语义索引层负责将原始数据转化为可计算、可对齐、可检索的语义知识对象,为训练与推理提供统一的知识入口。模型与算法层作为计算中枢,通过参数化与非参数化知识协同、检索增强与推理机制,将知识转化为可验证、可审计的智能推断能力。应用层面向具体领域场景封装模型能力,并通过用户反馈与错误模式识别形成持续反向驱动。治理与运行支撑层则为各层提供版本化管理、运行监测、质量评测与审计追踪等通用支撑,保证框架在可扩展的同时保持可治理与可演进。

4.3 领域大模型数据基座框架构成分析

4.3.1 数据资源层

数据资源层在训练侧主要承担训练语料对象的采集、清洗、标注与质量控制,在推理侧主要承担检索证据源对象的准入、登记与可用性保障,其核心作用是为训练与推理提供共享但可区分的基础数据对象池。该层旨在解决训练语料与推理证据在来源、许可、版本、质量状态上的可验证问题,从而为后续知识组织、索引构建与模型调用建立统一输入边界。
数据资源层以国际通行的数据治理与质量管理规范为基础,将DAMA-DMBOK的数据域与流程视为采集、预处理、存储与共享的制度化约束,并以ISO/IEC 25012的质量维度对数据从“原始杂质态”向“可用知识态”的转化实施可量化控制。此设计确保数据谱系、可追溯性与一致性成为后续知识组织与模型训练的可验证前提,同时为模型的持续学习提供稳定分布的样本源[32]。该层对上下游提供统一的数据契约,上游采集与交换端采用带有源标记与策略元信息的事件流与批式导入机制。下游知识组织层则接收包含标注与校验状态的结构化或半结构化对象,并以版本号与变更记录(change log)的形式登记于元数据目录。在回灌路径中,清洗与去重后的数据以标准化标注格式输出,并保留采集、脱敏与取样策略的配置快照,确保知识演化与模型回溯的证据链完整,同时与PROV语义模型的实体、活动与责任主体保持可对接性。
在众多领域化场景中,科技领域与AI4S(artificial intelligence for science)可以看作数据资源层设计的一个代表性案例。在这一场景下,数据资源层在前述通用治理框架之上,引入“信息提炼—特征提炼—语义提炼”的三阶知识提炼流水线。信息提炼阶段以论文、预印本、专利、项目报告与政策文本等科技文献为对象,完成版式解析与元数据校正,识别参考文献结构和段落层级,形成字段完备、结构清晰的基础语料。特征提炼阶段围绕图表、公式、代码、实验配置等要素,对版面区域进行检测和结构重建,将嵌于文献资料与科研系统中的图像、表格及参数配置转化为可索引、可对齐的多模态特征语料。语义提炼阶段结合实体识别、关系抽取、事件抽取与观点标注,将基础语料与特征语料整合为高语义密度的知识语料,沉淀问题、方法、结果、证据链等结构化科研要素,为上游构建观点知识库、实验谱系与领域知识图谱提供输入[12]。在质量门与数据契约的约束下,上述三阶流程推动科技文献资源由可阅读的文献转变为可计算、可追溯的AI-Ready科研语料,并与后续RAG或GraphRAG管线对接,形成科学大模型与智能科研工作流的数据底座。类似的多阶段提炼思路也可以在法律、金融等领域按需实例化,如围绕法规文本或公告研报构建面向检索与推理的领域语料库。
为提升数据的透明度与可复用性,数据资源层引入Datasheets for Datasets[32]与Model Cards[44]的原则,将来源、采集、许可与使用限制前置至数据登记与版本化流程中。弱监督与主动学习机制用于降低标注成本并扩展长尾样本覆盖,结合开源标注平台与弱监督框架可形成可回放的数据生产流水线,从而实现高效的知识供给。在质量度量方面,体系遵循准确性、完整性、一致性、时效性与可追溯性五大主维度,并辅以空值率、重复率、异常率、延迟等过程性指标,以变更影响范围与版本生存期反映迭代成本。在标注阶段,通过弱监督与主动学习的性价比评估、标注密度与一致性分析衡量策略有效性,并以样本多样性与代表性控制训练偏置的累积。随着数据资源层标准化产出的高质量数据对象具备完整来源与质量凭据,知识组织层得以在概念、关系与实例层面形成可计算、可解释的知识单元,并保持源证据与变更脉络的一致映射,从而实现由“数据可用性”向“知识可用性”的跃迁。

4.3.2 知识组织层

知识组织层在训练侧主要承担语义结构化与知识对齐,在推理侧主要承担证据对象的语义组织、约束表达与可回链表示,其核心作用是把可用数据转换为可调用、可解释、可核验的知识对象。该层将训练阶段形成的知识结构与推理阶段使用的证据结构放在同一语义框架下管理,从而避免训练语义与推理证据之间的表达断裂。
知识组织层以语义网(semantic Web)与本体工程(ontology engineering)为方法论,将实体、概念、属性与关系置于统一的逻辑框架中,并承接上游“三阶知识提炼”阶段输出的基础语料、特征语料与知识语料,将其归一为统一的语义对象空间,采用RDF与OWL2[45]的建模与约束能力表达领域知识的层次、约束与推理前提,并以Linked Data[46]的发布连接实践提升知识的可复用与跨源互联能力。此层将本体与知识图谱并置,以结构化表达承载后续检索、推理与对齐任务的前提,同时通过PROV-O形式化记录事实来源与生成活动,满足“证据链”可核验性。
该层向下接收经清洗与标注的数据对象,尤其是信息提炼、特征提炼与语义提炼阶段已经形成的基础语料、特征语料和知识语料,并在导入过程中执行实体链接、术语规范化与语义对齐。向上为模型与算法提供图存取、语义查询与证据检索的统一接口。知识项以“实体—关系—证据”的三元块作为最小交换单元,附带来源、时间戳与版本标签;版本演化以语义差异为主导,提供差分包以供增量更新,并为跨库对齐给出同义映射与冲突解解算策略[47]。知识覆盖度、概念一致性与对齐精度用于刻画知识面的广度与规约一致性;证据链完备度与来源新鲜度衡量事实可核性;版本稳定度与冲突解比例反映演化过程的可控性;图查询的响应时间与路径长度则面向上层任务的可用性约束。当知识组织层以本体与图结构稳定承载领域语义后,模型层即可在“参数化记忆与非参数化记忆并用”的前提下实施知识注入与对齐,使大模型的生成行为沿语义与证据路径收敛,进而提升领域一致性与事实忠实度。

4.3.3 知识存储与语义索引层

知识存储与语义索引层在推理侧主要承担候选证据召回、重排前准备与路径解释支撑,在训练侧则承担离线检索评测、难例挖掘与样本采样支撑,其核心作用是为训练与推理提供共享的可证据化候选空间。该层将训练阶段的评测与推理阶段的在线调用统一到同一索引对象与索引生命周期管理机制中,是训练—推理一体化可落地的关键工程层。
知识存储与语义索引层面向高效检索与推理的运行需求,以多模索引体系为核心,将倒排索引、向量索引与图索引3类结构统一编排,兼顾关键词检索的稳健性、语义检索的灵活性与图推理的可解释性。在工程实现上,倒排与短文本匹配采用BM25提供强基线;语义检索依托经无监督或弱监督训练的编码器与向量数据库实现近似最近邻搜索;跨实体与跨文档的多跳关联则由图数据库承载,并对接上层的证据重组逻辑。
为实现跨域与跨任务的一致评测,系统引入BEIR等异构基准,对不同检索与重排序策略开展零样本与分域测试,并以nDCG与MRR等指标衡量排序质量[48]。本层提供统一的检索接口,输入可为查询语句或结构化意图,输出包括候选文档或实体标识、来源锚点、相似度分数与可选的图路径解释,并支持索引的构建、压缩与刷新等全生命周期管理。在指标方面,线上关注召回与延迟的平衡,线下关注跨语料与跨任务的稳健性,并以存储占用、构建时延与增量刷新成功率作为可运维性指标。本层向算法层提供可证据化的候选空间与结构约束,并将检索失败样例与难例回流至数据与知识两层以驱动语料扩充与本体精化[26]。

4.3.4 模型层

模型层在训练侧主要承担持续预训练、参数高效微调与对齐优化等能力形成任务,在推理侧主要承担与外部证据协同的生成与判别任务,其核心作用是将底座中的数据与知识对象转化为面向具体任务的可调用模型能力。该层的训练推理体化并不体现在单一算法上,而体现在训练阶段能力形成与推理阶段证据调用共享同一知识接口、版本机制与评测约束。
模型层在持续预训练与参数高效微调的框架下运行,通过LoRA这类低秩适配方法显著降低迁移成本,并以直接偏好优化作为对齐方法简化传统基于奖励模型的复杂度。此外,在训练阶段引入检索增强或检索先行的预训练路线,通过显式检索与知识接口将参数化与非参数化知识协同,减轻参数内隐记忆的失真与时效性问题。对于知识注入,采用RAG家族方法在推理时检索外部证据,既提高事实忠实度也增强可追溯性[24]。
该层对下以知识查询与证据回填为常态接口,在训练和推断阶段均可调用知识组织层的实体与文档级证据;对上以生成API与嵌入API提供任务适配能力,同时暴露模型版本、训练配方与评测快照以便算法层实施检索、重排与证据拼接。模型的变更以MLOps管线记录,可回滚的版本标签与漂移告警成为跨层协同的契约。模型层消费来自索引层的候选证据并将对齐缺陷与错误类型分布反馈至算法与数据两层,驱动检索策略与数据分布的双向调优[18]。面向任务的准确性与鲁棒性构成硬性指标,面向事实的一致性与幻觉率则决定可信性,其中可通过自一致性采样(self-consistency sampling)等一致性检测方法,对多次生成结果的一致程度进行评估,从而间接度量幻觉风险;效率侧以单位算力吞吐、参数更新量与微调时延刻画资源约束;对齐侧以偏好合格率与安全合规项通过率作为上线门槛。当模型具备与知识库的协同接口并以稳定的版本化输出对外服务后,算法层即可围绕检索、重排与推理组织证据链,并以结构化“可验证提示”驱动更高质量的推断与生成,形成从知识到生成的可审计通路。

4.3.5 算法层

算法层在推理侧主要承担检索路由、重排序、证据链组织与提示编排,在训练侧主要承担策略评测、失败样例沉淀与参数调优信号生成,其核心作用是把索引层提供的候选空间转化为模型可消费、用户可复核的结构化证据链。该层使检索、重排、生成不再是松散串联,而成为可评测、可调参、可回流的运行单元。
算法层在模型与知识之间建立高效检索与推理的联通机制,其设计依据来自检索增强生成的通行范式以及图推理增强的最新进展。在候选生成与融合上,REALM与FiD等方法为预训练或解码融合提供参考,在重排序与证据链生成上,以跨编码器重排与图路径推理联合形成多跳证据的可解释链条,进一步采用GraphRAG思路将跨实体与跨文档证据整合为提示中的显性结构。评测上,使用BEIR等异构基准与nDCG类排序指标衡量跨域泛化与证据覆盖,并以Coverage Ratio衡量证据链完整性与冗余控制之间的平衡[49]。
算法层提供统一的检索路由与工具选择端点,能够根据查询意图与上下文自动选择关键词、向量或图检索路径,并输出经重排序的证据集合与可复核的路径解释。在指标方面,除排序质量与覆盖性外,关注端到端延迟、调用成功率与跨域鲁棒性,并对提示长度开销与证据去重率进行工程级约束。算法层把结构化证据与路由决策传递给应用层,反向接收用户交互日志与失败模式以驱动召回策略与融合权重的内循环更新。

4.3.6 应用层

应用层在推理侧负责领域任务交付与人机交互,在训练侧则承担反馈采集、错误归因与需求回流入口,其核心作用是将模型与算法能力转化为可用服务,并把运行中的增量信息回灌到数据底座。该层因此既是价值出口,也是训练、推理一体化闭环中的反馈入口。
应用层面向用户与具体业务场景,将模型与算法层所形成的能力封装并呈现为可交互的智能服务形态。该层设计以高价值领域中大模型应用实践为经验基础,强调通过统一的服务接口、任务编排机制与多模态交互方式,提升模型能力在真实业务场景中的可用性与可控性。同时,在服务输出中借鉴医学问答、教育辅学与金融文本分析等成熟经验做法,体现领域场景中对专业术语、一致性与可追溯的共同要求。
在功能组织上,应用层通过统一入口对外提供会话交互、问答检索、内容生成与决策支持等服务,并采用结构化的带证据响应与人机协同审查机制,支持运行过程中的审计、复核与纠错。围绕应用运行效果,该层同时关注用户体验与可信表现两个维度的指标体系,包括任务成功率、响应时效,以及事实可核查率、证据可达率与申诉闭环完成率等,并结合领域合规要求对应用用例进行持续评估。作为系统内外循环的重要节点,应用层通过交互日志、用户反馈与人工评审结果,将错误类型、置信分布与使用偏差等信息回流至算法层与模型层,构成驱动模型优化与检索策略调整的关键增量信号。同时,将需求变更与新兴应用场景反馈至外部环境与数据治理环节,推动知识与数据资源的结构化扩充与持续演进。

4.3.7 治理与运行支撑层

治理与运行支撑层作为贯穿领域大模型数据基座各功能层级的横向支撑结构,旨在为系统的可信运行与持续演进提供统一的制度、技术与工程保障。该层以风险导向的人工智能治理框架为总体依据,结合工程化运维理念,将安全与合规要求与系统运行机制进行一体化设计,从而在保证合规可控的前提下支撑数据、知识与模型能力的持续更新。
在治理与合规方面,该层以风险识别、评估与缓释为核心逻辑,将隐私保护、访问控制与审计追踪等要求嵌入数据接入、知识发布、模型调用与应用服务等关键环节。通过策略化的访问决策与执行机制,对数据与模型资源的使用施加分级约束,并形成覆盖隐私预算消耗、合规审计通过率与异常事件处置等指标的持续监测体系。治理结果不仅对系统内部形成即时反馈,也通过审计与评估机制反向作用于制度与流程的迭代优化。
在运行与工程支撑方面,该层围绕可持续演进目标,提供面向数据与模型全生命周期的工程化保障能力。通过版本化管理、自动化流水线与统一可观测机制,实现数据加工、索引构建、模型训练与上线过程的可回放、可比对与可监控运行;并以任务成功率、回滚次数、修复时长与回归拦截率等指标,对系统运行状态进行持续评估。评测结果与运行监测信息进一步回流至模型与算法层,用以指导模型再训练、检索策略调整与系统性能优化。总体而言,治理与运行支撑层通过将合规约束、工程运维与质量评测整合为统一的横向能力体系,使领域大模型数据基座在保持结构稳定与风险可控的同时,具备持续演进与快速响应的能力,为内外循环协同运行提供制度化与工程化保障。

4.4 领域大模型数据基座框架运行逻辑

4.4.1 内循环逻辑

本框架的内循环逻辑以内在的数据生命周期与OAIS(open archival information system)参考模型为主线,并结合OECD(Organisation for Economic Co-operation and Development)提出的数据价值循环(data value cycle),对数据从采集、组织、共享、分析到使用与影响的价值流转过程进行刻画,从而形成贯通“供给—传递—利用—价值实现”的闭环运行机制。内循环以可计算溯源为约束,将数据、知识、索引、模型、算法与应用紧密耦合,形成证据驱动的生成闭环。数据资源层在完成质量与合规校验后,把携带来源与权限信息的结构化与半结构化对象传递至知识组织层,后者在本体、实例与关系的统一框架下构建可计算知识,并以可解析的持久化标识发布,作为检索与生成的统一入口与谱系映射。面向特定领域的供给与准备需要兼顾覆盖范围与质量控制,去重、过滤与再混排的流水线实践能够提升语料多样性与纯度,缓解训练中的数据瓶颈并增强稳健性,这类方法在多语预训练语料的构建中已有成效[50]。在传递与分发环节,标准化格式、语义标注与分类归纳将异构数据转化为结构化知识网络,统一的信息模型提升了互操作性与共享效率,为后续消费奠定基础[51]。
模型在利用阶段通过检索增强方法实时调用外部知识库,算法层完成候选生成、重排序与证据路径组织,应用层以带出处链接与证据片段的响应结构呈现结果。检索注入将参数化记忆与证据性语料进行耦合,能够缓解训练数据时效性不足带来的知识陈旧与幻觉问题,使生成扎根于可核验来源[20,52]。用户交互产生的日志与错误分型回流到数据与知识两层,索引层据此刷新表示与难例集合,模型层据此进行对齐与微调,算法层据此调整召回与重排策略。由此形成从证据搜集到生成再到反馈的短路径闭合,高质量数据经组织加工与模型利用转化为可审计的智能服务,任务效果与创新能力同步提升[53]。

4.4.2 外循环逻辑

外循环逻辑从制度理论与人工智能治理框架出发,强调政策法规、技术范式、经济投入与文化认同等外部因素对数据基座稳健演化的环境塑造作用。上述外部条件为内循环运行提供制度边界与发展动能,并长期持续影响其运行方式与演化路径。政策与治理通过法律法规、标准规范与制度安排明确数据开放与使用的边界,隐私保护与可追溯要求成为高风险系统的数据底线,统一的标准与监管框架提升跨机构合作的可行性并降低合规成本[54]。技术条件由基础设施与工具链共同构成,深度学习的发展依赖海量数据与算力[53],知识图谱构建、向量检索与联邦学习等技术提供自清洗、自标注与高效检索的能力,机器学习运维平台把预处理、训练与部署贯通为自动化流程,从而提升稳定性与可观测性[27,55]。
经济条件体现为资金、人力与算力的持续投入,数据采集、清洗与标注占据了相当比例的工作量,算力与平台的建设与运维成本高企,需要多源资助与产业协同以形成稳定供给[56-57]。文化与社区条件体现为开放科学与跨学科合作的氛围,数据发布、众包标注与用户反馈提高了数据可用性与知识生产效率,对内循环产生持续正向作用[58-59]。这些条件共同决定数据能否及时进入基座并保持更新效率,也决定证据是否可以稳定流入检索与生成链路。

5 领域大模型数据基座的情境化适用性论证与应用探索/Contextualized applicability argument and application exploration of the domain large model data foundation

5.1 领域大模型数据基座框架情境化适用性论证

本文采用基于公开证据的桌面研究(desk research)与跨案例对照开展演示性分析对分层化领域大模型数据基座框架及其运行机制开展情境化适用性论证。选取科技、法律、医疗、教育与金融等知识密集型领域中具有代表性的系统或模型作为参照对象,围绕各领域中具有代表性的系统或模型,系统梳理其在实践中围绕“以数据为底座、以模型为中枢、以服务为落点”的逻辑如何组织数据、构建外部知识记忆并约束生成过程进行结构化对齐(表1)。在分析过程中,将各参照对象在数据资源、知识组织、知识存储与语义索引、模型、算法、应用与治理与运行7个层面进行系统对齐,并同步讨论合规与风险要素在不同层级中的嵌入方式与作用路径。贯穿各案的共同机理是将外部结构化或半结构化知识作为非参数化记忆接入模型,通过检索增强使生成过程受证据约束,从而满足高风险与强规范场景对事实性、可核查与可追溯的要求。在逐案分析的基础上,进一步抽象并提炼出数据契约、索引配置与评测基线3类可复用工件,为该框架在不同领域间的迁移应用与后续复现提供支撑。
表1 领域大模型数据基座跨领域参照系统的情境化适用性对照

Table 1 Applicability analysis of the domain large model foundation

领域 代表系统或模型 知识底座特征 RAG应用 合规与风险要素
科技 Galactica[60]、中国科学院文献情报中心科技文献大模型[12]、星火科研助手[25]、SciAIEngine[61] 多源科技文献与情报数据,三阶知识提炼形成AI-Ready科技文献语料与观点知识库 RAG将本地化科技文献知识底座与大模型耦合,用于文献检索问答、自动综述、证据链追踪与情报分析等AI4S场景,生成过程受可核查文献证据约束 强调全文本地化长期保存与数据主权,版权、供应中断与“毒数据”偏倚
法律 Westlaw Precision[62]、Lexis+AI[63] 权威法源与引证网络 RAG或GraphRAG用于生成法律分析并暴露证据链 强调版权与合规使用,证据可审计
医疗 Med-PaLM[64]、BioMedLM[65] 循证文献与病例指南 RAG管线用于证据检索与长答案生成 注重医疗隐私和临床风险,依据事实性与共识
教育 Khanmigo[66]、Squirrel AI[67] 课程本体与题库知识图谱 RAG结合知识图谱支持解题路径与提示生成 保护学生隐私与教育伦理,确保数据安全
金融 BloombergGPT[2]、FinGPT[68] 多模态金融数据与实体关系网络 RAG与可插拔连接器支持实时行情与公告检索 监管合规与版权敏感,防止幻觉与时效性风险

5.2 领域大模型数据基座分领域情境化实例化对照

(1)科技领域中的应用分析。科技领域知识具有跨学科、多模态、高知识密度与快速演化等特征,对领域大模型数据基座在数据覆盖广度、语义精度与更新时效方面提出了较高要求。以Meta提出的Galactica为代表[60],相关研究尝试通过单一大模型在参数空间中统一“存储、组合与推理”科学知识,其训练语料集中于大规模策展的科技文献与科学数据库。从分层架构视角看,该类工作在数据资源层高度依赖权威科技语料的集中汇聚,在知识组织与语义索引层利用文献结构、引文关系与实体信息形成高密度表征,并在模型与算法层支持摘要生成、公式推导等典型 AI4S 任务。尽管幻觉风险限制了其实际应用,但相关实践表明,构建以科技文献与科学数据库为核心的知识底座,是界定科学大模型能力边界与风险水平的基础前提。相比之下,中国科学院文献情报中心在强调数据主权、安全可控与工程落地的前提下,构建了以科技文献智慧数据中心为核心的科技文献数据基座体系,并在此基础上发展出科技文献大模型、SciAIEngine与科研助手类应用[12,25,61]。上述实践通过系统化的数据治理与知识提炼,将多源科技文献转化为高语义密度、可计算的AI-Ready知识资源,并通过检索增强与知识注入机制,支撑科研问答、情报分析与学术写作等应用场景。
(2)法律领域中的应用分析。法律知识具有权威来源明确、结构严密且引证关系显性的特征,对领域大模型数据基座在来源可靠性、证据可核查性与生成透明性方面提出了较高要求。以Westlaw Precision为例,其研究功能以经编辑加工的法规与判例为知识底座,在用户提出复杂问题后,先在法源库内定位相关条文与先例,再组织分析性回答,并在结果中附带原文链接以支持核验[62]。从分层架构视角看,该系统在知识组织层实现法律术语与引证关系的结构化表达,在知识存储与语义索引层构建以主题要点与引证网络为核心的索引体系,在算法层完成候选生成与重排序,并在应用层以带来源标注的可解释回答呈现,形成证据约束的生成闭环。Lexis+AI在此基础上进一步将Shepard’s®引证服务并入生成过程[63],使引证网络同时承担检索索引与解释载体功能,可视为GraphRAG在法律场景下的工程化实践。上述案例表明,法律领域数据基座的关键不在于规模扩张,而在于权威法源的严格筛选与证据链条的完整保留。随着合规与版权相关司法实践的演进,可审计的数据基座正逐步成为智能法律服务的基础性前提。
(3)医疗领域中的应用分析。医疗领域的智能应用必须以最新循证证据为基础,并接受严格的临床评审,对领域大模型数据基座在证据权威性、时效性与风险控制方面提出了更高要求。以Med-PaLM路线为代表,相关研究围绕医师资格考试、学术文献与公共健康问答构建分层化的数据支撑体系,在评测层面将科学事实性、医疗共识、一致性与潜在风险细化为可操作的指标,并通过MedLM将研究型模型迁移至云端环境,对接机构侧病例与临床指南,形成检索、证据注入、长答案生成的应用流程[64]。BioMedLM基于大规模PubMed文献构建专门化的生物医学语义表示,并借助MeSH词表与生物医学本体实现术语与文献的语义对齐,在多项医学基准任务中取得较好表现[65]。从分层架构视角看,临床指南与医学文献在知识组织层与知识存储及语义索引层完成语义对齐与索引更新,模型与算法层执行受证据约束的生成,应用层保留来源锚点以支持核验,同时由横向的安全与合规机制控制隐私与使用风险。
(4)教育领域中的应用分析。教育领域智能应用的核心目标在于持续促进学习效果提升,而非仅提供问题答案,这对领域大模型数据基座在知识结构化、过程可解释与反馈可回溯方面提出了明确要求。以Khanmigo为代表,其导师系统将课程资源、题库与教学法知识整合为统一的数据基座,以课程大纲、知识点层级与解题路径构成教学骨架,使检索与生成过程能够沿既定教学逻辑展开。从分层架构视角看,知识组织层通过课程本体与题库图谱承载结构化教学知识,知识存储与语义索引层支持相似题目与学习路径检索,模型与算法层生成分步提示与过程性反馈,应用层汇聚师生交互并将学习结果回流至数据与知识层,形成教学驱动的内循环。类似地,松鼠AI(Squirrel AI)的自适应学习系统以知识点、先修关系、题目难度与错误类型构建细粒度知识图谱,并结合大规模学习行为数据持续推荐个体化学习任务,在多项对照研究中表现出显著学习增益[67]。该实践表明,缺乏课程本体与题库证据的结构化表达,个性化生成容易演化为不可审计的黑箱,而当证据结构、学习反馈与生成过程形成闭环时,个性化教学才能实现稳定与可控的落地。
(5)金融领域中的应用分析。金融领域知识横跨法规文本、公告研报、行情序列与公司关系网络,对领域大模型数据基座在结构化表达、时效同步与合规控制方面提出了较高要求。以BloombergGPT为例,其多任务预训练模型依托专有与公共语料,并以结构化金融数据基座为支撑,将实体关系与时间序列进行对齐,结合实时检索机制把公告与行情片段注入生成过程[2]。相较之下,FinGPT采取以数据中心为核心、轻量化适配为特征的构建路径,通过可复现的数据策展与周期性更新维持知识时效,并以参数高效微调降低行业适配成本,在应用层面以可插拔方式将行情与新闻作为外部记忆接入生成流程,实现高频数据流与模型推理的解耦协同[68]。从分层架构视角看,上述两类实践均依托结构化金融数据基座作为稳定底层,在数据资源层汇聚高频金融数据与权威文本,在知识组织与语义索引层对公司关系、事件与时间序列进行结构化建模,并在模型与算法层实现受时效约束的生成推理,最终在应用层通过来源标注与审计接口满足金融场景的合规要求。两类路径共同表明,金融领域中大模型应用的可用性高度依赖高频数据流与结构化知识基座的协同运行,以及对时效性约束与合规边界的严格控制。

5.3 可复用要素与跨域适配逻辑

在跨领域案例对比分析的基础上,本文进一步凝练出3类具有方法论意义的可复用要素,以支撑领域大模型数据基座在不同情境中的适配与迁移。其一是数据契约,用以为数据接入、组织与流通确立统一规范,涵盖数据来源标注、许可约束、版本管理与谱系信息等关键内容,并与数据表说明与模型卡片等通行做法保持一致,从而在数据资源层与知识组织层之间建立可追溯、可审计的衔接机制。其二是索引配置,作为连接知识存储和语义索引层与算法层的关键方法要素,形成可复现的索引组合策略,包括以倒排索引作为稳健基线、以向量检索作为语义补充、以图索引支撑多跳关联推理,并给出索引刷新周期、候选集规模与路径解释规则的推荐范围,以提升不同语料规模与领域条件下的迁移稳定性。其三是评测基线,贯通数据、检索、生成与系统工程4个层面,在离线阶段侧重数据完整性与一致性、排序质量与证据覆盖等指标,在在线阶段关注事实可核查率、证据可达率、端到端时延与系统稳定性,并通过在数据入库、检索放量与模型上线等关键节点设置质量门,实现阈值约束、回滚触发与复盘分析,从而保障离线评测与在线运行之间的一致性治理。
综合科技、法律、医疗、教育与金融等多个领域的数据基座实践,可以形成若干具有共识性的认识。首先,领域大模型的有效性由模型能力与数据基座质量共同决定,其中数据基座的作用不仅体现在规模层面,更体现在数据来源的权威性、知识表达的结构化程度以及引证关系的可追溯性。其次,检索增强是连接模型与数据基座的核心机制,图谱增强的引入进一步将证据链嵌入检索与生成的一体化流程,尤其适用于关系密集型与高规范要求的知识场景。再次,评测与治理构成外部环境作用于系统落地的关键抓手,尽管不同领域在事实性、可解释性与合规要求上的侧重点存在差异,但均指向以可审计的数据基座为前提的稳健应用模式。因此,本章跨领域对照显示,该框架能够以统一的7层结构解释不同领域参照系统在外部知识记忆接入、证据约束生成、合规审计输出链条上的共性机制,并将差异主要归因于权威来源、时效性与责任后果等约束轴的不同。由此形成的数据契约、索引配置与评测基线3类工件,可作为后续工程化试点或原型复现时的最小配置集合与可比较的论证口径。

6 结论与展望/Conclusion and prospect

围绕领域大模型在专业化与高风险应用场景中的数据支撑需求,本文系统梳理并论证了领域大模型数据基座的基本内涵、关键特征与构建逻辑。在分层模块化架构理论的指导下,提出了一种以数据治理为基础、以知识组织与语义索引为关键枢纽、以模型与算法为计算中枢、以应用服务为价值出口的分层化数据基座体系,并通过治理与运行支撑机制对全链路运行过程加以贯穿与约束。该体系通过检索增强与可计算溯源机制,将数据、知识与生成行为纳入统一的证据约束框架,构建起支撑可信生成的内在运行闭环,并在政策、技术与协同环境的共同作用下具备持续演进的能力。
通过对科技、法律、医疗、教育与金融等多个领域参照系统的公开证据梳理与对照分析发现,领域大模型的可用性与可信性不仅取决于模型规模与算法能力,更深度依赖数据基座的来源权威性、语义结构化程度与质量治理机制。基于此,本文进一步凝练出数据契约、索引配置与评测基线3类可复用工件,为不同领域在构建数据基座时提供可迁移的工程化路径。以FAIR原则与ISO/IEC 25012为质量基线的质量指标体系与分阶段质量控制机制,有助于实现离线治理与在线运行的一致性,为高风险与强规范场景下的大模型应用提供可审计、可回滚的治理基础。
同时,领域大模型数据基座的建设与落地仍面临多方面挑战。一方面,不同领域在数据开放程度、知识结构形态与合规要求上的显著差异,使得数据基座难以形成高度统一的实现范式,相关设计仍需结合具体领域情境加以调整;另一方面,数据的持续更新、知识的动态演化与模型的迭代优化之间,如何形成稳定、可扩展的协同机制,仍有待在长期运行实践中进一步检验。未来研究可在更细粒度的领域场景中,对数据基座的运行效果与治理绩效开展系统性的实证评估,深入探讨标准化方法要素与治理机制在跨机构、跨平台环境下的协同方式,并结合开放评测基准与参考性实现路径,推动领域大模型数据基座由概念框架与方法探索,逐步走向可复现、可扩展的规模化应用。
[1]
国务院. 国务院关于深入实施“人工智能+”行动的意见[J]. 中华人民共和国国务院公报, 2025(25):16-20.

The State Council of the People’s Republic of China. Opinions of the State Council on deeply implementing the “Artificial Intelligence+” action[J]. Gazette of the State Council of the People’s Republic of China, 2025(25):16-20.

[2]
WU S, IRSOY O, LU S, et al. BloombergGPT: a large language model for finance[EB/OL]. [2026-01-08].

[3]
刘学博, 户保田, 陈科海, 等. 大模型关键技术与未来发展方向——从ChatGPT谈起[J]. 中国科学基金, 2023, 37(5):758-766.

LIU X B, HU B T, CHEN K H, et al. Key technologies and future development directions of large language models: insights from ChatGPT[J]. Bulletin of National Natural Science Foundation, 2023, 37(5):758-766.

[4]
FROST & SULLIVAN CHINA. 数据基础设施白皮书[R]. 北京: Frost & Sullivan China, 2024.

FROST & SULLIVAN CHINA. White paper on data infrastructure[R]. Beijing: Frost & Sullivan China, 2024.

[5]
中国信息通信研究院. 2024年中国大模型行业应用优秀案例白皮书[R]. 北京: 中国信息通信研究院, 2024.

China Academy of Information and Communications Technology. White paper on excellent industry application cases of large models in China (2024)[R]. Beijing: China Academy of Information and Communications Technology, 2024.

[6]
ALBER D A, YANG Z, ALYAKIN A, et al. Medical large language models are vulnerable to data-poisoning attacks[J]. Nature medicine, 2025, 31(2):618-626.

[7]
CHEN H, CHEN H, ZHAO Z, et al. An overview of domain-specific foundation model: key technologies, applications and challenges[EB/OL]. [2026-01-08].

[8]
GUHA N, NYARKO J, HO D, et al. LegalBench: a collaboratively built benchmark for measuring legal reasoning in large language models[J]. Advances in neural information processing systems, 2023, 36:44123-44279.

[9]
JIANG Y, FENG C M, REN J, et al. Privacy-preserving federated foundation model for generalist ultrasound artificial intelligence[EB/OL]. [2026-01-08].

[10]
KE Y H, JIN L, ELANGOVAN K, et al. Retrieval augmented generation for 10 large language models and its generalizability in assessing medical fitness[J]. NPJ digital medicine, 2025, 8(1):187.

[11]
PANG Z, WANG C, ZHAO L, et al. Cross-modality hierarchical clustering and refinement for unsupervised visible-infrared person re-identification[J]. IEEE transactions on circuits and systems for video technology, 2024, 34(4):2706-2718.

[12]
钱力, 刘志博, 刘细文, 等. 科技文献数据资源建设模式数智化转型研究——中国科学院文献情报中心的实践探索[J]. 图书情报工作, 2025, 69(10):4-13.

QIAN L, LIU Z B, LIU X W, et al. Research on digitalization and intelligentization transformation of scientific and technological literature data resources construction: practical exploration of National Science Library, CAS[J]. Library and information service, 2025, 69(10):4-13.

[13]
ALZUBAIDI L, BAI J, AL-SABAAWI A, et al. A survey on deep learning tools dealing with data scarcity: definitions, challenges, solutions, tips, and applications[J]. Journal of big data, 2023, 10(1):46.

[14]
SONG Z, ZHANG W, DENG L, et al. Mitigating negative transfer in cross-domain recommendation via knowledge transferability enhancement[C]//Proceedings of the 30th ACM SIGKDD conference on knowledge discovery and data mining. New York: ACM, 2024:2745-2754.

[15]
DAMA INTERNATIONAL. DAMA-DMBOK: data management body of knowledge[M]. 2nd revised ed. Basking Ridge: Technics Publications, 2024.

[16]
JACOBSEN A, DE MIRANDA AZEVEDO R, JUTY N, et al. FAIR principles: interpretations and implementation considerations[J]. Data intelligence, 2020, 2(1/2):10-29.

[17]
BUSCH F, KATHER J N, JOHNER C, et al. Navigating the European Union artificial intelligence act for healthcare[J]. npj Digital Medicine, 2024, 7(1):210.

[18]
LEWIS P, PEREZ E, PIKTUS A, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks[J]. Advances in neural information processing systems, 2020, 33:9459-9474.

[19]
HU Y, LU Y. RAG and RAU: a survey on retrieval-augmented language model in natural language processing[EB/OL]. [2026-01-08].

[20]
AMUGONGO L M, MASCHERONI P, BROOKS S, et al. Retrieval augmented generation for large language models in healthcare: a systematic review[J]. PLOS digital health, 2025, 4(6):e0000877.

[21]
颜航, 高扬, 费朝烨, 等. 基座模型训练中的数据与模型架构[C]// 第二十二届中国计算语言学大会论文集(卷2:前沿综述).哈尔滨: 中国中文信息学会计算语言学专业委员会,2023:1-15.

YAN H, GAO Y, FEI C, et al. Data and model architecture in base model training[C]//Proceedings of the 22nd Chinese national conference on computational linguistics (volume 2: frontier forum). Harbin: Chinese Information Processing Society of China, 2023:1-15.

[22]
SONG Z, YAN B, LIU Y, et al. Injecting domain-specific knowledge into large language models: a comprehensive survey[EB/OL]. [2026-01-08].

[23]
RAFFEL C, SHAZEER N, ROBERTS A, et al. Exploring the limits of transfer learning with a unified text-to-text transformer[J]. Journal of machine learning research, 2020, 21(140):1-67.

[24]
GURURANGAN S, MARASOVIĆ A, SWAYAMDIPTA S, et al. Don’t stop pretraining: adapt language models to domains and tasks[EB/OL]. [2026-01-08].

[25]
钱力, 张智雄, 伍大勇, 等. 科技文献大模型:方法、框架与应用[J]. 中国图书馆学报, 2024, 50(6):45-58.

QIAN L, ZHANG Z X, WU D Y, et al. The large language model for scientific literature: method, framework, and application[J]. Journal of library science in China, 2024, 50(6):45-58.

[26]
THAKUR N, REIMERS N, RÜCKLÉ A, et al. BEIR: a heterogeneous benchmark for zero-shot evaluation of information retrieval models[EB/OL]. [2026-01-08].

[27]
KREUZBERGER D, KÜHL N, HIRSCHL S. Machine learning operations (MLOps): overview, definition, and architecture[J]. IEEE access, 2023, 11:31866-31879.

[28]
FREIDEL S, SCHWARZ E. Knowledge graphs in psychiatric research: potential applications and future perspectives[J]. Acta psychiatrica scandinavica, 2025, 151(3):180-191.

[29]
JI S, PAN S, CAMBRIA E, et al. A survey on knowledge graphs: representation, acquisition, and applications[J]. IEEE transactions on neural networks and learning systems, 2022, 33(2):494-514.

[30]
GAO S, YU K, YANG Y, et al. Large language model powered knowledge graph construction for mental health exploration[J]. Nature communications, 2025, 16(1):7526.

[31]
GUERRA-GARCÍA C, NIKIFOROVA A, JIMÉNEZ S, et al. ISO/IEC 25012-based methodology for managing data quality requirements in the development of information systems: toward data quality by design[J]. Data & knowledge engineering, 2023, 145:102152.

[32]
GEBRU T, MORGENSTERN J, VECCHIONE B, et al. Datasheets for datasets[J]. Communications of the ACM, 2021, 64(12):86-92.

[33]
DI BUONO M P, NOLANO G, MONTI J. NEAT—Named Entities in Archaeological Texts: a semantic approach to term extraction and classification[J]. Digital scholarship in the humanities, 2023, 38(3):997-1013.

[34]
唐悦, 马海群. 基于信息生态理论的云边协同数智专利情报服务框架构建[J]. 情报科学, 2025, 43(7):162-171.

TANG Y, MA H Q. Constructing a cloud-edge collaborative digital-intelligent patent intelligence service framework based on information ecology theory[J]. Information science, 2025, 43(7):162-171.

[35]
HUTSON M. Rules to keep AI in check: nations carve different paths for tech regulation[J]. Nature, 2023, 620(7973):260-263.

[36]
TAIPALUS T. Vector database management systems: fundamental concepts, use-cases, and current challenges[J]. Cognitive systems research, 2024, 85:101216.

[37]
BHARATI S, MONDAL M R H, PODDER P, et al. Federated learning: applications, challenges and future directions[J]. International journal of hybrid intelligent systems, 2022, 18(1-2):19-35.

[38]
徐淋楠, 邵波. 近30年图情领域ILM理论研究:热点演进、范式归纳与进路展望[J]. 图书馆理论与实践, 2022(5):9-15.

XU L N, SHAO B. Theoretical research on ILM in library and information science field in the past 30 years: hotspot evolution, paradigm induction and forward prospect[J]. Library theory and practice, 2022(5):9-15.

[39]
黄微, 刘逸伦, 周东阳. 基于信息生态理论的突发事件网络舆情多平台演化路径及实证研究[J]. 情报杂志, 2025, 44(9):164-175.

HUANG W, LIU Y L, ZHOU D Y. Empirical study on the multi-platform evolution path of online public opinion in emergency incidents based on the information ecology theory[J]. Journal of intelligence, 2025, 44(9):164-175.

[40]
ADLER B, AGARWAL N, AITHAL A, et al. Nemotron-4 340B technical report[EB/OL]. [2026-01-08].

[41]
TANG X, FENG Z, XIAO Y, et al. Construction and application of an ontology-based domain-specific knowledge graph for petroleum exploration and development[J]. Geoscience frontiers, 2023, 14(5):101426.

[42]
HYLVING L, SCHULTZE U. Accomplishing the layered modular architecture in digital innovation: the case of the car’s driver information module[J]. The journal of strategic information systems, 2020, 29(3):101621.

[43]
WILKINSON M D, DUMONTIER M, AALBERSBERG I J, et al. The FAIR guiding principles for scientific data management and stewardship[J]. Scientific data, 2016, 3(1):160018.

[44]
MITCHELL M, WU S, ZALDIVAR A, et al. Model cards for model reporting[C]//Proceedings of the conference on fairness, accountability, and transparency. New York: ACM, 2019:220-229.

[45]
W3 Working Group C OWL. OWL 2 Web Ontology Language document overview: W3recommendationC 27 October 2009[EB/OL]. [2026-01-08].

[46]
WOOD D, ZAIDMAN M, RUTH L, et al. Linked data[M]. Shelter Island: Manning Publications, 2014.

[47]
PAULHEIM H. Knowledge graph refinement: a survey of approaches and evaluation methods[J]. Semantic Web, 2017, 8(3):489-508.

[48]
RATNER A, BACH S H, EHRENBERG H, et al. Snorkel: rapid training data creation with weak supervision[J]. Proceedings of the VLDB Endowment, 2017, 11(3):269-282.

[49]
GUU K, LEE K, TUNG Z, et al. Retrieval-augmented language model pre-training[C]//Proceedings of the 37th international conference on machine learning. PMLR, 2020:3929-3938.

[50]
李兴腾, 冯锋, 黄鹂强. 突破人工智能大模型的“数据瓶颈”——构建国家级语料库运营平台的思考[J]. 中国科学院院刊, 2025, 40(3):522-529.

LI X T, FENG F, HUANG L Q. Breaking through the “data bottleneck” of AI large models—Reflections on building a national corpus operation platform[J]. Bulletin of Chinese Academy of Sciences, 2025, 40(3):522-529.

[51]
SUTTON R T, PINCOCK D, BAUMGART D C, et al. An overview of clinical decision support systems: benefits, risks, and strategies for success[J]. NPJ digital medicine, 2020, 3:17.

[52]
GENOVESE A, PRABHA S, BORNA S, et al. From data to decisions: leveraging retrieval-augmented generation to balance citation bias in burn management literature[J]. European burn journal, 2025, 6(2):28.

[53]
BHATT N, BHATT N, PRAJAPATI P, et al. A data-centric approach to improve performance of deep learning models[J]. Scientific reports, 2024, 14(1):22329.

[54]
ASHRAF Z A, MUSTAFA N. AI standards and regulations[M]//QIDWAI M A, ed. Intersection of human rights and AI in healthcare. Hershey: IGI Global, 2025:325-352.

[55]
SENJYU T, SO-IN C, JOSHI A, et al. Smart trends in computing and communications: proceedings of SmartCom 2023, volume 1[C]. Singapore: Springer, 2023.

[56]
中国信息通信研究院. 数据要素价值稳步释放——数据要素白皮书(2023年)摘编[J]. 企业管理, 2024(1):46-52.

China Academy of Information and Communications Technology. Steady release of data element value—excerpt from the white paper on data elements (2023)[J]. Business management, 2024(1):46-52.

[57]
MARTENS B. The tension between exploding AI investment costs and slow productivity growth[R]. Brussels: Bruegel, 2024.

[58]
ZILIOLI M, LANUCARA S, OGGIONI A, et al. Fostering data sharing in multidisciplinary research communities: a case study in the geospatial domain[J]. Data science journal, 2019, 18:15.

[59]
NEURIPS 2021 Data-Centric AI Workshop. Data-centric AI[EB/OL]. [2026-01-08].

[60]
TAYLOR R, KARDAS M, CUCURULL G, et al. Galactica: a large language model for science[EB/OL]. [2026-01-08].

[61]
中国科学院文献情报中心. 科技文献知识人工智能引擎(SciAIEngine)[EB/OL]. [2026-01-08].

National Science Library, Chinese Academy of Sciences. Scientific literature knowledge artificial intelligence engine (SciAIEngine)[EB/OL]. [2026-01-08].

[62]
THOMSON REUTERS. Generative AI legal research | Westlaw Precision | Thomson Reuters[EB/OL]. [2026-01-08].

[63]
FIDLER K L. Lexis+: to buy or not to buy... that is the question[J]. Australian law librarian, 2024, 32(2):31-33.

[64]
SINGHAL K, TU T, GOTTWEIS J, et al. Toward expert-level medical question answering with large language models[J]. Nature medicine, 2025, 31(3):943-950.

[65]
BOLTON E, VENIGALLA A, YASUNAGA M, et al. BioMedLM: a 2.7B parameter language model trained on biomedical text[EB/OL]. [2026-01-08].

[66]
SHETYE S. An evaluation of Khanmigo, a generative AI tool, as a computer-assisted language learning app[J]. Studies in applied linguistics and TESOL, 2024, 24(1).

[67]
HAO K. China has started a grand experiment in AI education. It could reshape how the world learns[EB/OL]. [2026-01-08].

[68]
LIU X Y, WANG G, YANG H, et al. FinGPT: democratizing internet-scale data for financial large language models[EB/OL]. [2026-01-08].

文章导航

/

〈 〉