研究论文

数据要素视角下AI赋能图书馆读者服务优化路径研究

  • 邹凯 1 ,
  • 谭欣宇 , 1 ,
  • 傅立云 2 ,
  • 蒋知义 3
展开
  • 1.湘潭大学公共管理学院 湘潭 411105
  • 2.湘潭大学技术转移中心 湘潭 411105
  • 3.湘潭大学图书馆 湘潭 411105
谭欣宇,硕士研究生,E-mail:

邹凯,教授,博士,博士生导师

傅立云,技术转移中心副主任,副研究馆员,硕士,硕士生导师

蒋知义,研究馆员,硕士,硕士生导师。

收稿日期: 2025-04-16

  网络出版日期: 2025-09-11

基金资助

湖南省教育厅科学研究项目“数字乡村背景下基层图书馆公共文化服务满意度测评研究”(22A0086)

Research on the Optimization Path of AI Empowering Library Reader Service from the Perspective of Data Elements

  • Zou Kai 1 ,
  • Tan Xinyu , 1 ,
  • Fu Liyun 2 ,
  • Jiang Zhiyi 3
Expand
  • 1. School of Public Administration, Xiangtan University, Xiangtan 411105
  • 2. Technology Transfer Center, Xiangtan University, Xiangtan 411105
  • 3. Xiangtan University Library, Xiangtan 411105
Tan Xinyu, Master’s Candidate, Email:

Zou Kai, Professor, PhD, Doctoral Supervisor;

Fu Liyun, Deputy Director of Technology Transfer Center, Associate Research Librarian,Master, Master’s Supervisor;

Jiang Zhiyi, Research Librarian, Master, Master’s Supervisor.

Received date: 2025-04-16

  Online published: 2025-09-11

Supported by

Fund project(s): This work is supported by the scientific research project of Department of Education of Hunan Province titled "Evaluation Research on Public Cultural Service Satisfaction of Grassroots Libraries under the Background of Digital Countryside"(22A0086)

摘要

【目的/意义】 明确数据要素视角下AI赋能图书馆读者服务优化路径,为图书馆更有效地利用AI进行数智化转型,促进图书馆价值释放提供建议。 【方法/过程】 从数据要素视角出发,基于数据价值链理论、信息生态理论和感知价值理论,通过扎根访谈提取相关影响因素,并根据提取的15个范畴使用模糊解释结构模型(Fuzzy-ISM),划分三级影响路径,结合交叉影响矩阵相乘法(MICMAC)分析识别独立群、依赖群等集群特征。 【结果/结论】 确定数据主体、数据环境、数据本体三维度15个要素的影响路径,确立数据存储与技术设施构成的底层独立群是服务优化的根源驱动,通过影响其他要素进而影响用户的感知价值,从而实现价值闭环,据此提出分层施策建议,为图书馆“数据—价值”转化提供思路。
本文引用格式

邹凯 , 谭欣宇 , 傅立云 , 蒋知义 . 数据要素视角下AI赋能图书馆读者服务优化路径研究[J]. 知识管理论坛, 2025 , 10(5) : 397 -414 . DOI: 10.13266/j.issn.2095-5472.2025.026

Abstract

[Purpose/Significance] This study aims to clarify the optimization path of library reader service empowered by AI from the perspective of data elements, and to provide suggestions for libraries to make more effective use of AI for digital intelligent transformation and promote the release of library value. [Method/Process] Guided by the data value chain theory, information ecology theory and perceived value theory, relevant influencing factors were extracted through grounded interviews from the perspective of data elements, and Fuzzy-ISM was used to divide the three-level influencing paths according to the extracted 15 categories. The characteristics of independent group and dependent group were identified by MICMAC analysis. [Result/Conclusion] The influence path of 15 factors in three dimensions of data subject, data environment and data ontology was determined, and the underlying independent group composed of data storage and technical facilities was established, which was the root driving force of service optimization. By influencing other factors, users' perceived value was affected, so as to achieve a closed loop of value. It provides ideas for the transformation of "data-value" in library.

1 引言/ Introduction

随着数字经济的快速发展,数据作为一种新型生产要素,其重要性愈发凸显。《数据二十条》[1]、《“数据要素×”三年行动计划(2024—2026年)》[2]、《中共中央关于进一步全面深化改革、推进中国式现代化的决定》[3]等国家政策的颁布落地,数据要素市场的建设与发展被提上日程,这些政策旨在通过优化数据资源配置,促进经济结构转型升级。在这一背景下,人工智能(artificial intelligence,AI)技术的迅速进步,特别是生成式人工智能(generative artificial intelligence,GAI)的兴起,不仅提升了内容生产的效率和质量,而且在内容生成、用户交互、个性化推荐和资源管理等领域展现出巨大的潜力,同时通过智能化服务创新,推动了图书馆、档案馆、博物馆等文化记忆机构的数字化转型[4]。根据第二十一次全国国民阅读调查,我国2023年城镇成年居民对公共图书馆的使用满意度为78.7%[5],人工智能的加入使图书馆检索方式向智能化检索转型——通过构建知识储备平台,推送较为准确的答案,提高用户满意度[6]。
Web 3.0时代以来,图书馆用户服务不仅关注资源的数字化,更加关注用户体验以及智能服务[7],因此,图书馆作为信息资源以及公共服务提供的集散地应积极适应数字化转型,充分利用数据要素,探索如何通过AI技术来提升图书馆读者服务效果和质量。然而,由于AI应用于图书馆读者服务还处于发展初期阶段,在应用过程中还存在效果优化路径不明、AI服务质量优劣难辨等问题,因此,如何实现AI赋能图书馆读者服务效果的全面提升,建设高质量数据集推动AI赋能行业蓬勃发展成为当前亟待解决的问题。本文从数据要素视角出发,探寻AI技术在图书馆读者服务中的具体应用场景,分析其在提升服务效果方面的实际作用,并结合数据要素的特性,提出针对性的优化策略,以期为图书馆数字化转型以及服务效果优化提供理论支撑和实践指导。

2 文献综述/Literature review

2.1 图书馆读者服务相关研究

图书馆读者服务作为图书馆核心功能之一,早在20世纪20年代就开始发展并受到美国公共图书馆重视,当时主要指图书馆员为了满足读者的阅读需求,了解读者的阅读状况和目的,并据此提供阅读建议的服务[8]。随着信息技术的快速发展和用户需求的不断变化,图书馆读者服务也由传统服务[9]向信息服务[10]、个性化服务[11]和智能化应用[12]转型,聚焦于利用信息技术提升读者服务的效率与质量,建设智慧图书馆,实现以读者为中心,更好地向读者服务[13]。如今图书馆读者服务由于AI的接入,其概念得到了延展,一部分学者将其称为“智慧服务”,智慧服务不仅包括传统的文献借阅和咨询服务,还通过整合大数据、人工智能等先进技术,围绕用户需求提供个性化、实时互动的服务模式,通过数据分析优化服务流程,提升用户体验和满意度[14]。同时,智慧服务具备持续改进的特性,能够根据用户反馈和市场变化不断调整服务内容,以适应动态环境。这种服务模式不仅提高了服务效率,也促进了用户与服务提供者之间的深度互动[15]。随着智慧服务概念的深入发展,有部分学者开始研究智慧服务背景下读者数据安全及风险治理[16],对智慧服务中可能存在的风险进行阐述,并提出优化的治理策略。图书馆读者服务相关研究主要集中在图书情报领域,其次是计算机科学领域。在图书情报领域,关于图书馆读者服务的研究占据了相当大的比重,这些研究主要集中在参考咨询[17]、服务创新[18]、阅读推广[19]、服务质量评估[20],以及针对特定用户群体,如老年人[21]和残障人士[22]的个性化服务研究。而在计算机科学领域,研究则更多关注数据驱动的方法,探讨在数字技术支持下读者服务模式如何变革[23],研究者试图通过大数据、人工智能等技术手段,优化服务流程[24],提升用户体验,分析用户需求与行为,以满足不同群体的个性化需求。总体而言,图书馆读者服务包括多个层次,学者们主要从参考咨询服务、文献借阅服务、信息素养培训、数字资源访问、读者活动与阅读推广、特殊群体服务、反馈与评估、个性化服务以及技术支持等方面对图书馆读者服务进行研究。

2.2 数据要素相关研究

在数字经济时代,数据已经不仅仅充当信息的载体,它是能产生经济效益的数据资源,是数字时代的“石油”,将逐步融入传统行业生产、应用、服务的全流程当中,作为继劳动力、土地、资本、技术之后的第五大生产要素,将为社会创造极大的再生价值[25]。相关基于科学计量知识图谱的研究表明,我国数据要素研究起源于1999年,数量呈现逐年递增的状态,目前相关研究围绕数据要素政策[26]、数字技术、数据安全与治理[27]、数据资产入表[28]等方面,以求实现数据赋能经济增长以及生产力变革。从数据要素利用的角度出发,可以将目前研究分为:数据要素市场、数据要素价值以及数据开放与共享。从数据要素市场来看,面对市场治理体系不完善、运行机制不明等问题,有学者借鉴传统要素市场成熟制度优势,认为数据要素市场也需要完善的要素要件,如供需机制、定价机制、产权机制和监管机制等搭建数据要素市场平台,反映市场价值规律,促使市场内部稳定[29]。从数据要素价值来看,其价值划分包括三阶段:资源化、资产化、资本化,对于图书馆而言,因其还未将大数据资源整合成系统化的资源地,数据要素价值还处于资源化阶段,要实现价值跃迁,实现智能化服务,还需进一步整合、释放分散的图书馆数据价值,而数据要素价值释放需要对数据进行定价和确权,并需要完备的数据要素市场为基础[30]。为解决数据市场的定价问题,有研究利用机器学习训练数据模型[31]或是应用于区块链数据市场的博弈论智能定价算法[32]作为估计价格的方法,但是尚未形成统一的定价模式。从数据开放与共享来看,目前主要的问题是社会上数据量极大但数据流通受阻[33],数据开放共享平台运维技术问题可能导致数据泄露等安全问题[34],面对这些问题,有学者指出通过政府主导数据开放共享、公共数据授权运营、刺激数据跨部门流通[35]、构建可信数据空间[36]、数据信托[37]等方式探索数据开放共享合理合规路径,实现数据“供得开、流得动、用得好、保安全”。

2.3 人工智能相关研究

人工智能(AI)自1956年被提出以来,因其强大的学习和泛化能力被越来越多地应用于各种场景。随着大数据、云计算技术的广泛应用,人工智能的研究也迎来新的发展:作为底层技术的通用大模型迭代升级、各类垂直领域的大模型迅速成长以及多模态数据处理能力提升拓宽了“人工智能+”应用场景[38]。AI大模型的应用使得DeepSeek、ChatGPT类生成式人工智能成为推动技术革新的新兴信息资源,较传统用户生成内容(user generated content,UGC)、专业生成内容(professional generated content,PGC)等信息资源更加迅速、便捷[39]。但是因AI技术训练而产生AI伦理、数据泄露、内容不安全以及数据来源不明等问题[40],使得研究者们不仅关注AI赋能技术变革产生的经济价值和市场价值[41],也开始焦虑AI服务使用过程中的数据治理以及风险监管[42]。近几年人工智能在图书情报领域的研究集中在以下3个方面:①AI技术应用方面,研究集中在构建人工智能素养框架[43],提升数字素养[44];AI作用于技术、空间、服务、管理等层面,通过赋能图书馆智能检索及咨询服务等赋能智慧图书馆[45];基于多方参与的人工智能满意度研究[46];大模型技术实际场景应用[47]。②风险感知方面,通过扎根访谈、文献回顾以及量化分析等方式对AI工具使用风险进行分析,主要体现在使用AI产品方面,例如对使用图书馆AI馆员系统时的服务质量、信息安全、技术依赖等方面的焦虑,有研究从风险感知维度对ChatGPT用户风险感知建立影响机理模型,并从数据研发及监管等方面为风险治理提出优化策略[48]。③风险治理方面,通过对智慧图书馆建设[49]、AIGC国际规则博弈分析[50]及隐私保护技术[51]等方面进行研究,探寻不同场景及视角下风险治理面临的困境并提出相应解决策略。

2.4 相关研究述评

综上所述,目前AI在图书馆读者服务领域的应用研究十分广泛,图书情报领域研究内容聚焦于体系构建、应用前景、风险治理及个性化服务等方面,研究对象主要包括AI对读者服务本身的影响,以及对老年群体与残障人士服务的创新路径探索。读者服务路径研究方面,研究者主要聚焦于增值路径的再选择,而研究数据要素视角下和AI情境下图书馆读者服务优化的文章较少。另外,AI的运作依托大量数据,其正从以模型为中心逐步转变为以数据为中心,鉴于图书馆目前处于数据要素资源化阶段,海量文献数据、用户数据、管理数据价值等亟待进一步挖掘,从数据要素视角出发,能够以一个全新的视角更全面地理解AI在图书馆读者服务应用中的挑战与机遇,以及了解如何通过数据的优化来提升服务效率,助力图书馆数据向更深层应用迈进。探讨如何高效利用并优化人工智能技术,明确其作用机制,对实现技术赋能图书馆读者服务,推动图书馆在数字经济时代实现高质量发展具有重要的理论和实践价值,为今后图书馆读者服务效率优化定量分析研究提供基础。鉴于此,本研究以AI情境下的图书馆服务为研究对象,从数据要素的视角出发,结合相关文献以及实际案例,深入剖析AI如何优化读者服务效果,以期为图书馆智慧化转型提供理论支持和实践指导。

3 理论基础/Theoretical foundation

数据价值链理论由H. G. Miller等在价值链理论的基础上提出,目前国内外学者大多从数据生命周期的角度来定义数据价值链理论,将其概括为数据产生到利用,即产生价值的一系列环节[52]。AI在图书馆读者服务中数据价值实现的过程可以概括为产业数字化到数字产业化的过程,即AI产品在图书馆读者使用过程中,由用户需求输入到数据分析、算法优化从而更好地赋能用户的过程。
信息生态理论在图书情报领域应用广泛,被用于研究用户信息行为以及资源优化管理等方面,信息生态系统通常由信息、信息人、信息环境构成,在信息技术影响较大的场景中,部分学者将信息技术要素纳入信息生态系统[53]。而数据要素市场也可被视为一种信息生态系统[54],因此,基于信息生态理论,引入信息生态系统三要素,可以将“数据”生态系统分为:数据本体、数据主体和数据环境。
在用户行为意愿相关研究中,感知价值是指用户在衡量机构服务收益与成本后的综合评价,其与用户满意度及持续使用意愿紧密相关。一般将其划分为社会价值、认知价值、情感价值、功能价值、感知成本价值5个维度,有学者在对图书馆用户满意度相关研究中将其分为感知质量价值、感知现实价值、感知阅读价值和感知社会价值[55],因此研究读者服务可以以感知价值理论为切入点,对其效果优化路径进行研究。
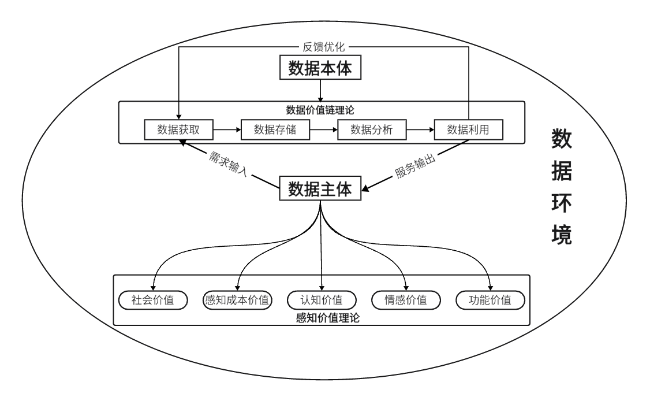
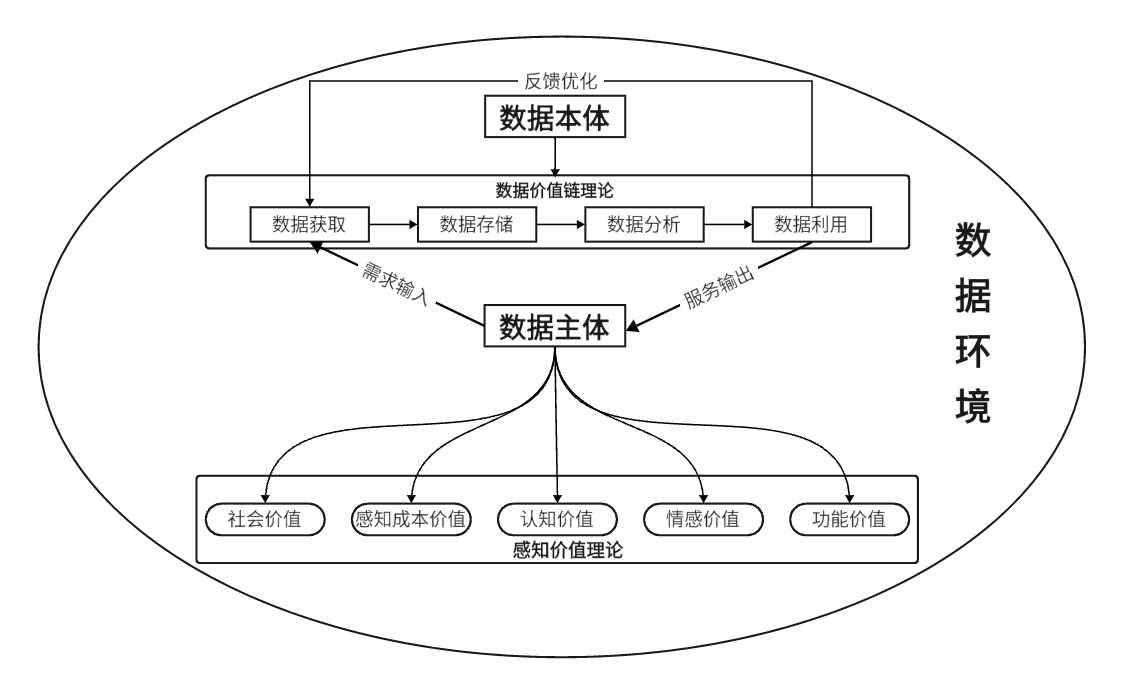
因此,笔者从数据要素利用的角度出发,以数据价值链理论、感知价值理论及信息生态理论为基础,利用“数据”生态系统三要素搭建AI赋能图书馆读者服务主框架,通过数据价值链,深入分析AI赋能的读者服务数据从产生、流转到利用的全生命周期,结合感知价值理论试图阐释人工智能如何在数据驱动下革新图书馆读者服务,并构建AI赋能图书馆读者服务的初步理论框架,见图1。
图1 AI赋能图书馆读者服务理论框架

Figure 1 Theoretical framework of AI empowering library reader services

在本文语境中数据主体是指图书馆工作人员、AI系统以及图书馆读者。数据本体涉及馆藏资源、用户行为数据及互动反馈数据,馆藏资源元数据包括图书、期刊等数字资源在内的详细信息,用户行为数据包括阅读习惯、借阅记录、查询数据、访问统计等,这些数据可以用来分析用户的需求及偏好,互动反馈数据包括AI在线问答用户问题解决程度及满意度、读者通过意见反馈等渠道提供的信息,用于评估服务质量和改进措施。数据环境指数据产生和运用所依赖的内外部条件,主要包括技术基础设施、政策和法规及社会文化背景。

4 研究设计/Research design

4.1 研究方法

扎根理论是一种质性研究方法,是通过访谈等方式对存在的社会现象和社会问题进行研究的过程,通过对数据分层编码,可以从被访者的视角出发,透过被访者的经验数据提炼出相关理论框架,从而发现研究的本质,减少研究者主观影响,其核心在于通过不断比较和迭代分析自下而上归纳出符合现象规律的理论。利用扎根理论研究数据时代AI赋能图书馆读者服务可以做到研究对象与研究方法的契合,继而有效地获取AI赋能图书馆读者服务影响路径。
模糊解释结构模型(fuzzy-interpretative structural modeling,Fuzzy-ISM)常用于路径研究,以解决复杂要素间的关联问题,交叉影响矩阵相乘法(matrices impacts croises-multiplication appliance classement,MICMAC)分析可对因素进行分类与关键因素识别,将Fuzzy-ISM方法应用于复杂的图书馆读者服务研究中,能够清晰刻画不同要素之间的因果关系,揭示数据要素在AI赋能服务中的关键作用及其传导机制,从而帮助研究者理解系统中潜在的结构性关联,进而通过MICMAC方法优先关注对AI赋能服务效果影响最大的关键数据要素,从而指导资源配置与策略制定。采用Fuzzy-ISM对扎根理论提炼出的影响路径进行层次关系分析,并通过建立邻接矩阵及可达矩阵,形成多级递接结构模型,以明晰各路径之间的关联性。最后,基于MICMAC对要素相互影响的评估,识别关键性驱动因素,从而进一步提升模型的合理性。

4.2 数据收集

扎根理论主要通过访谈获取研究数据,在访谈提纲设计方面,通过查阅相关文献资料、浏览社交媒体平台UGC相关评论以及结合图书馆读者服务中AI服务的使用现状,形成开放式非结构化问题框架。为提高研究的普适性,笔者首先随机选取5位接受过图书馆AI服务的用户进行预访谈,随后邀请2位信息资源管理领域专家对预访谈反馈结果进行分析,对初始问题框架进行优化与调整,形成更完善的访谈提纲。
研究采用目的性随机抽样,要求访谈对象涵盖不同类型的图书馆用户及图书馆工作人员,关注使用数据及智能工具、对AI在读者服务中应用情况有独到的见解及有一定使用频率的对象,还可以选取一些有图书馆数据管理以及AI技术应用领域研究背景的专家,以确保访谈的代表性及全面性。基于此,本研究共选取32位访谈对象通过线上线下访谈相结合的方式获取原始数据,线上访谈主要通过电话访谈以及微信文本交流,线下访谈主要是一对一访谈。样本基本信息见表1。在正式访谈开始之前,访谈者会向被访者提供访谈提纲,使其熟悉大概访谈内容,访谈内容基于原本访谈提纲,部分内容根据访谈实际情况进行更改调整,若涉及关键问题,可继续深度聚焦,进行深入访谈。访谈持续34天,每份独立访谈大约持续20分钟。在不违背受访对象意愿的前提下,对访谈过程进行录音,访谈结束待受访对象确认后,将录音内容转化为文本,共获得32份文本数据,随机选取其中25份进行编码分析,剩余7份进行理论饱和度检验。
表1 样本统计情况

Table 1 Overview of sample statistics

变量 分类 频数 频率/%
性别 男性 18 56.25
女性 14 43.75
职业 学生 9 28.13
高校教师 7 21.88
企业职员 7 21.88
公务员 1 3.13
图书馆员 8 25.00
专业 图书情报 10 31.25
教育学 4 12.50
机械工程 2 6.25
计算机 3 9.38
人工智能 4 12.50
汉语言文学 5 15.63
工商管理 4 12.50

5 数据分析/Data analysis

5.1 数据编码与分析

5.1.1 开放式编码

开放式编码是扎根理论的初始阶段,研究者通过对原始数据进行逐字逐句的分析,在不改变其语义的情况下,将其分解、凝练为较抽象的基本概念或范畴。在此过程中,研究者需保持开放的态度,避免预设理论框架,以确保理论构建的“扎根性”和科学性。例如,有受访者指出,“技术基础设施决定了数据的获取、存储和分析能力。良好的数字资源管理系统有助于快速整理馆藏资源和用户行为数据,AI的接入可以减少人力成本,让AI代替人类进行一些繁杂性事务,优化资源管理,提升服务效率。”根据原始文本编码可以提取出服务效率、资源管理、成本、功能等初始概念,后续结合研究主题,根据相关概念经过解释性编码形成功能价值和技术设施等与研究更加相关的、具备解释性的独立范畴。原始文本经过开放式编码共得到17个初始范畴,但部分范畴因其与研究主题相关度不高、出现频次不高等原因,经过数据清洗后剔除,剔除后得到15个初始范畴。

5.1.2 主轴编码

主轴编码是在开放式编码的基础上,进一步整合和关联已识别的范畴,构建出更具结构性和逻辑性的主范畴。研究者通过识别初始范畴与研究主题之间的依存关系,结合相关理论基础,形成初步的理论范畴。例如,功能价值、社会价值、情感价值以及认知价值从不同角度体现了AI对读者服务的赋能价值,因此可以将其归为价值体现主范畴。由此类推,可以将15个初始范畴凝练为数据管理、数据利用、数据环境、成本感知、数据流通以及价值体现6个主范畴,如表2所示:
表2 开放式编码和主轴编码分析结果(部分)

Table 2 Analytical results of open coding and axial coding(partial)

原始语句(示例) 初始范畴 主范畴 维度
“图书馆藏有大量书籍资料,其中还不乏存在某些珍贵的馆藏书物,这些书物可能不适合被借阅,只能在馆内使用。图书馆数智化转型升级使得这些纸质藏书以数据的方式储存在服务器中,通过电子借阅的方式出现在大家的视野。” 数据存储(A1) 数据管理(B1) 数据本体(C1)
“我觉得图书馆的更新速度很慢,有些新书我等到了一段时间才看到,我希望图书馆能及时更新其馆藏数据,以更好地反映最新的研究动态。” 数据更新(A2)
“图书馆的AI推荐书籍有时和我的需求不符,有时用处不大,比如上次我试着用图书馆的在线推荐系统,结果推荐的书籍大部分都是我已经看过的,期望能改进。” 数据质量(A3)
“数据分析能帮助我们厘清用户需求,进而调整服务方向。” 数据分析(A4) 数据利用(B2)
“听说一些图书馆在数据共享方面做得不错,这也许能促成更好的资源利用。” 数据共享(A5)
“作为读者,我更希望我的数据隐私能得到保护,尤其是借阅记录。” 数据安全(A6) 数据环境(B3) 数据环境(C2)
“我比较关注图书馆能被查到的各类书籍借阅数据、座位使用等数据是否完善,这些数据信息的透明工作决定着我继续使用相关服务的体验感。” 数据透明度(A7)
“图书馆的技术基础设施让我能在任何时间使用在线资源,非常便利。” 技术设施(A8)
“使用AI系统时,人们会担心个人信息被滥用,所以,AI服务应该存在一定的技术手段对其服务接收方的隐私数据进行监管。” 感知成本(A9) 成本感知(B4) 数据主体(C3)
“我曾通过图书馆AI推荐系统找到相关主题的书籍,它能够节约我的思考时间,通过我的描述在它的数据库中查找相关书籍,然后输出给我。” 数据获取(A10) 数据流通(B5)
“我们的信息系统能自动追踪我的借阅记录,方便我继续阅读。” 数据追踪(A11)
“如今图书馆提供的服务让我觉得很方便,特别是在AI服务上体现得很到位,我不仅可以使用搜索功能查阅相关资料,还可以根据AI智能导航在大型图书馆中轻松找到图书具体位置,这大大提高了我的工作效率。” 功能价值(A12) 价值体现(B6)
“图书馆数据技术的智能化转型升级,能让图书馆更好地提高服务效率以及馆藏资源的利用率,这种转型不仅促进了信息资源的合理配置,还提高了图书馆作为公共资源的社会效益。” 社会价值(A13)
“使用AI系统进行图书查找以及进行参考咨询服务时的回应速度和效果比之前传统服务台咨询要好,这增强了我的使用意愿。” 情感价值(A14)
“图书馆利用AI技术提供个性化服务,其快速响应能力以及较缜密的思考能力能满足我特定的咨询需求。” 认知价值(A15)

5.1.3 选择性编码

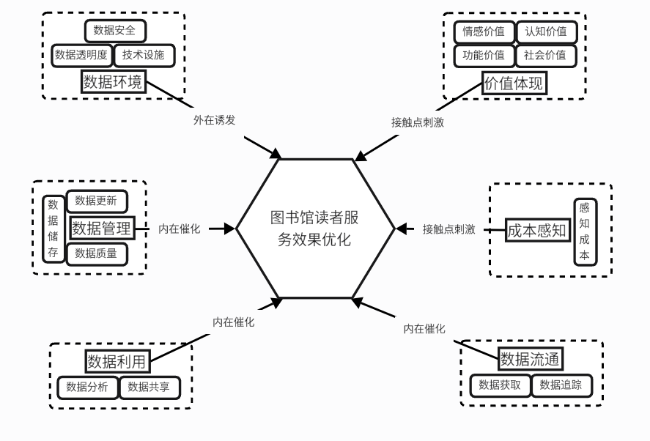
选择性编码是扎根理论的深化阶段,将已构建的初始范畴及主范畴和研究主题相关联,形成一个统一的、能够解释研究现象的理论体系,这一阶段强调理论的聚焦性和解释力。本研究将AI赋能的图书馆读者服务效果优化定位为核心范畴,形成的研究路径框架见图2。数据环境范畴通过外部技术、法规和社会压力驱动图书馆读者服务效果优化,可将其视为外在诱发因素;价值体现和成本感知对图书馆读者服务效果的影响属于接触点刺激,是用户与服务交互时直接感知的节点,即用户在与服务接触过程中产生的即时体验与决策因素;而数据管理、数据利用及数据流通需通过数据系统内部资源整合与流程优化实现图书馆读者服务效果优化,属于内在催化。
图2 AI赋能图书馆读者服务效果优化框架

Figure 2 A framework for optimizing library user services empowered by AI

5.1.4 理论饱和度检验

在质性研究领域,理论饱和度检验是确保数据收集的完整性和可靠性、研究结论稳健性的关键步骤。其核心在于当继续编码或新增数据不再对理论框架产生新的见解或修正时,即达到理论饱和,此时研究者可认为理论已具备充分的解释力。本研究运用这一原则,将事先预留的7份访谈资料作为检验样本,采用研究确立的编码框架和分类体系对预留的7份访谈语料进行深入剖析,通过一一比对,并未发现这些新引入的数据在检验过程中产生了原先未识别的主体、概念或是范畴。因此,可以合理推断本研究构建的数据要素视角下AI赋能图书馆读者服务效果优化路径模型有效捕捉了受访者的真实情感,具备一定的解释力。

5.2 模糊ISM-MICMAC模型构建

5.2.1 构建邻接矩阵和可达矩阵

为了提高研究的合理性,根据已有研究,将编码分析的15个范畴要素反馈给部分受访对象,听取受访者对于15个初始范畴要素间相关性的反馈意见,随后记录受访者的反馈意见并进行讨论。结合受访者的反馈意见,对范畴之间的影响程度进行评分,评分标准按照影响程度将分值设定在区间[0,1],将间距设定为0.25,据此划分5级量表,并据此构建模糊邻接矩阵N,并将阈值设定为0.5,如表3所示:
表3 影响程度评分标准

Table 3 Impact rating criteria

影响

程度

无影响

影响

较低

一般

影响

较大

影响

很大

分值 0 0.25 0.5 0.75 1
根据公式 s i j = n i j n i + n j - n i j计算强关联矩阵S,sij表示矩阵S中第i行第j列元素的值;nij表示矩阵N中第i行第j列元素的值;ni表示矩阵N第i行元素值之和;nj表示矩阵N第j列元素值之和。矩阵中要素sij若大于或等于阈值0.5则在邻接矩阵中记为1,反之则记为0。根据结果建立15个范畴要素(A1-A15)的邻接矩阵A,见表4。邻接矩阵反映了各要素间的直接影响关系,若要素大于或等于0.5则有直接影响,反之则无,即行要素Ai对列要素Aj有直接影响关系则在矩阵中记为1,行要素Ai对列要素Aj没有直接影响关系则在矩阵中记为0。
表4 邻接矩阵A

Table 4 Adjacency matrix A

要素 A1 A2 A3 A4 A5 A6 A7 A8 A9 A10 A11 A12 A13 A14 A15
A1 0 1 0 0 0 0 0 0 0 1 1 0 0 0 0
A2 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0
A3 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0
A4 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0
A5 0 0 0 0 0 1 0 0 0 0 0 0 1 0 0
A6 0 0 0 0 1 0 0 0 1 0 0 0 1 0 0
A7 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0
A8 0 1 0 1 1 0 1 0 0 0 0 0 0 0 0
A9 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
A10 0 0 1 0 0 0 0 0 0 0 0 0 0 0 0
A11 0 0 0 0 0 0 0 0 0 0 0 1 0 0 0
A12 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1
A13 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
A14 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
A15 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
为了更好地展示各范畴要素间的内在逻辑关系,不仅需要构建邻接矩阵反映各要素间的直接影响关系,还应构建可达矩阵,建立各要素间的间接影响关系。AI赋能图书馆读者服务效果优化可达矩阵M不仅可以描述各要素间的直接关联,还能描述要素间的间接联系及要素间的传递性,其通过邻接矩阵A加上单位矩阵I根据布尔逻辑运算公式得出。当满足(A+I)K-1≠(A+I)K=(A+I)K+1时,即可得到可达矩阵M=(A+I)K,如表5所示,其中K代表迭代次数。
表5 可达矩阵M

Table 5 Reachability matrix M

要素 A1 A2 A3 A4 A5 A6 A7 A8 A9 A10 A11 A12 A13 A14 A15
A1 1 1 1 0 0 0 0 0 0 1 1 1 1 1 1
A2 0 1 1 0 0 0 0 0 0 0 0 1 1 1 1
A3 0 0 1 0 0 0 0 0 0 0 0 1 1 1 1
A4 0 0 1 1 0 0 0 0 0 0 0 1 1 1 1
A5 0 0 0 0 1 1 0 0 1 0 0 0 1 0 0
A6 0 0 0 0 1 1 0 0 1 0 0 0 1 0 0
A7 0 0 1 0 0 0 1 0 0 0 0 1 1 1 1
A8 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1
A9 0 0 0 0 0 0 0 0 1 0 0 0 0 0 0
A10 0 0 1 0 0 0 0 0 0 1 0 1 1 1 1
A11 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1
A12 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1
A13 0 0 0 0 0 0 0 0 0 0 0 0 1 0 0
A14 0 0 0 0 0 0 0 0 0 0 0 0 0 1 0
A15 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1

5.2.2 影响因素层级划分

构建可达矩阵M后,需对上述要素进行层级划分,这有助于理清各要素之间的关系从而形成解释结构模型。层级解构主要由以下步骤构成:①确定各要素的可达集,指可达矩阵各要素行矩阵元素为1的各列要素的集合;②确定各要素的先行集,指可达矩阵各要素列矩阵元素为1的各列要素的集合;③确定交集,即可达集与先行集共有的元素集合;④层级抽取,可达集与交集相同的元素记为第一层,将第一层元素剔除之后继续满足上述要求时,确定为第二层因素集,以此类推,直到确定最后一层因素集。见表6。
表6 变量层级迭代

Table 6 Variable level iteration

要素 可达集 先行集 交集 层级
A1 A1、A2、A3、A10、A11、A12、A13、A14、A15 A1 A1 5
A2 A2、A3、A12、A13、A14、A15 A1、A2、A8 A2 4
A3 A3、A12、A13、A14、A15 A1、A2、A3、A4、A7、A8、A10 A3 3
A4 A3、A4、A12、A13、A14、A15 A4、A8 A4 4
A5 A5、A6、A9、A13 A5、A6、A8 A5、A6 2
A6 A5、A6、A9、A13 A5、A6、A8 A5、A6 2
A7 A3、A7、A12、A13、A14、A15 A7、A8 A7 4
A8 A2、A3、A4、A5、A6、A7、A8、A9、A12、A13、A14、A15 A8 A8 5
A9 A9 A5、A6、A8、A9 A9 1
A10 A3、A10、A12、A13、A14、A15 A1、A10 A10 4
A11 A11、A12、A13、A14、A15 A1、A11 A11 3
A12 A12、A13、A14、A15 A1、A2、A3、A4、A7、A8、A10、A11、A12 A12 2
A13 A13 A1、A2、A3、A4、A5、A6、A7、A8、A10、A11、A12、A13 A13 1
A14 A14 A1、A2、A3、A4、A7、A8、A10、A11、A12、A14 A14 1
A15 A15 A1、A2、A3、A4、A7、A8、A10、A11、A12、A15 A15 1

5.2.3 构建解释结构模型

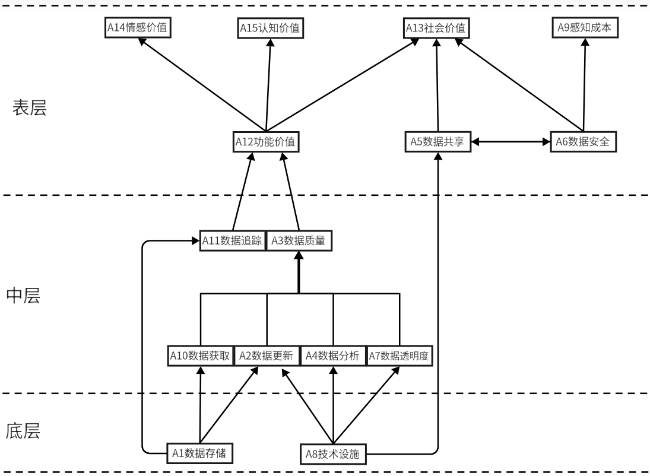
根据表6所示的变量层级关系以及变量间的相互影响关系构建数据要素视角下AI赋能图书馆读者服务效果优化模型(见图3),该模型包括底层(层级1)、中层(层级2—3)、表层(层级4—5)3个层级,其具体影响关系如下:表层的影响因素包括价值体现(A14情感价值、A15认知价值、A13社会价值、A12功能价值)、数据利用(A5数据共享)、数据环境(A6数据安全)和成本感知(A9感知成本),这些要素都是直接影响要素,AI赋能图书馆读者服务效果优化最直接的体现是用户使用AI前后感受的对比,包括功能有用性、情感认知等方面价值的体现以及使用AI时感受到的成本付出,这直接影响到用户使用的满意度以及是否持续使用该服务,而用户使用较为关注的则是AI使用过程中个人数据是否安全,以及数据是否可以跨时跨域共享。中层的影响因素包括数据管理(A2数据更新、A3数据质量)、数据流通(A10数据获取、A11数据追踪)、数据利用(A4数据分析)及数据环境(A7数据透明度),这些因素是间接影响因素,其主要起到承接作用,其对表层因素的影响需要通过底层和中层部分因素的参与。数据能否及时获取和及时更新、数据分析是否精准、数据是否透明直接影响数据质量的高低,而AI使用过程中自己的数据,诸如借阅数据是否可被追踪,以及AI输出的建议质量的高低直接影响用户对AI技术功能的接受程度。底层的影响因素包括数据管理(A1数据存储)和数据环境(A8技术设施),底层因素是路径产生的根源与基础,AI通过数据库存储数据,从而可以对自己数据库中的内容进行提取并进行再加工,数据库数据存储容量是否充足以及技术设施的环境是否完备都直接影响中层因素。即数据存储的数字化形式需要依赖数据更新机制来保持资源的时效性,数字化存储为AI系统提供检索基础,直接影响数据获取效率。技术设施的环境为自动化更新流程提供支撑,算力资源决定数据分析的深度和效率,数据可视化工具支持透明度的实现。
图3 数据要素视角下AI赋能图书馆读者服务效果优化路径解释结构模型

Figure 3 Interpretative structure model of AI empowering library reader service effect optimization path from the perspective of data elements

5.2.4 MICMAC分析

交叉影响矩阵相乘法(MICMAC)主要用于分析各要素间的驱动力和依赖性。要素的驱动力可以通过计算可达矩阵中因素Ai所在行矩阵元素为1的个数总和,即驱动力Di=ΣAi;要素间依赖性可以通过可达矩阵中因素Ai所在列矩阵元素为1的个数总和计算,即依赖性Rj=ΣAj。驱动力越大说明该要素对其他要素的影响越大,依赖性越大说明该要素对其他要素的依附性越大。要素的驱动力及依赖性统计结果如表7所示:
表7 驱动力及依赖性数值统计

Table 7 Driving force and dependence numerical statistics

指标 A1 A2 A3 A4 A5 A6 A7 A8 A9 A10 A11 A12 A13 A14 A15
驱动力 9 6 5 6 4 4 6 12 1 6 5 4 1 1 1
依赖性 1 3 7 2 3 3 2 1 4 2 2 9 12 10 10
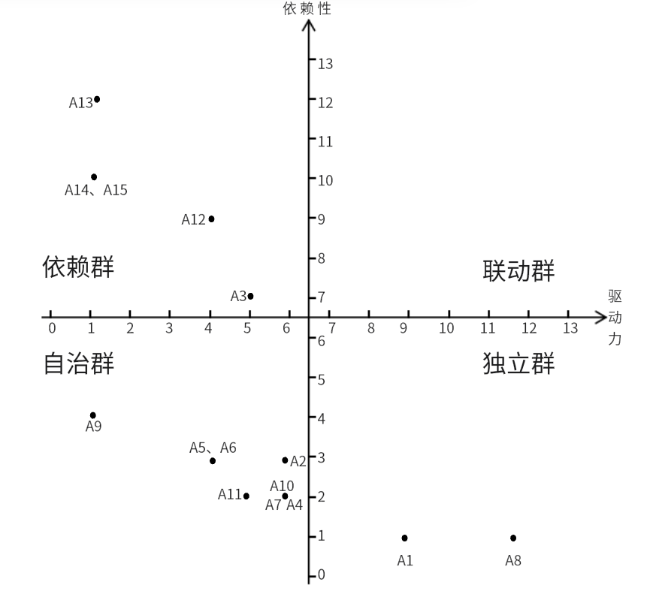
根据统计结果可以将要素分为联动群、独立群、自治群、依赖群,见图4。联动群的要素体现为高依赖性且高驱动力,该集群要素的变化极易对其他集群要素产生影响进而对自身产生影响,体现为极不稳定,本研究选取的要素皆不隶属于该区域,表明所选取要素较符合实际,也较为稳定;依赖群所在要素体现为高依赖性和低驱动性,易受其他要素影响,AI赋能图书馆读者服务的核心是以用户体验为导向的服务模式,故该区域要素主要与用户的感知价值有关,AI平台的功能性、用户的认知与情感导向是影响读者服务效果的直接影响要素,数据质量通过影响功能价值进而对用户体验产生影响,因而要解决该区域要素问题,需要更加深层次要素的协同作用;自治群要素主要包括A2、A4、A5、A6、A7、A9、A10、A11,该象限元素主要位于ISM模型的中层和表层,虽然其依赖性和关联性不高,但可以起到中介作用;独立群所在象限元素皆为位于ISM模型底层元素,其高驱动力低依赖性的特点不容易受到其他因素影响,因其属于模型最深层,其变化极易引起其他层要素变化。
图4 要素MICMAC分析象限分布

Figure 4 Factor MICMAC analysis quadrant distribution

6 讨论/Discussion

为了解数据要素视角下AI赋能图书馆读者服务效果优化路径间的逻辑关系,助力图书馆借助AI工具改进现有服务,实现图书馆数智化转型升级,提升读者和馆员体验感及获得感,笔者基于数据要素链理论、感知价值理论及信息生态理论,从数据要素视角出发进行扎根访谈,对访谈内容逐层编码,最终确定数据本体、数据环境和数据主体3个维度共15项影响因素。基于扎根编码结果建立解释结构模型,通过建立邻接矩阵及可达矩阵,通过分层处理将要素分为5个层级,并根据结构将其划分为表层、中层、底层3个层次。最后通过MICMAC分析,进一步对所构建的解释结构模型进行验证,并将影响因素分为依赖群、自治群和独立群。根据所得结果,笔者得出以下结论与建议:
(1)理论意义。数据作为新的生产要素,对生产生活有着巨大影响,而图书馆作为知识服务的重要场景,数据要素在该领域的作用愈发凸显。图书馆通过引入AI技术,可以实现对海量数据的高效处理与深度挖掘,从而通过可能的路径对读者服务效果进行优化。而且已有关于AI赋能图书馆的相关研究大多从理论层面出发解构AI的发展对图书馆建设的影响以及对未来的展望,少有研究从实践层面具体探讨如何通过AI技术提升图书馆服务质量和用户体验。部分学者开始利用扎根理论对人工智能赋能智慧图书馆作用机制进行实证研究,但是服务效果优化更深层的路径研究仍较为缺乏。本研究从数据的角度出发将数据价值链理论应用于图书馆智慧服务效果优化分析,扩展了图书馆服务优化的理论研究领域。
(2)实践启示。根据研究结果可知,在数据本体中,数据管理位于解释结构模型的中层和底层,数据利用位于中层和表层;数据环境中的各要素遍布模型的表层、中层、底层;在数据主体中成本感知位于表层,数据流通位于中层,价值体现位于表层。ISM中的底层因素全部位于独立群,对上层元素影响较大,主要起驱动作用;自治群元素起过渡作用,主要由模型中表层元素构成;依赖群由中表层因素构成,其易被其他元素影响。由此,研究结合ISM模型中各要素间关系以及MICMAC分析,从数据本体、数据环境、数据主体3个维度得出实证启示。
从数据本体出发,应当严格关注底层要素,强化底层要素与中表层要素的协同作用。主要体现为确保数据内部储存的稳固性,将其与更新机制联动,例如通过区块链技术的去中心化、公开账本以及不可篡改实现数据管理、区块链管理、系统管理功能,以求形成生态链联盟,促进信息自由流通。提高数据更新频率和数据分析能力以提升数据质量,数据质量的提升直接关系到用户体验的改善。因此,图书馆需注重数据的采集、管理和分析,确保数据的准确性与实时性。积极搭建高效的数据处理平台,实现数据开放共享,建设高质量数据集,发挥数据要素乘数作用,以高质量数据促进图书馆人工智能的发展。
从数据环境出发,应维护数据生态的良性循环,优化网络基础设施,保障数据传输的稳定性和安全性。同时,加强与其他机构的合作,拓宽数据共享渠道,提升数据资源的多样性和丰富性,为用户提供更加全面和精准的知识服务。在此基础上注重数据透明度和可访问性,可通过公示数据来源与处理规则,建立可用信息公示专栏,增强用户信任,确保用户能够便捷地获取所需信息。在数据开放共享的基础上,保障数据安全合规操作,建立数据安全管理体系,严格执行数据隐私保护政策,在数据采集和分析环节采用联邦学习和差分隐私技术,防止数据泄露,实现数据服务能力在服务器端的持续正向积累,以增强资源受限的终端设备和拥有大模型的服务器两端模型的整体能力,从而实现一种“数据、模型不动,服务动”的效果。
从数据主体出发,既要关注用户的成本感知又要让数据得到有效获取,通过定期安全培训和风险评估,提升馆员及读者数据安全意识,确保数据在开放共享中安全可控,从而使得系统的功能价值、社会价值、情感价值、认知价值得到充分释放。在此基础上,通过对用户查询数据的追踪与分析提供个性化服务以满足用户个性化需求,从而实现AI平台功能性与智能化水平的提升,以及用户数据素养的提升。最终,通过数据要素的深度整合与应用,构建“数据—服务—效益”评估体系,量化AI服务对资源利用率、用户留存率的提升效果,并将结果纳入图书馆年度报告,促进人工智能与数据要素双向赋能,为图书馆实现服务模式的创新、促进读者服务效果的全面提升提供参考。

7 结语/Conclusion

笔者从数据要素的视角出发,通过扎根理论,结合解释结构模型和交叉影响矩阵相乘法对AI赋能图书馆读者服务效果路径进行分析,揭示了数据驱动下的服务创新路径。研究结果对图书馆持续推进技术与管理的双重革新,通过智能推荐、个性化阅读引导等服务模式,进一步提升用户参与度和满意度,并为管理决策提供参考价值。本文不足之处体现在未对各影响因素之间的作用强度做量化分析,未来可以对各影响要素进行赋权,建立要素评价指标体系。

Author(s): Zou Kai, Professor, PhD, Doctoral Supervisor;Tan Xinyu, Master’s Candidate, Corresponding Author, E-mail:2679006964@qq.com; Fu Liyun, Deputy Director of Technology Transfer Center, Associate Research Librarian, Master’s Degree, Master’s Supervisor; Jiang Zhiyi, Research Librarian, Master’s Degree, Master’s Supervisor.

邹 凯:论文指导及修改;

谭欣宇:论文撰写及修改;

傅立云:论文指导及修改;

蒋知义:论文指导及修改。

[1]
中国政府网. “数据二十条”对外发布,构建数据基础制度体系——做强做优做大数字经济[EB/OL]. [2025-09-04].

Chinese Government Website. "Data 20" released to the public, build a data base system, and stronger optimal do big digital economy[EB/OL]. [2025-09-04].

[2]
中国政府网. 《“数据要素×”三年行动计划(2024—2026年)》发布[EB/OL]. [2025-09-04].

Chinese Government Net. "Action plan for "data elements ×" for three years (2024-2026) "released[EB/OL]. [2025-09-04].

[3]
中国政府网. 中共中央关于进一步全面深化改革、推进中国式现代化的决定[EB/OL]. [2025-09-04].

The Chinese Government Net. The central committee of the communist party of China on further comprehensively deepen reform of Chinese modernization decided[EB/OL]. [2025-09-04].

[4]
韩茹雪, 饶梓欣, 许鑫. AIGC赋能的GLAM机构内容生产研究[J]. 图书情报工作, 2024, 68(22): 4-15.

HAN R X, RAO Z X, XU X.A study of content production in GLAM empowered by AIGC[J]. Library and information service, 2024, 68(22): 4-15.

[5]
国家新闻出版署. 第二十一次全国国民阅读调查成果发布[EB/OL]. [2025-09-04].

National Press and Publication Administration.21 times national national reading survey results published[EB/OL]. [2025-09-04].

[6]
汪聪, 张春红, 高楠, 等. 面向人工智能生成内容时代的图书馆服务适应与创新[J]. 情报理论与实践, 2024, 47(7): 17-24.

WANG C, ZHANG C H, GAO N, et al. Adaptation and innovation of library services in the AIGC era[J]. Information studies: theory & application, 2024, 47(7): 17-24.

[7]
初景利, 段美珍. 智慧图书馆与智慧服务[J]. 图书馆建设, 2018(4): 85-90, 95.

CHU J L, DUAN M Z. Smart library and smart services[J]. Library development, 2018(4): 85-90, 95.

[8]
American Library Association. Libraries and adult education: a study made by the American Library Association[M]. New York: Macmillan company, 1926: 27-28.

[9]
苑艺. 20世纪20至40年代美国公共图书馆阅读指导服务研究[D]. 保定: 河北大学, 2020.

YUAN Y.A study on the readers’ advisory service of American public libraries,1920s—1940s[D]. Baoding: Hebei University, 2020.

[10]
LAURA S. Future of librarians interview[EB/OL]. [2025-07-11]. 2014-02-08/2025-07-11.

[11]
陈臣. 基于小数据决策支持的图书馆读者个性化服务定制与动态推送系统研究[J]. 图书馆理论与实践, 2022(2): 79-84.

CHEN C. Research on reader personalized service customization and dynamic push system for library based on small data decision support[J]. Library theory and practice, 2022(2): 79-84.

[12]
郭亚军, 寇旭颍, 冯思倩, 等. 大语言模型赋能图书馆参考咨询服务:逻辑、场景与体系[J]. 图书馆论坛, 2025, 45(1): 118-127.

GUO Y J, KOU X Y, FENG S Q, et al. Large Language model empowers library reference services: logic, scenarios, and framework[J]. Library tribune, 2025, 45(1): 118-127.

[13]
陈丽冰. 智慧图书馆: 价值内涵、主要困境与优化路径[J]. 图书馆, 2023(2): 19-25.

CHEN L B. Smart library: value connotation, main dilemma and optimization path[J]. Library, 2023(2): 19-25.

[14]
CAO G, LIANG M, LI X. How to make the library smart?the conceptualization of the smart library[J]. The electronic library, 2018, 36(5): 811-825.

[15]
张磊. ChatGPT应用视角下的公共图书馆智慧服务:机遇、挑战与对策[J]. 图书馆工作与研究, 2024(S1): 30-35.

ZHANG L. Public libraries smart services from the perspective of ChatGPT application: opportunities, challenges and countermeasures[J]. Library work and study, 2024(S1): 30-35.

[16]
郎书林, 李仪, 叶韵怡. 智慧服务背景下高校图书馆读者数据的安全风险及协同治理对策研究[J]. 图书馆, 2024(11): 44-52.

LANG S L, LI Y, YE Y Y. Research on the security risks and collaborative management countermeasures of readers' data of university libraries under the background of smart service[J]. Library, 2024(11): 44-52.

[17]
COX C, TZOC E. ChatGPT: implications for academic libraries[J]. College & research libraries news, 2023, 84(3): 99.

[18]
余望枝, 刘芳.基于智能问答的图书馆参考咨询服务设计及优化[J]. 图书馆理论与实践, 2024(1): 128-136.

YU W Z, LIU F. Design and optimization of library reference service based on intelligent question and answer system[J]. Library theory and practice, 2024(1): 128-136.

[19]
罗雪英. 高校图书馆阅读推广人素养调查与培育策略——基于对湖南省15家高校图书馆的调研[J]. 图书馆工作与研究, 2024, (10): 75-84.

LUO X Y. Literacy survey and cultivation strategies of reading promoters in university libraries——based on research of 15 university libraries in Hunan Province[J]. Library work and study, 2024, (10): 75-84.

[20]
王学琴, 李爱国.加强用户关系管理,提升图书馆服务质量——以东南大学图书馆为例[J]. 大学图书馆学报, 2024, 42(1): 17-22, 39.

WANG X Q, LI A G. Strengthening user relationship management to enhance library service quality——taking southeast university library as an example[J]. Journal of academic libraries, 2024, 42(1): 17-22, 39.

[21]
祁宁, 刘笑含.我国公共图书馆适老化服务体系:演进历程、实践现状与发展路径[J]. 图书馆, 2024(10): 17-15, 109.

QI N, LIU X H. Elderly-oriented service system of public libraries in China: evolution process, practice status and development path[J]. Library, 2024(10): 17-15, 109.

[22]
盛瑞蓬.全民阅读背景下公共图书馆弱势群体阅读服务策略——以天津图书馆视障读者阅读服务为例[J]. 图书馆工作与研究, 2024(S1): 83-87.

SHENG R P. Strategies of reading services for vulnerable groups in public libraries under the background of national reading: taking the reading service for visually impaired readers in Tianjin Library as an example[J]. Library work and study, 2024(S1): 83-87.

[23]
孔令芳, 张雅彬, 林如诗, 等.数智时代高校图书馆全链路、一站式图书荐购服务平台的设计与应用研究[J]. 大学图书馆学报, 2024, 42(1): 65-71.

KONG L F, ZHANG Y B, LIN R S, et al. Design and practical research of a full link and one-stop book recommendation service platform for university libraries in the digital intelligence era[J]. Journal of academic libraries, 2024, 42(1): 65-71.

[24]
PIERRE R P.# SuperLibrarian—the evolving role of librarians in technology spaces[J]. Digital library perspectives, 2023, 39(4): 620-627.

[25]
马费成, 吴逸姝, 卢慧质.数据要素价值实现路径研究[J]. 信息资源管理学报, 2023, 13(2): 4-11.

MA F C, WU Y S, LU H Z. Research on the path to realize the value of data elements[J]. Journal of information resources management, 2023, 13(2): 4-11.

[26]
孙倬, 李嘉欣, 曹玲静, 等.政策信息学视角下数据要素政策演变逻辑及发展趋向研究[J]. 情报理论与实践, 2025, 48(9): 89-99, 167.

SUN Z, LI J X, CAO L J, et al. Analyzing the policy dynamics and emerging directions of data factor governance through the lens of policy informatics[J]. Information studies: theory & application, 2025, 48(9): 89-99, 167.

[27]
周明生, 周珺.我国数据要素研究的热点与演进趋势[J]. 河南大学学报(社会科学版), 2023, 63(4): 13-19, 152.

ZHOU M S, ZHOU J. Hotspots and evolution trend of data elements research in China[J]. Journal of Henan University(social sciences), 2023, 63(4): 13-19, 152.

[28]
吕梦, 赵丽芳, 钟英才.数据资产入表的价值效应与经济后果初探[J]. 管理评论, 2024, 36(12): 47-59.

LYU M, ZHAO L F, ZHONG Y C.A Preliminary study on the value effect and economic consequence of incorporating dataassets into the balance sheet[J]. Management review, 2024, 36(12): 47-59.

[29]
王雪, 夏义堃, 裴雷.国内外数据要素市场研究进展: 系统性文献综述[J]. 图书情报知识, 2023, 40(6): 117-128.

WANG X, XIA Y K, PEI L. Research progress in data element markets at home and abroad: a systematic literature review[J]. Documentation, information & knowledge, 2023, 40(6): 117-128.

[30]
奉国和, 肖雅婧.数据要素价值释放研究进展[J]. 图书馆论坛, 2024, 44(8): 123-132.

FENG G H, XIAO Y J. Research progress in unlocking the value of data elements[J]. Library tribune, 2024, 44(8): 123-132.

[31]
Agarwal A, Dahleh A M, Sarkar T.A Marketplace for Data: An Algorithmic Solution[J]. CoRR, 2018, abs/1805.08125.

[32]
LIU K, QIU X Y, CHEN W H, et al. Optimal pricing mechanism for data market in blockchain-enhanced internet of things[J]. IEEE internet of things journal, 2019, 6(6): 9748-9761.

[33]
黄益平, 沈艳.数据要素市场化配置多点发力[J]. 经济, 2022(2): 74-77.

HUANG Y P, SHEN Y. Multi point force of data element marketization[J]. Economy, 2022(2): 74-77.

[34]
代佳欣.基于过程的政府数据开放风险识别与防控策略研究[J]. 情报杂志, 2019, 38(6): 145-151.

DAI J X. Analytical framework of the identification and prevention of potential risks in open government data: a process-based research[J]. Journal of intelligence, 2019, 38(6): 145-151.

[35]
OTTO B, TEN H M, WROBEL S. Designing data spaces: the ecosystem approach to competitive advantage[M]. Switzerland: Springer Nature, 2022: 112-114.

[36]
夏义堃, 程铄, 王雪, 等.数据空间建设的实践进展与运营模式分析——基于Data Spaces Radar的案例[J]. 图书与情报, 2024(2): 18-32.

XIA Y K, CHENG S, WANG X, et al. Research on practical progress and operation mode of data spaces: based on cases of data spaces radar[J]. Library & information, 2024(2): 18-32.

[37]
SUSAN R. The data trust model proposes individuals can control their data for profit[J]. Journal of data protection & privacy, 2021, 4(2): 114123.

[38]
梁泳梅.人工智能发展前沿与就业[J]. 北京工业大学学报(社会科学版), 2025, 25(3): 7-12.

LIANG Y M. Artificial intelligence development frontier and employment[J]. Journal of Beijing University of Technology(social sciences edition), 2025, 25(3): 7-12.

[39]
张洋, 黄楠, 余厚强.AIGC时代信息资源管理领域发展趋势[J]. 图书馆论坛, 2024, 44(7): 1-8.

ZHANG Y, HUANG N, YU H Q. Trends in the development of information resource management in the AIGC era[J]. Library tribune, 2024, 44(7): 1-8.

[40]
徐伟, 韦红梅.生成式人工智能训练数据风险治理:欧盟经验及其启示[J]. 现代情报, 2025, 45(5): 89-98.

XU W, WEI H M. Generative artificial intelligence training data risk governance: EU experience and enlightenment[J]. Journal of modern information, 2025, 45(5): 89-98.

[41]
前瞻产业研究院.2024年中国人工智能行业全景图谱[EB/OL]. [2025-07-08].

Forward looking Industry Research Institute. Panorama of China's AI industry in 2024[EB/OL]. [2025-07-08].

[42]
胡裕岭, 姚浩亮.我国GAI数据治理的多元协同模式研究——新加坡治理经验的启示[J]. 河海大学学报(哲学社会科学版), 2024, 26(5): 86-98.

HU Y L, YAO H L. Construction of a multi-synergy mode for GAI data governance in China: inspiration from Singapore’s governance experience[J]. Journal of Hohai University(philosophy and social sciences), 2024, 26(5): 86-98.

[43]
刘亚丽.高校图书馆人工智能素养培育发展策略——基于对42家“双一流”大学图书馆的调查[J]. 图书馆工作与研究, 2025(4): 103-112.

LIU Y L. Strategies for the cultivation and development of artificial intelligence literacy in university libraries: based on the survey of 42 "double first class" university libraries[J]. Library Work and Study, 2025(4): 103-112.

[44]
汤倩雯, 殷子涵, 张浩.生成式人工智能背景下大学生数字素养培育目标与实施策略[J]. 图书馆工作与研究, 2025(4): 95-102.

TANG Q W, YIN Z H, ZHANG H. College students' digital literacy training objectives and implementation strategies under the background of generative artificial intelligence[J]. Library work and study, 2025(4): 95-102.

[45]
王曦.人工智能赋能智慧图书馆发展的作用机制[J]. 图书情报知识, 2024, 41(6): 94-101, 165.

WANG X. The mechanism of artificial intelligence enabling the development of smart libraries[J]. Documentation, information & knowledge, 2024, 41(6): 94-101, 165.

[46]
李冠, 孙灵芝, 何明祥.生成式人工智能话题下公众认知的“关注度—满意度”量化分析——以微博平台为例[J]. 数字图书馆论坛, 2024, 20(10): 9-21.

LI G, SUN L Z, HE M X. Quantitative analysis of “attention-satisfaction” in public cognition under generative artificial intelligence: taking Weibo platform as an example[J]. Digital library forum, 2024, 20(10): 9-21.

[47]
HUANG S B, CAI Y, YUAN L, et al. A knowledge-enhanced network for joint multimodal entity-relation extraction[J]. Information processing & management, 2024, 62(3): 104033.

[48]
刘亚丽, 范逢春.ChatGPT-AIGC用户风险感知维度识别与治理研究——基于扎根理论的探索性分析[J]. 情报理论与实践, 2024, 47(3): 121-129.

LIU Y L, FAN F C. ChatGPT-AIGC users risk perception dimension identification and management research: an exploratory analysis based on grounded theory[J]. Information studies: theory & application, 2024, 47(3): 121-129.

[49]
章洁, 洪芳林.迈向有序AI:智慧图书馆AIGC数据治理机制与策略[J]. 图书馆建设, 2025(2): 119-131.

ZHANG J, HONG F L. Moving towards orderly AI: research on AIGC data governance mechanisms and strategies for smart libraries[J]. Library development, 2025(2): 119-131.

[50]
张春春, 孙瑞英.如何走出AIGC的“科林格里奇困境”:全流程动态数据合规治理[J]. 图书情报知识, 2024, 41(2): 39-49, 66.

ZHANG C C, SUN R Y. How to get out of AIGC's "Collingridge Dilemma": full process dynamic data compliance governance[J]. Documentation, information & knowledge, 2024, 41(2): 39-49, 66.

[51]
刘晓迁, 许飞, 马卓, 等.联邦学习中的隐私保护技术研究[J]. 信息安全研究, 2024, 10(3): 194-201.

LIU X Q, XU F, MA Z, et al. Research on privacy protection technology in federated learning[J]. Journal of information security research, 2024, 10(3): 194-201.

[52]
李晓华, 王怡帆.数据价值链与价值创造机制研究[J]. 经济纵横, 2020(11): 54-62, 2.

LI X H, WANG Y F. Data value chain and the mechanism of value creation[J]. Economic review journal, 2020(11): 54-62, 2.

[53]
万震, 邹凯, 张艳丰, 等.基于ISM-MICMAC的移动社交媒体倦怠影响因素与关联路径研究[J]. 信息资源管理学报, 2022, 12(1): 46-55.

WAN Z, ZOU K, ZHANG Y F, et al. Research on influencing factors and associated path of mobile social media fatigue based on ISM-MICMAC[J]. Journal of information resources management, 2022, 12(1): 46-55.

[54]
顾洁, 刘玉博, 王振, 等.信息生态理论视角下城市数据要素市场就绪度评估[J]. 信息资源管理学报, 2024, 14(2): 82-94, 135.

GU J, LIU Y B, WANG Z, et al. Assessment of urban data element market readiness from the perspective of information ecology theory[J]. Journal of information resources management, 2024, 14(2): 82-94, 135.

[55]
肖雪, 邢畅, 申宁.感知价值对高校图书馆读书会用户满意度和持续参与意愿的影响研究[J]. 图书馆, 2023(7): 89-98.

XIAO X, XING C, SHEN N. Research on the influence of perceived value on the satisfaction and continuous participation intention of reading club users in university library[J]. Library, 2023(7): 89-98.

文章导航

/

〈 〉